




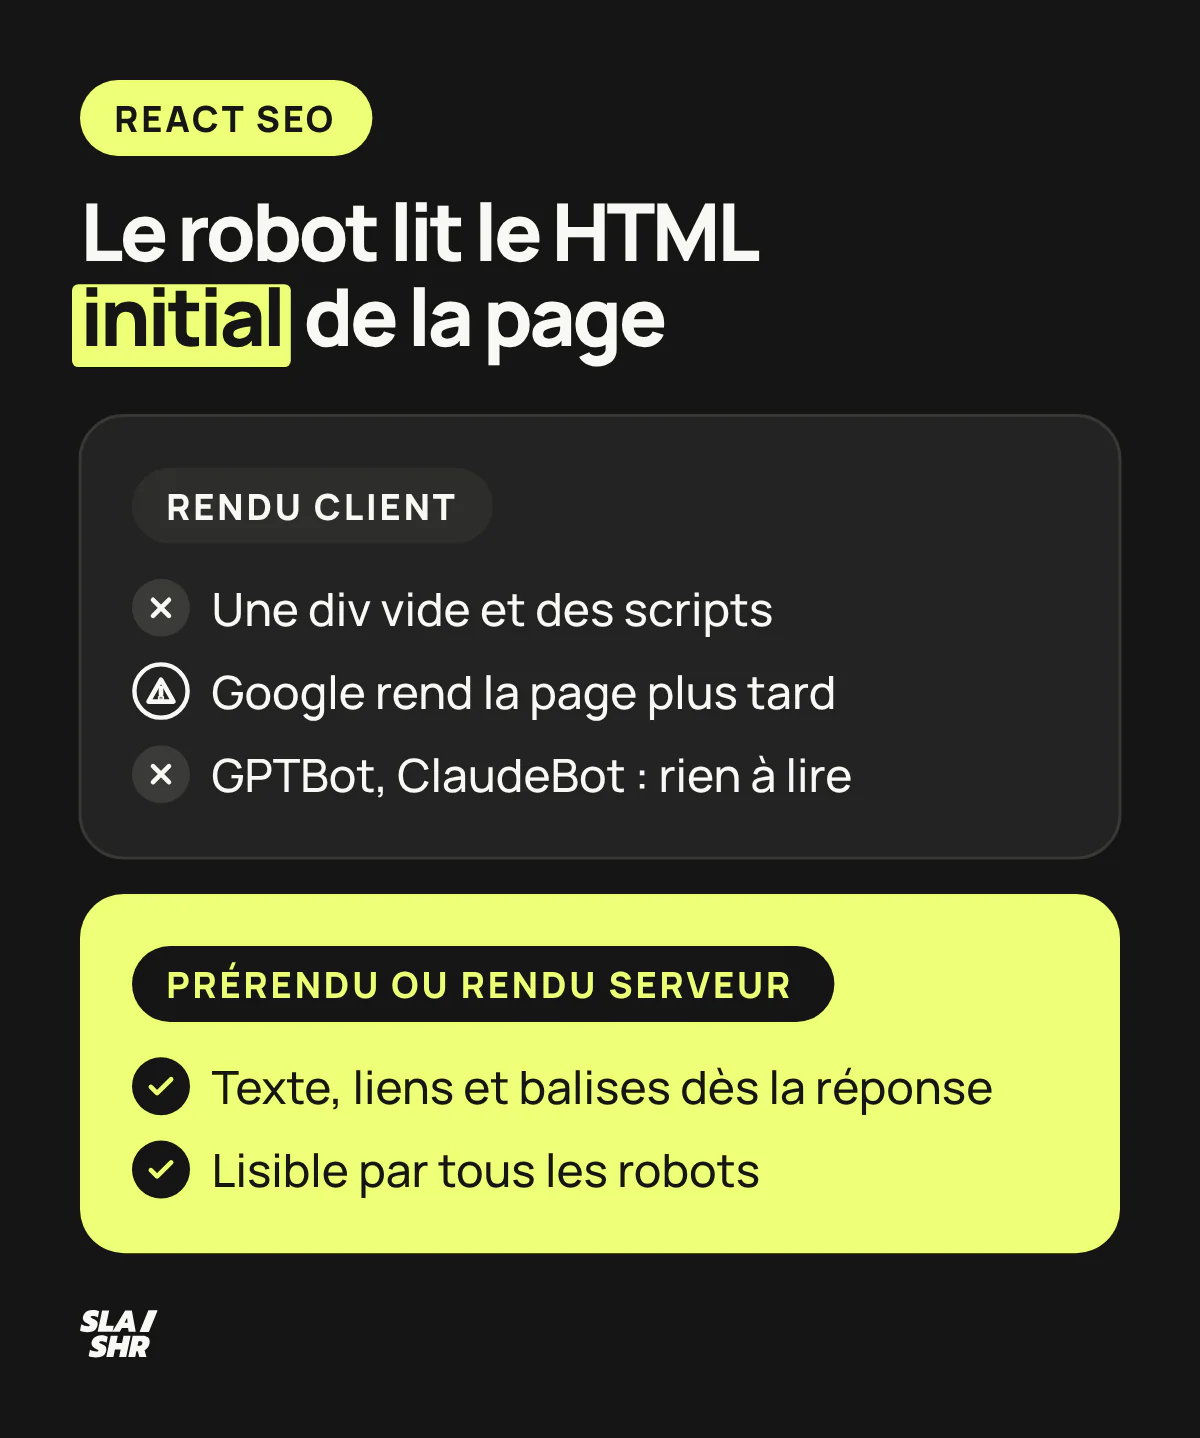
Un site React se référence bien quand le HTML reçu par le robot contient déjà le texte, les liens et les balises. Google exécute JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. en différé, d'autres robots ne l'exécutent pas. Le SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. React se joue donc sur le rendu choisi pour chaque page, puis sur des balises et des URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. propres.
Ce que Google et les robots d'IA voient d'une page React
Google lit d'abord le HTML renvoyé par le serveur, puis exécute le JavaScript plus tard, quand ses ressources le permettent. Sa documentation décrit trois phases : exploration, affichage, indexation. La première, le crawling, ne lit que la réponse HTML du serveur et les liens qu'elle contient. Entre les deux premières, la page attend dans une file, et Google précise qu'elle peut y rester quelques secondes ou plus longtemps.
Une application React en rendu client envoie ce que Google appelle un « shell d'application » : un HTML presque vide, une balise <div id="root"> et des scripts. Tant que le JavaScript n'a pas tourné, la page est vide. Pas de texte, pas de liens à suivre, pas de title propre à la page.
Google finit par rendre la page dans un Chromium headless et indexe le résultat. Il recommande quand même le rendu côté serveurTechnique générant le HTML sur le serveur, facilitant l'indexation du contenu JavaScript. ou le prérendu, parce que le site s'affiche plus vite pour les visiteurs comme pour les robots, et parce que tous les robots n'utilisent pas forcément JavaScript.
Ce dernier point pèse lourd avec les assistants IA. Dans l'étude publiée par Vercel et MERJ en décembre 2024, aucun des grands robots d'IA mesurés n'exécutait le JavaScript : GPTBot et OAI-SearchBot d'OpenAI, ClaudeBot d'Anthropic, PerplexityBot. Deux robots faisaient exception : GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche., qui s'appuie sur l'infrastructure de GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages., et AppleBot, qui rend les pages avec un robot de type navigateur. Pour être cité dans les réponses de Perplexity, le passage qui répond doit donc figurer dans le HTML servi.
Le constat date de fin 2024 et reste à revérifier. En attendant, un contenu absent du HTML initial n'existe pas pour ces robots, ni pour les réponses qu'ils alimentent.

Le test prend cinq minutes. Récupérez le HTML brut d'une page avec curl, sans navigateur :
curl -s httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.example.com/produits/chaise-chene | grep -iE "<title|<h1|canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire.|<a "
Si la commande ne renvoie ni le titre de la page, ni le H1, ni les liens, le contenu dépend du JavaScript. Mauvais signe pour une page qui doit ranker.
Ouvrez ensuite l'outil d'inspection d'URL de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche., lancez le test en ligne et cliquez sur « Afficher la page testée » : vous y trouvez le rendu DOM (le HTML après exécution du JavaScript), une capture d'écran et les erreurs de la console JavaScript. Pour contrôler tout le site d'un coup, un crawl en rendu JavaScript compare le nombre de mots avant et après exécution, page par page : le réglage est expliqué dans notre guide Screaming Frog.
L'écart entre les deux versions, c'est ce que Google doit rattraper et ce que les robots qui n'exécutent pas le JavaScript, comme GPTBot ou ClaudeBot dans l'étude de Vercel, ne verront pas. Faites-le sur trois gabarits au moins : accueil, catégorie, fiche.
Pour aller plus loin sur le traitement du JavaScript par Google en général, au-delà de React, les bonnes pratiques JavaScript et SEO détaillent les erreurs les plus fréquentes.
Quel rendu pour quelle page ? La grille de décision
Le bon rendu se choisit page par page, selon deux questions : la page doit-elle ranker, et à quelle fréquence son contenu change-t-il ? Une page qui doit ranker part avec un HTML complet. Le rendu client reste pour ce qu'aucun moteur n'a besoin de voir.
| Type de page | Rendu conseillé | Pourquoi |
|---|---|---|
| Accueil, landing, article, documentation | Prérendu au build (génération statique) | Contenu stable, HTML complet servi tout de suite, rapide |
| Catégorie, fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées., annonce | Rendu serveur à la requête, ou prérendu régénéré | Prix, stock et disponibilité changent, le HTML doit suivre |
| Recherche interne, filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. combinés | Rendu serveur, ou rendu client si la page reste hors index | Valeur SEO faible, gros volume d'URL |
| Espace client, tableau de bord, back-office | Rendu client | Derrière un login, rien à indexerProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. |
L'équipe de React pousse dans ce sens. Elle a déprécié Create React App le 14 février 2025 et recommande de démarrer avec un framework : Next.js, React Router, ou Expo pour les applications mobiles. Ces frameworks permettent d'utiliser un serveur sur les pages qui en ont besoin, sans l'imposer aux autres.
Le billet de React qui annonce la fin de Create React App le précise : le rendu serveur peut améliorer le SEO, et il réduit aussi la quantité de JavaScript que le visiteur télécharge avant de voir la page.

Le rendu dynamique, qui sert une version prérendue aux robots et l'application aux visiteurs, a longtemps servi de rustine. Google le présente désormais comme une solution de contournement, déconseillée parce qu'elle ajoute de la complexité et consomme des ressources. Oubliez-le.
Sur un projet existant en rendu client pur, la sortie propre reste la migration vers un framework, gabarit par gabarit, en commençant par les pages qui portent le trafic. Le fonctionnement du rendu côté serveur et ses risques (temps de réponse, cache, hydratation) se prépare avant de basculer.
Une telle migration change le HTML de toutes les pages en même temps : c'est une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. au sens SEO, avec son plan de recette. Slashr intervient en SEO aux côtés de l'agence ou de l'équipe qui développe le site React, dans le cadre d'un accompagnement SEO de refonte et de migration.
Title, meta description et canonical avec le code d'aujourd'hui
Depuis React 19, un composant peut rendre directement <title>, <meta> et <link> : React les place dans le <head> du document, où qu'ils se trouvent dans l'arbre. Plus besoin de bibliothèque pour les cas simples. Les exemples suivent les versions en cours : React 19, Next.js 16 et React Router 8. Les recettes de 2023, avec React Helmet, next/head ou Create React App, ont vieilli.
React 19 seul ou avec React Router
export default function ProductPage({ product }) {
  return (
    <article>
      <title>{`${product.name} | Ma Boutique`}</title>
      <meta name="description" content={product.summary} />
      <link rel="canonical" href={`https://www.example.com/produits/${product.slugPartie de l'URL identifiant une page spécifique, généralement après le nom de domaine.}`} />
      <h1>{product.name}</h1>
      {/* reste de la fiche */}
    </article>
  );
}
Deux détails tirés de la documentation de React.
Le contenu de <title> doit être une seule chaîne de caractères : écrire Résultats page {pageNumber} produit un tableau de deux éléments et une erreur, d'où le gabarit de chaîne de l'exemple. Ensuite, un seul composant doit rendre un <title> à la fois, sinon React les place tous dans le head et le comportement des moteurs devient imprévisible. React Router 8 suit la même voie : sa documentation recommande, depuis React 19, les balises natives plutôt que l'export meta des modules de route.
Ces balises natives règlent la question du « où », pas celle du « quand ». En rendu client, elles n'existent qu'après l'exécution du JavaScript. Google les lit au rendu ; un robot qui n'exécute pas le script ne voit que le title générique du fichier index.html. D'où l'intérêt du prérendu pour les pages qui doivent ranker. Même logique pour la balise og:image et la directive max-image-preview:large, qui ouvrent la grande vignette dans le flux Google Discover : servez-les dans le HTML prérendu.

Next.js : l'API Metadata
Avec l'App Router de Next.js, les balises passent par l'objet metadata ou par la fonction generateMetadata, exportés depuis une page ou un layout. next/head appartient à l'ancien Pages Router.
L'exemple suit le modèle des nouveaux projets : les réglages recommandés de create-next-app activent Cache Components. Les données passent par des fonctions mises en cache avec 'use cache' :
// lib/products.ts (Cache Components activé : cacheComponents: true)
import { cacheLife } from 'next/cache'

export type Product = { slug: string; name: string; summary: string; updatedAt: string }

export async function getProduct(slug: string): Promise<Product | null> {
  'use cache'
  cacheLife('hours')
  const res = await fetch(`https://api.example.com/produits/${slug}`)
  if (!res.ok) return null
  return res.json()
}

export async function getProducts(): Promise<Product[]> {
  'use cache'
  cacheLife('hours')
  const res = await fetch('https://api.example.com/produits')
  return res.json()
}
La page liste ses URL au build et calcule ses balises :
// app/produits/[slug]/page.tsx
import type { Metadata } from 'next'
import { notFound } from 'next/navigation'
import { getProduct, getProducts } from '@/lib/products'

type Props = { params: Promise<{ slug: string }> }

export async function generateStaticParams() {
  const products = await getProducts()
  return products.map((product) => ({ slug: product.slug }))
}

export async function generateMetadata({ params }: Props): Promise<Metadata> {
  const { slug } = await params
  const product = await getProduct(slug)
  if (!product) notFound()
  return {
    title: product.name,
    description: product.summary,
    alternates: { canonical: `https://www.example.com/produits/${slug}` },
  }
}

export default async function Page({ params }: Props) {
  const { slug } = await params
  const product = await getProduct(slug)
  if (!product) notFound()
  return <h1>{product.name}</h1>
}
Les params sont une promesse qu'on attend avec await, et ces exports ne fonctionnent que dans des Server Components.
Avec Cache Components, Next.js exige une frontière <Suspense> autour de tout composant qui attend des données lues à chaque requête, y compris un await params : sans elle, le next build s'arrête sur une erreur de prérendu (page blocking-route de la documentation). generateStaticParams lève cette contrainte en fournissant les slugs connus au build, et cacheLife('hours') régénère les données au plus une fois par heure. Sur un projet existant passé en version 16 sans activer cacheComponents, retirez 'use cache' et cacheLife : c'est le modèle précédent.
Sur les pages rendues à la requête, Next.js diffuse les métadonnées en streaming pour accélérer l'affichage, sauf pour les robots qui attendent les balises dans le <head> : pour eux, il les rend d'un bloc, et l'option htmlLimitedBots règle la liste. Les pages prérendues, comme celle de l'exemple, n'ont pas ce streaming : leurs métadonnées sont résolues au build.
Dernier détail, getProduct est appelé deux fois, par les métadonnées puis par la page. Avec 'use cache', une fonction rend le même résultat pour les mêmes arguments, et le second appel ne refait pas la requête.
Dans le modèle précédent, les requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. fetch identiques sont mémorisées automatiquement. Une fonction qui interroge directement une base de données s'enveloppe alors dans cache de React, qui ne garde rien d'une visite à l'autre : réservé aux Server Components, il évite les appels en double pendant le rendu d'une requête, puis React vide ce cache à la requête suivante. Le guide Next.js SEO revient sur les modes de rendu propres au framework.
React Helmet, que l'on trouve encore dans beaucoup de tutoriels, n'a plus publié de version depuis la 6.1.0 du 8 juin 2020. Retirez-le. Sur un site Gatsby, la remplaçante s'appelle l'API Head : Gatsby désactive la gestion native des balises de React 19, et notre guide SEO de Gatsby décrit la migration depuis Helmet.
Son successeur, react-helmet-async, le dit lui-même dans sa documentation : pour un nouveau projet React 19 sans besoins avancés, la gestion native des métadonnées peut suffire. Quant au contenu de ces balises, il obéit aux mêmes règles que sur n'importe quel site : une meta description propre à chaque page, et un title qui annonce ce que la page traite.
URL, liens et codes HTTP : les trois pièges des SPA
Une application monopage doit donner à chaque vue sa propre URL, la relier par de vrais liens et renvoyer le bon code HTTP. Ce sont les trois endroits où une SPA casse le plus souvent son référencement.
Les URL. Google demande d'utiliser l'API History plutôt que des fragments (https://example.com/#/produits) : le schéma d'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. AJAX qui permettait de lire les fragments est obsolète depuis 2015. Avec React Router, cela veut dire BrowserRouter, jamais HashRouter, pour un site qui doit être indexé.
import { BrowserRouter, Routes, Route, Link } from "react-router";

function App() {
  return (
    <BrowserRouter>
      <nav>
        <Link to="/produits">Tous les produits</Link>
      </nav>
      <Routes>
        <Route index element={<Home />} />
        <Route path="produits" element={<Catalogue />} />
        <Route path="produits/:slug" element={<Product />} />
      </Routes>
    </BrowserRouter>
  );
}
Les liens. Google n'explore de manière fiable que les éléments <a> munis d'un attribut href. Le composant Link de React Router produit justement un <a href>. Un <div onClick={() => navigate("/produits")}> ou un bouton fait la même chose pour le visiteur, mais Google ne peut pas en extraire l'URL de manière fiable : la navigation entre pages passe toujours par un lien.

Les codes HTTP. En rendu client, le serveur répond souvent 200 à toutes les URL, y compris pour un produit qui n'existe plus : Google peut alors indexer la page d'erreur, ou la classer en soft 404. Sa documentation propose deux sorties : rediriger en JavaScript vers une URL qui renvoie un vrai 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. côté serveur (par exemple /not-found), ou ajouter une balise meta robots noindexDirective indiquant aux moteurs de ne pas indexer une page. sur la page d'erreur. L'inverse ne marche pas : un noindex présent dans le HTML initial, que le JavaScript retirerait ensuite, peut faire sauter le rendu, et la page reste hors index.
Next.js a sa propre subtilité. notFound() renvoie un vrai 404 tant que la réponse n'a pas commencé à être diffusée.
Si un loading.tsx ou une frontière <Suspense> a déjà lancé le streaming, le code reste 200 et Next.js ajoute un noindex dans le HTML. La page sort de l'index, mais certains robots la classent en soft 404. Pour un vrai 404, vérifiez l'existence du contenu avant le streaming, par exemple dans le Proxy de Next.js, qui peut réécrire la requête vers une route not-found ou renvoyer directement un 404.
Les redirections suivent la même logique. Google exécute les redirections JavaScript, mais il demande de ne les utiliser que si une redirection côté serveur est impossible. Un changement d'URL se règle donc en 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. au niveau du serveur ou de la configuration du framework, comme l'explique le guide des redirections SEO. Pour vérifier que la réponse part bien en 301 et en un seul saut, la commande curl est dans l'article sur le test d'une redirection 301.
Performance : ce qui ralentit un site React et comment le mesurer
Un site web performant en React envoie peu de JavaScript au premier chargement et affiche son contenu principal sans attendre l'application entière. Google mesure l'expérience avec les Core Web VitalsMétriques de Google mesurant l'expérience utilisateur : LCP (chargement), INP (interactivité), CLS (stabilité visuelle). : le plus grand élément visible doit s'afficher en moins de 2,5 secondes (LCPLargest Contentful Paint. Mesure le temps de chargement du plus grand élément visible. Idéalement < 2,5 secondes.), la réactivité aux interactions rester sous 200 millisecondes (INPInteraction to Next Paint. Mesure la réactivité aux interactions utilisateur. Remplace le FID depuis 2024.) et le décalage visuel sous 0,1 (CLSCumulative Layout Shift. Mesure la stabilité visuelle de la page. Idéalement < 0,1.).

Sur une application React, le premier poste de dépense est le JavaScript. Chaque kilo-octet se paie. Le prérendu et le rendu serveur affichent le contenu avant l'hydratation, ce qui aide le LCP. Le découpage du code fait le reste : chargez à la demande ce qui n'est pas visible au premier écran, avec lazy et Suspense.
import { lazy, Suspense } from 'react';

const Reviews = lazy(() => import('./Reviews.jsx'));

export default function ProductPage({ product }) {
  return (
    <article>
      <h1>{product.name}</h1>
      <p>{product.description}</p>
      <Suspense fallback={<p>Chargement des avis...</p>}>
        <Reviews productId={product.id} />
      </Suspense>
    </article>
  );
}
Déclarez le composant lazy au niveau du module, jamais à l'intérieur d'un autre composant. Et réservez le chargement à la demande aux blocs secondaires (avis, carrousel, carte) : le texte qui doit ranker reste dans le rendu initial. Si vos avis doivent compter pour le référencement, servez au moins les plus riches dans ce rendu initial et chargez le reste à la demande, comme le détaille notre article sur le contenu UGC et le SEO. Mesurez ensuite sur les données réelles des visiteurs, dans le rapport Core Web Vitals de la Search Console ou sur PageSpeed Insights. La vitesse compte parmi les signaux du positionnement dans les moteurs de recherche, sans compenser un contenu absent du HTML.
Sitemap, robots.txt et données structurées
Le sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. d'un site React se génère à partir des mêmes données que les pages, et le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. ne doit jamais bloquer les fichiers JavaScript dont dépend l'affichage. Les données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets. suivent la même règle que le reste : dans le HTML initial de préférence.
Avec Next.js, un fichier app/sitemap.ts produit le sitemap.xml :
// app/sitemap.ts
import type { MetadataRoute } from 'next'
import { getProducts } from '@/lib/products'

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const products = await getProducts()
  return products.map((product) => ({
    url: `https://www.example.com/produits/${product.slug}`,
    lastModified: product.updatedAt,
  }))
}
Les champs changeFrequency et priority de la documentation Next.js sont facultatifs, et Google ignore ces deux valeurs : gardez l'URL et une date de modification juste. Avec React Router en mode framework, la liste des chemins à prérendre (option prerender de react-router.config.ts) peut alimenter de la même façon un sitemap généré au build. Le reste des règles d'un bon fichier est dans le guide du sitemap SEO.
// react-router.config.ts
import type { Config } from "@react-router/dev/config";
import { getProductSlugs } from "./app/lib/products";

export default {
  ssr: false,
  async prerender({ getStaticPaths }) {
    const slugs = await getProductSlugs();
    return [...getStaticPaths(), ...slugs.map((slug) => `/produits/${slug}`)];
  },
} satisfies Config;
Côté robots.txt, Google n'exécute pas le JavaScript des fichiers bloqués. Un Disallow: /static/ ou Disallow: /assets/ posé pour « alléger le crawl » peut donc vider la page rendue. La gestion du robots.txt se vérifie après chaque changement de structure des fichiers compilés.
Enfin, Google accepte des données structurées JSON-LDFormat recommandé par Google pour implémenter les données structurées dans le code source. générées en JavaScript, à condition de tester le résultat avec le test des résultats enrichis ou l'outil d'inspection d'URL. Rendues côté serveur, elles sont lisibles par tous les robots dès le premier passage, y compris ceux des assistants IA. Pour savoir quels types baliser et comment vérifier que le JSON-LD figure bien dans le HTML brut, voyez notre guide des données structurées pour le GEO.

Ces contrôles s'enchaînent dans un audit technique : HTML initial, rendu, balises, codes HTTP, sitemap. C'est ce que couvre notre accompagnement SEO pour un site React ou Next.js. Pour un site qui doit aussi être cité par ChatGPTAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses. ou PerplexityMoteur de recherche conversationnel basé sur l'IA, concurrent émergent de Google., notre grille d'audit technique GEO ajoute l'accès des robots d'IA et le réglage du CDNContent Delivery Network. Réseau de serveurs distribuant le contenu depuis le serveur le plus proche de l'utilisateur..
Questions fréquentes
React est-il mauvais pour le SEO ?
Non. React produit le HTML que vous lui demandez de produire : avec un prérendu ou un rendu serveur, une page React arrive chez Google aussi complète qu'une page statique. Les problèmes viennent du rendu client pur sur des pages qui doivent ranker, des URL avec dièse et des pages d'erreur renvoyées en 200.
Faut-il encore utiliser React Helmet ?
Pour un nouveau projet, non. React Helmet n'a plus de version depuis juin 2020, et React 19 gère nativement <title>, <meta> et <link> dans les composants. react-helmet-async reste utile si vous avez besoin de fonctions avancées, comme un modèle de title ou des attributs sur la balise html.
React Router suffit-il pour le SEO d'une SPA ?
Il règle les URL et les liens : BrowserRouter donne une vraie adresse à chaque vue et Link produit des <a href> explorables. Il ne règle pas le rendu tant que l'application reste en rendu client : c'est le rôle du mode framework de React Router, avec son option de prérendu.
Next.js est-il obligatoire pour référencer un site React ?
Non, mais un framework l'est presque : depuis la fin de Create React App, l'équipe de React recommande d'en utiliser un. Next.js et React Router en mode framework font tous deux du prérendu et du rendu serveur. Le choix dépend de votre hébergement et de l'équipe qui maintient le site.
Sources
- Comprendre les bases du SEO JavaScript, Google Search Central
- The rise of the AI crawler, vercel.com
- Résoudre les problèmes JavaScript liés à la recherche, Google Search Central
- Outil d'inspection d'URL, Aide Google
- Sunsetting Create React App, react.dev
- Creating a React App, react.dev
- L'affichage dynamique comme solution de contournement, Google Search Central
- React v19, react.dev
- Composant title, référence React DOM, react.dev
- Route Module, reactrouter.com
- Getting Started: Metadata and OG images, Next.js
- Components: Head, Next.js
- React Helmet, version 6.1.0, github.com
- react-helmet-async, README, github.com
- Bonnes pratiques de SEO concernant les liens pour Google, Google Search Central
- Link, reactrouter.com
- File-system conventions: not-found.js, Next.js
- File-system conventions: loading.js, Next.js
- Redirections et recherche Google, Google Search Central
- Comprendre les signaux Web essentiels et les résultats de recherche Google, Google Search Central
- lazy, react.dev
- Metadata Files: sitemap.xml, Next.js
- Créer et envoyer un sitemap, Google Search Central
- Pre-Rendering, reactrouter.com
- Blog de Next.js, notes de version
- Functions: generateMetadata, Next.js
- CLI: create-next-app, Next.js
- Uncached data was accessed outside of
<Suspense>, Next.js - Functions: cacheLife, Next.js
- Directives: use cache, Next.js
- cache, react.dev