




Le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. est un fichier texte placé à la racine du site qui indique aux robots les URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. qu'ils peuvent explorer. En SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche., il concentre l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. sur les pages utiles et soulage le serveur. Il ne retire aucune page de Google et ne protège rien : le fichier est public, et une URL bloquée peut rester indexée.
À quoi sert le fichier robots.txt en SEO
Le robots.txt sert à gérer le trafic des robots sur votre site. Google le résume ainsi dans sa documentation : le fichier est surtout utilisé pour éviter de surcharger le site de requêtes, et il ne permet pas de garder une page hors de Google.
Avant d'explorer une URL, Googlebot lit le fichier /robots.txt de l'hôte. Si l'URL y est interdite, il ne la télécharge pas et passe à la suivante. C'est la première étape du processus de crawling des moteurs de recherche, avant le rendu et l'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats..
Deux conséquences en découlent. D'abord, bloquer l'exploration ne désindexe pas. Google l'écrit noir sur blanc : une URL interdite peut quand même être indexée si d'autres pages du web pointent vers elle. Elle apparaît alors dans les résultats, mais sans description, puisque Google n'a jamais lu son contenu. Seule exception documentée : les images, vidéos et fichiers audio, qu'un Disallow suffit à sortir des résultats de Google.
Ensuite, le robots.txt ne protège rien. N'importe qui peut ouvrir votresite.fr/robots.txt dans un navigateur, et lister vos dossiers sensibles revient à les signaler. Les consignes ne sont pas contraignantes non plus : GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. et les robots sérieux les respectent, d'autres non. La RFC 9309, qui standardise le protocole, le prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.écise : ces règles ne sont pas une forme d'autorisation d'accès.

Robots.txt, noindex ou mot de passe : choisir selon l'objectif
Le bon outil dépend de ce que vous voulez obtenir, et le robots.txt ne répond qu'à une seule question : faut-il que les robots passent du temps sur ces URL ?
| Objectif | Outil | Pourquoi |
|---|---|---|
| Économiser l'exploration sur des URL sans valeur | Disallow dans le robots.txt |
Googlebot ne les télécharge plus |
| Retirer une page des résultats de Google | Balise ou en-tête noindexDirective indiquant aux moteurs de ne pas indexer une page., page explorable |
Google doit lire la consigne pour l'appliquer |
| Retirer un PDF des résultats | En-tête HTTP X-Robots-Tag: noindex |
Le noindex en en-tête couvre les fichiers non HTML |
| Retirer une image, une vidéo ou un fichier audio | Disallow ou X-Robots-Tag: noindex |
Même effet selon Google, un seul des deux suffit |
| Rendre un contenu inaccessible (préproduction, espace client) | Mot de passe ou authentification serveur | Une vraie protection, contrairement à une consigne |
| Supprimer définitivement une page | Code 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. ou 410 | La page sort de l'index une fois explorée |
Le piège classique se trouve sur la deuxième ligne. Vous posez un noindex sur des pages, puis vous les bloquez dans le robots.txt « pour faire bonne mesure ». Résultat : Googlebot ne visite plus la page, ne voit jamais le noindex, et l'URL peut rester dans l'index.
Google le dit explicitement dans sa page sur le blocage de l'indexation : pour que le noindex fonctionne, la page ne doit pas être bloquée par le robots.txt. L'ordre est donc toujours le même. Noindex d'abord, attente de la désindexation, puis blocage éventuel. Et seulement si l'URL n'est pas liée de l'extérieur : une fois bloquée, Google ne voit plus le noindex et peut la réindexer sans description.
Autre réflexe hérité : écrire Noindex: dans le robots.txt. Google a retiré le code qui gérait cette règle non officielle le 1er septembre 2019. Elle n'a plus aucun effet. Le guide pour désindexer des URL proprement détaille chaque méthode et les délais à prévoir.

La syntaxe que Google lit vraiment
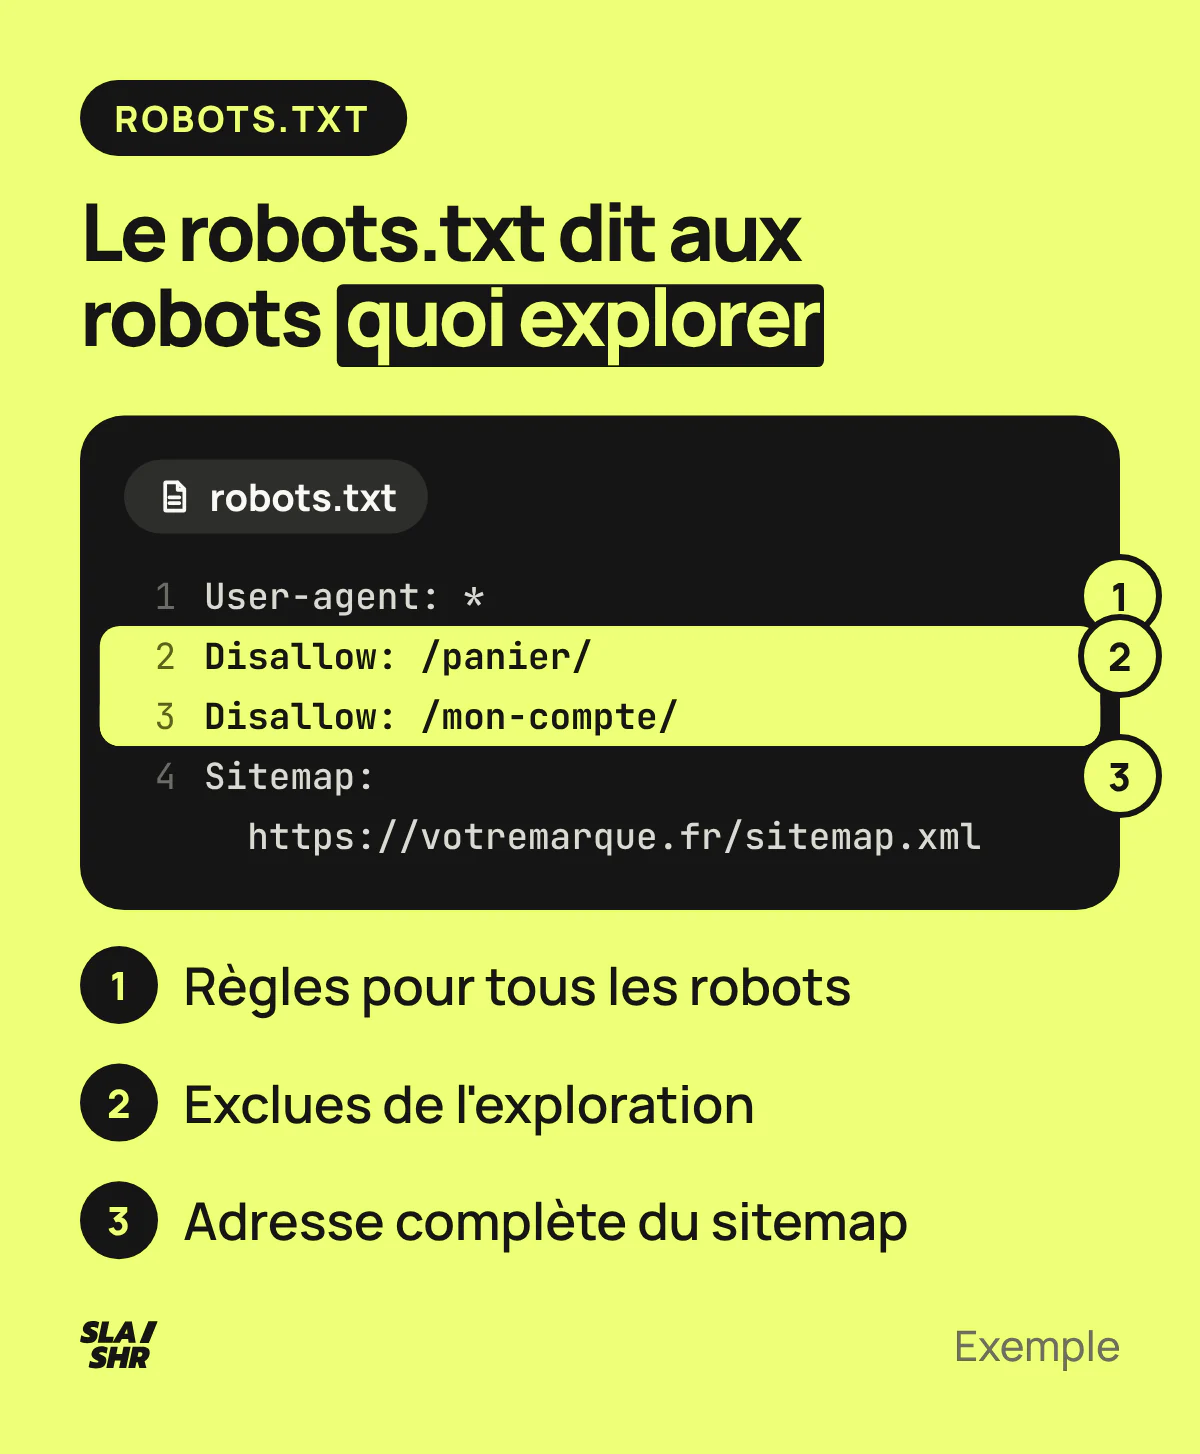
Un robots.txt se compose de groupes : une ou plusieurs lignes User-agent, suivies des règles qui s'appliquent à ces robots. Chaque directive tient sur sa propre ligne.
# Règles pour tous les robots
User-agent: *
Disallow: /panier/
Disallow: /mon-compte/
Allow: /mon-compte/aide/

SitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche.: httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.votremarque.fr/sitemap.xml
Google prend en charge quatre champs, et seulement quatre :
User-agentdésigne le robot visé. L'étoile vise tous les robots qui n'ont pas de groupe à leur nom.Disallowinterdit l'exploration d'un chemin. AvecDisallow: /, tout le site est fermé ; une ligneDisallow:sans chemin est ignorée, donc rien n'est bloqué.Allowrouvre un chemin dans un dossier interdit. Cette directive figure dans la RFC 9309, publiée en septembre 2022 : tous les robots qui suivent le standard la lisent, Googlebot compris.Sitemapindique l'adresse complète d'un sitemap, protocole et domaine compris. La ligne ne dépend d'aucun groupe, et vous pouvez en déclarer plusieurs. Le guide du sitemap XML explique comment le segmenter et l'auditer.
Crawl-delay ne fait pas partie de la liste. Google l'ignore. Bing, lui, le respecte. Et pour ralentir Googlebot, l'outil de limitation de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. a disparu le 8 janvier 2024 : Google renvoie désormais aux réponses du serveur, puisque des codes 500 répétés le font ralentir presque immédiatement.
Six règles d'interprétation évitent la plupart des erreurs :
- Les chemins sont sensibles à la casse.
Disallow: /Panier/laisse/panier/ouvert. - Deux jokers sont reconnus. L'étoile remplace n'importe quelle suite de caractères, le dollar marque la fin de l'URL : la règle
Disallow: /*.pdf$vise les URL qui se terminent par .pdf. - La règle la plus longue gagne. Entre
Allow: /petDisallow: /, la page/pagereste explorable. En cas de conflit, Google applique la règle la moins restrictive. - Un seul groupe par robot. Si vous créez un groupe
User-agent: Googlebot, Googlebot ignore entièrement le groupe général. Recopiez-y les règles communes. - Un fichier par hôte. Le robots.txt de
www.votremarque.frne vaut ni pourblog.votremarque.fr, ni pour la version http, ni pour un autre port. - 500 Kio au maximum, encodé en UTF-8. Google ignore ce qui dépasse.

Que bloquer, que laisser ouvert : les bonnes pratiques par type de site
Bloquez ce qui génère des URL en masse sans valeur de recherche, et rien d'autre. Sur un site vitrine de quelques dizaines de pages, un robots.txt quasi vide est souvent le bon réglage.
Les mentions légales, CGV, CGU ou la politique de confidentialité n'ont rien à faire dans un Disallow. Elles pèsent peu dans l'exploration et le blocage ne les retire pas de l'index. Si vous tenez à les sortir des résultats, un noindex suffit.
Un site e-commerce a plus de raisons de s'en servir. Panier, compte client, tunnel de commande, et surtout recherche interne et combinaisons de filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. : ces gabarits peuvent générer un nombre d'URL sans limite, que Googlebot explorerait pour rien. Google le dit des facettes à paramètres, et propose de bloquer leur exploration au robots.txt quand ces URL n'ont pas à apparaître dans la recherche.
User-agent: *
Disallow: /panier/
Disallow: /commande/
Disallow: /mon-compte/
Disallow: /recherche
Disallow: /*?*tri=
Disallow: /*?*couleur=*&Accelerated Mobile Pages. Framework Google pour créer des pages mobiles ultra-rapides (moins utilisé aujourd'hui).;taille=
Adaptez les deux dernières lignes à vos paramètres réels. Un blocage trop large sur les facettes peut fermer des pages de catégorie filtrées qui rankent. L'article sur les filtres à facettes et leur impact SEO aide à trier les combinaisons à ouvrir et celles à fermer.
Laissez explorables les CSS, les fichiers JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. et les images dont la page a besoin pour s'afficher. Google est clair : si l'absence d'une ressource rend la page plus difficile à comprendre, ne la bloquez pas. Il ne rend pas le JavaScript des fichiers bloqués, et un Disallow: /assets/ peut le priver d'une partie du contenu. Sur un site Next.js, ces fichiers sont servis sous /_next/, un dossier à laisser ouvert, comme le rappelle le guide SEO pour Next.js. Les erreurs JavaScript qui pénalisent le SEO en donnent d'autres exemples. Le plus sûr reste de ne pas faire dépendre le texte de ces fichiers : avec un rendu côté serveur ou un prérendu, il figure déjà dans le HTML que lit le robot.
Pour une préproduction, le robots.txt est le mauvais outil. Une URL de recette liée depuis une page publique peut être indexée malgré le Disallow. Et le Disallow: / de la préprod peut partir en production avec le reste du code. Une authentification HTTP règle les deux problèmes. Contrôlez aussi le robots.txt servi en production le jour de la bascule, une étape à ajouter à votre checklist de migration SEO.
Reste le budget de crawlNombre de pages que Googlebot peut et veut crawler sur un site dans un temps donné.. Google destine surtout son guide sur le sujet à trois profils : les sites de plus d'un million de pages mises à jour chaque semaine, ceux de plus de 10 000 pages qui changent chaque jour, et ceux dont une grande part des URL reste « Détectée, actuellement non indexée ». Hors de ces cas, le robots.txt sert surtout à garder une exploration propre.
Google déconseille aussi de bloquer des pages pour réallouer temporairement le budget vers d'autres : ne bloquez que ce que vous ne voulez jamais voir exploré. Les mécanismes sont détaillés dans l'article sur le crawl budget en SEO.

Créer et modifier le robots.txt sur WordPress, Shopify et PrestaShop
Sur un site codé à la main, vous créez un fichier texte nommé robots.txt, encodé en UTF-8, et vous le déposez à la racine de l'hôte. Sur un CMS, le fichier est généré. Chaque plateforme a sa façon de le modifier.
WordPress : Yoast, Rank Math ou fichier physique
WordPress sert un robots.txt virtuel tant qu'aucun fichier n'existe à la racine. Par défaut, il contient User-agent: *, Disallow: /wp-admin/ et Allow: /wp-admin/admin-ajax.php. Trois façons de le modifier :
- Avec Yoast SEO : Yoast SEO, puis Outils, puis Éditeur de fichiers. Le menu disparaît si l'édition de fichiers est désactivée sur l'installation.
- Avec Rank Math : Rank Math SEO en mode avancé, puis Réglages généraux, puis Modifier le robots.txt. L'éditeur ne s'applique qu'en l'absence de fichier physique à la racine.
- Sans extension : un fichier
robots.txtdéposé à la racine par FTP, qui remplace alors la version virtuelle.
Avant de toucher au robots.txt, réglez l'indexation dans l'extension elle-même : notre guide des extensions SEO pour WordPress donne l'arbre de décision pour les archives, les tags et la recherche interne.
Shopify : le modèle robots.txt.liquid
Shopify génère un robots.txt par défaut qui, selon sa documentation, convient à la plupart des boutiques. Pour le personnaliser, ajoutez le modèle robots.txt.liquid au thème : Boutique en ligne, menu du thème, Modifier le code, Ajouter un nouveau modèle, puis « robots ». Ce modèle remplace le fichier généré.
Prudence. Shopify précise que son support n'aide pas sur ce fichier et qu'une mauvaise manipulation peut faire perdre tout le trafic. Gardez les groupes par défaut avec les objets Liquid fournis et ajoutez vos règles autour, comme le recommande la documentation développeur. Le guide Shopify SEO couvre le reste de la configuration technique de la boutique. Sur les collections, les règles par défaut bloquent déjà les tris et les combinaisons de tags : notre guide pour optimiser les collections Shopify détaille ce qu'il reste à vérifier, filtres et noindex compris.
PrestaShop : le générateur du back-office
PrestaShop génère le fichier depuis le back-office : Paramètres de la boutique, Trafic & SEO, page SEO & URL, en bas de page (bloc « Robots file generation » dans l'interface anglaise). En version 8, le bouton régénère le fichier et écrase l'ancien.
Une règle ajoutée à la main par FTP disparaît donc à la génération suivante : gardez vos ajouts à part pour les réappliquer, ou confiez-les à un module. Le guide PrestaShop SEO reprend les autres réglages du back-office.

Robots.txt et bots IA : décider robot par robot
Le robots.txt est aussi l'endroit où vous dites oui ou non aux robots des IA, avec un groupe par robot. Chaque acteur a ses propres noms. Certains en ont plusieurs, un par usage.
Chez OpenAI, deux robots se règlent dans le robots.txt. OAI-SearchBot alimente la recherche de ChatGPTAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses. : un site qui le bloque n'apparaît plus dans les réponses de recherche de ChatGPT, hors liens de navigation. GPTBot collecte des contenus pour l'entraînement des modèles. Les deux réglages sont indépendants. Vous pouvez donc rester visible dans ChatGPT sans nourrir l'entraînement :
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Un troisième agent, ChatGPT-User, visite une page quand un utilisateur le demande dans ChatGPT. OpenAI prévient que les règles du robots.txt peuvent alors ne pas s'appliquer.
Google-Extended désigne un jeton de contrôle, sans robot dédié. Google le lit pour savoir si vos contenus peuvent servir à entraîner GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche. et à ancrer ses réponses dans Gemini Apps et Vertex AI. Google précise que ce jeton n'a aucun effet sur votre présence dans la recherche Google ni sur votre classementPosition d'une page web dans les résultats de recherche pour une requête donnée.. Le réglage du CDNContent Delivery Network. Réseau de serveurs distribuant le contenu depuis le serveur le plus proche de l'utilisateur., le rendu JavaScript et les robots qui récupèrent une page à la demande comptent autant pour les assistants : notre grille d'audit technique GEO les vérifie un par un.
Sur Shopify, ces groupes s'ajoutent dans le même modèle robots.txt.liquid. Gardez en tête la limite de départ : un robot qui ne respecte pas le protocole lira le fichier et passera outre. Seuls les logs serveurFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots. disent qui visite vraiment vos pages. L'analyse de logs orientée GEO montre comment repérer ces robots et arbitrer.

Tester et surveiller votre robots.txt après chaque modification
Une ligne mal placée peut fermer un site entier. Chaque modification se teste avant et se surveille après, en quatre gestes.
- Vérifiez l'accès. Ouvrez
votresite.fr/robots.txtdans une fenêtre de navigation privée : le fichier doit s'afficher en texte brut, avec un code 200. - Testez les URL qui comptent. Avant publication, passez vos pages stratégiques (accueil, catégories, fiches produits) contre les nouvelles règles, avec notre Robots.txt Checker gratuit, qui accepte un contenu collé et teste chaque URL pour Googlebot, Bingbot ou GPTBot. La bibliothèque robots.txt open source de Google fait le même travail en local.
- Forcez la relecture. Google met à jour sa copie en cache toutes les 24 heures. Le rapport robots.txt de la Search Console affiche les fichiers trouvés pour les 20 principaux hôtes de la propriété, la date de la dernière exploration et les erreurs, et permet de demander une nouvelle exploration.
- Surveillez les jours suivants. Les rapports d'indexation de la Search Console et vos logs montrent si des pages utiles sont devenues « Bloquées par le fichier robots.txt ». Le statut « Indexée malgré le blocage par le fichier robots.txt » signale l'inverse : une URL bloquée que Google a quand même indexée.
Le code de réponse du fichier compte autant que son contenu. Une erreur 4xx (sauf la 429) est traitée comme une absence de robots.txt : Google explore alors tout. Une erreur 5xx produit l'effet inverse : pendant les 12 premières heures, Google cesse d'explorer le site, puis il utilise la dernière version valide pendant 30 jours. Un robots.txt en erreur serveurCode HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. après une mise en production peut donc geler l'exploration de tout le site. Surveillez-le comme une page.

Une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. cumule les risques : nouvelle arborescence, nouveau CMS, fichier de recette à remplacer. C'est le moment de repasser ces quatre contrôles, avec ou sans accompagnement en refonte et migration SEO.
Questions fréquentes
Un site a-t-il besoin d'un fichier robots.txt ?
Il n'est pas obligatoire. Sans fichier, le serveur renvoie une 404 et Google considère qu'aucune restriction ne s'applique : il explore tout. Un petit site sans recherche interne ni filtres peut s'en passer, même si déclarer le sitemap dans un robots.txt reste pratique.
Une page bloquée par le robots.txt peut-elle apparaître dans Google ?
Oui. Si d'autres pages pointent vers elle, Google peut indexer l'URL sans l'avoir explorée. Elle s'affiche alors sans description. Pour la retirer, levez d'abord le blocage, puis posez un noindex ou renvoyez une 404 ou une 410 : dans les deux cas, Google doit explorer l'URL pour voir la consigne.
Faut-il bloquer les mentions légales et les CGV dans le robots.txt ?
Non. Le blocage ne les retire pas des résultats et ne fait gagner presque rien en exploration. Si vous voulez qu'elles n'apparaissent pas dans Google, un noindex sur une page restée explorable fait le travail.
Combien de temps faut-il pour que Google prenne en compte un nouveau robots.txt ?
Google garde le fichier en cache jusqu'à 24 heures. Pour accélérer, demandez une nouvelle exploration dans le rapport robots.txt de la Search Console. Les pages déjà indexées évoluent ensuite au rythme de leur propre exploration.
Le robots.txt peut-il empêcher ChatGPT d'utiliser mon site ?
Il peut l'exprimer, à condition de viser les bons robots : GPTBot pour l'entraînement, OAI-SearchBot pour la recherche de ChatGPT. Les deux réglages sont indépendants. Les visites déclenchées par un utilisateur (agent ChatGPT-User) peuvent passer outre, selon OpenAI, et le robots.txt reste une consigne sans contrainte technique pour un robot qui l'ignore.
Sources
- Présentation du fichier robots.txt et guide, Google Search Central
- RFC 9309: Robots Exclusion Protocol, rfc-editor.org
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Remarque sur les règles non acceptées dans le fichier robots.txt, Google Search Central
- Comment Google interprète la spécification robots.txt, Google Search Central
- To crawl or not to crawl, that is BingBot's question, Bing Webmaster Blog
- Abandon à venir du limiteur de vitesse d'exploration dans la Search Console, Google Search Central
- Créer et envoyer un fichier robots.txt, Google Search Central
- Comprendre les bases du SEO JavaScript, Google Search Central
- Gestion du budget d'exploration, Google Search Central
- do_robots(), developer.wordpress.org
- The robots.txt file in Yoast SEO • Yoast, yoast.com
- Using Rank Math's Robots.txt Generator » Rank Math, rankmath.com
- Modifier le fichier robots.txt, Aide Shopify, help.shopify.com
- Customize robots.txt, shopify.dev
- Menus du back-office PrestaShop 8.2 (tab.xml), dépôt PrestaShop, github.com
- Bloc de génération du robots.txt, PrestaShop 8.2, dépôt PrestaShop, github.com
- Overview of OpenAI Crawlers, OpenAI, developers.openai.com
- Robots d'exploration communs de Google, Google Search Central
- Mettre à jour votre fichier robots.txt, Google Search Central
- Rapport robots.txt, Aide Google
- Supprimer les images de votre propre site de la recherche Google, Google Search Central
- Effet des codes d'état HTTP sur les robots d'exploration Google, Google Search Central
- Gérer l'exploration des URL de navigation à facettes, Google Search Central