




Votre page est en position 3 sur Google et PerplexityMoteur de recherche conversationnel basé sur l'IA, concurrent émergent de Google. ne la cite jamais. Votre ranking n'y est pour rien. Ce qui coince, c'est la façon dont votre page se laisse découper.
Il faut quatre choses en même temps pour être cité. PerplexityBot doit pouvoir crawler votre domaine (robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., WAF, rendu HTML). Votre page doit déjà exister dans les index classiques sur la requête concernée. Le passage qui répond doit tenir debout tout seul, et se trouver haut dans la page. Et l'info doit être datée assez récemment pour passer le filtre de fraîcheur. Il en manque une, vous sortez de la réponse, même avec le meilleur contenu du marché sur le sujet.

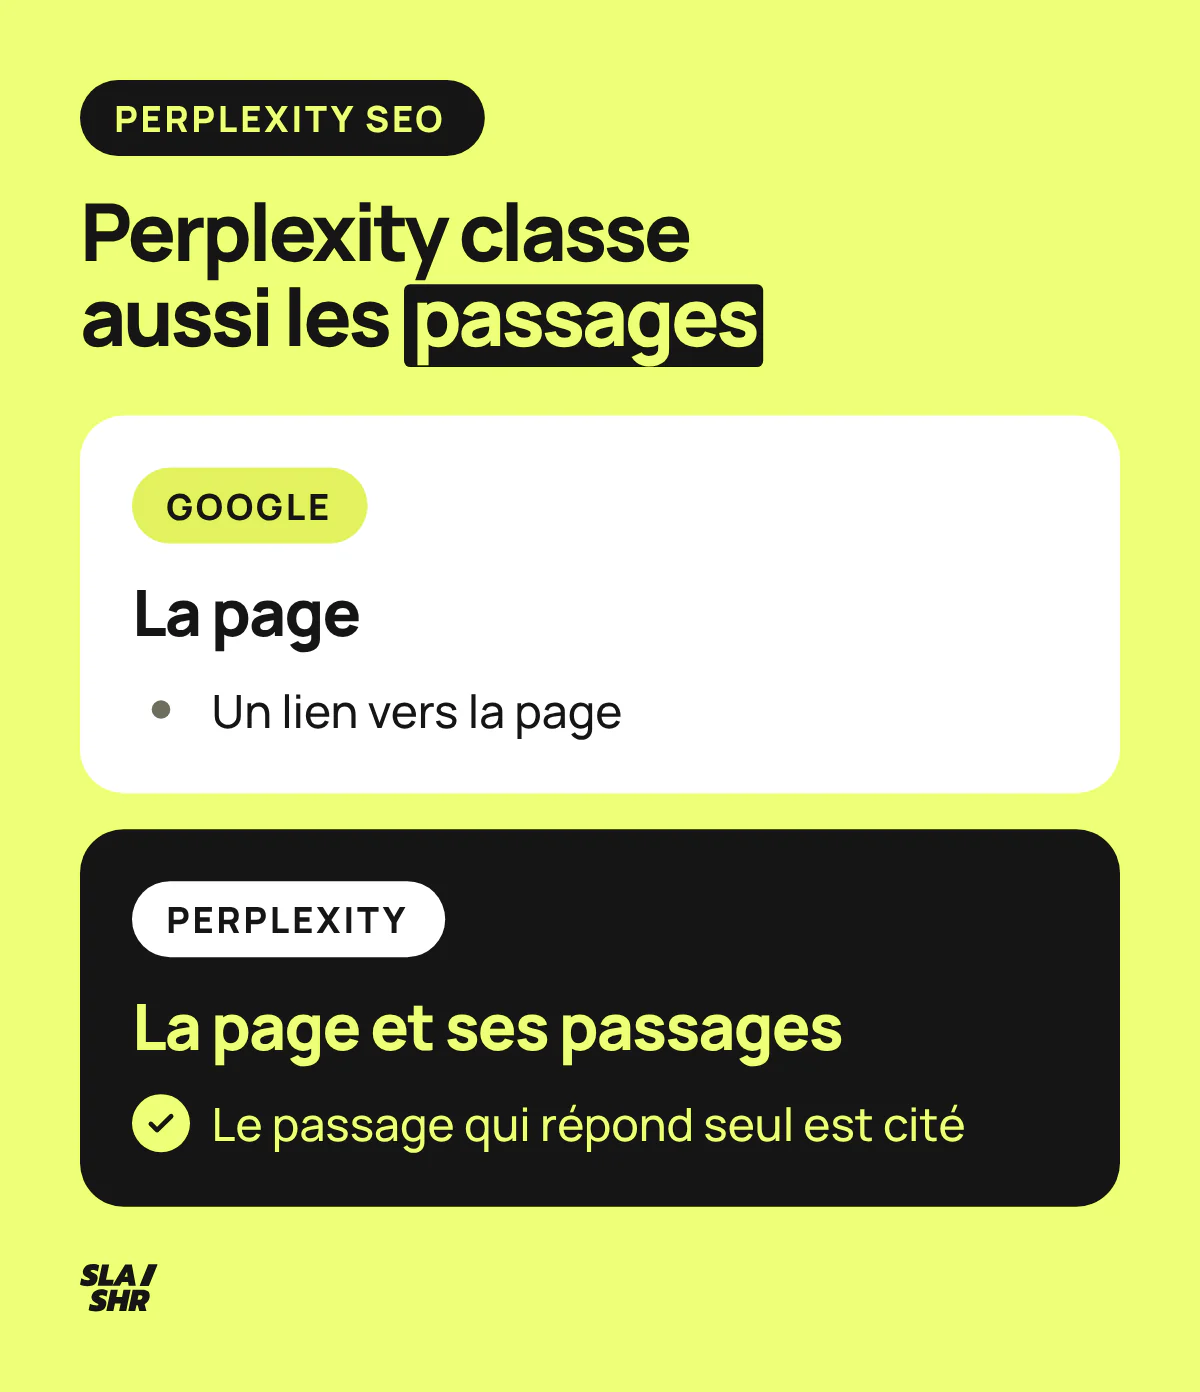
La plupart des articles sur le référencement Perplexity récitent le même catalogue : schema.orgVocabulaire standardisé de balisage structuré reconnu par Google, Bing et Yahoo., contenu de qualité, backlinksLien provenant d'un site externe pointant vers votre site. Facteur de ranking majeur., mise à jour trimestrielle. Rien de faux là-dedans, mais ça ne règle rien. Perplexity ne classe pas votre page. Il classe un passage de votre page, en concurrence avec des passages d'autres pages, y compris de pages qui rankent moins bien que vous. Tant que vous raisonnez en URL, vous optimisez la mauvaise unité.
Ce qui déclenche une citation dans une réponse Perplexity
Perplexity reformule la requête utilisateur en plusieurs requêtes de recherche, récupère un jeu de sources, découpe leur contenu en fragments, et laisse le modèle composer une réponse à partir des fragments les plus pertinents. Les URLsUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. qui apparaissent dans le bandeau de sources sont celles dont un fragment a servi. Pas celles qui étaient « bien positionnées ».

Votre ranking Google reste un ticket d'entrée : les pages déjà bien classées finissent statistiquement plus souvent dans le jeu de sources récupéré. Ça ne suffit pas à être cité. Une page en position 8 avec un bloc de réponse net et daté passe régulièrement devant une position 2 qui noie l'info dans 400 mots de contexte.
La fraîcheur, elle, filtre. Sur les requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. à composante temporelle (tarifs, versions, réglementation, comparatifs), un contenu sans date visible ni signal de mise à jour se fait écarter, quelle que soit son autorité.
Le profil des sources n'a rien à voir avec celui de Google, non plus. Les analyses publiées sur Perplexity vs Google en 2026 montrent une part importante de citations issues de Reddit, là où les AI Overviews de Google s'appuient davantage sur YouTube et Wikipedia. Vous êtes donc en concurrence avec un thread de forum où quelqu'un a répondu à la question en six lignes.
Découpez vos pages en blocs citables

Si je ne devais garder qu'un chantier de tout ce qui suit, ce serait celui-là.
Un chunk, c'est l'unité que le système découpe et vectorise : en pratique, un titre H2Balises HTML structurant le contenu en hiérarchie (H1 à H6). Essentielles pour l'accessibilité et le SEO. ou H3 suivi de deux à quatre paragraphes, entre 150 et 300 mots. Votre article de 2 000 mots n'existe pas pour le modèle. Il existe comme huit ou dix chunks indépendants, dont un ou deux seulement seront candidats à la citationMention du NAP d'une entreprise sur des annuaires ou sites tiers.. Votre boulot, c'est que chacun tienne debout tout seul.
Le test du copier-coller
Prenez n'importe quel bloc de votre article, collez-le dans un document vide, relisez-le sans le reste de la page. S'il commence par « comme on l'a vu plus haut », « cette méthode », « c'est aussi valable ici », il est mort. Le modèle n'a pas le contexte amont, il a le fragment. Un chunk qui dépend de son voisin sera écarté au scoring, parce qu'il ne répond à rien.
Trois réflexes règlent la majorité des cas :
- Répétez l'entité au lieu du pronom. Pas « il coûte environ 40 % moins cher », mais « le modèle Sonar coûte environ 40 % moins cher ». Chaque bloc doit contenir le nom du produit, de la marque ou du concept dont il parle.
- Mettez la donnée et son unité dans la même phrase que l'entité, pas trois lignes plus bas.
- Ouvrez chaque H2 par la réponse factuelle en deux ou trois lignes, puis argumente. L'inverse du plan de dissertation.
La règle des 40 mots après chaque titre
Les 40 à 60 premiers mots qui suivent un H2 ont le plus de chances de finir dans une réponse. Traitez-les comme un livrable à part : une phrase affirmative qui contient la question reformulée, le chiffre ou le critère de décision, et rien d'autre. Le contexte, les nuances et les cas particuliers viennent après. Si vous commencez par « plusieurs facteurs entrent en jeu », vous venez de gâcher votre meilleur emplacement.
Ce que ça donne par type de page
Le découpage ne se traite pas pareil selon ce que vous publiez.
Sur une fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées., le bloc citable, c'est la combinaison caractéristique + valeur + contexte d'usage, rédigée en phrases, pas en tableau d'attributs. Un tableau de specs s'extrait mal ; la même info reformulée en trois phrases sous un H3 « À qui s'adresse ce modèle » se fait citer.
En page catégorie e-commerce, le seul chunk exploitable est le bloc éditorial. Planqué sous la grille produits ou replié dans un accordéon chargé en JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche., il n'existe pas. Remontez-le, ou au minimum servez-le dans le HTML initial.
Pour un article de fond, isolez une définition, un seuil chiffré et une méthode par section. Trois chunks candidats valent mieux qu'un développement de 800 mots impossible à découper proprement.
Page tarifs : écrivez les prix en toutes lettres dans le texte, avec la date de mise à jour dans la phrase. « Au 1ᵉʳ septembre 2026, l'offre démarre à X euros par mois » se cite. Un widget de pricing dynamique ne se cite pas.
Et sur une comparative, chaque alternative mérite son H3 nominatif. Les réponses IA piochent souvent une seule ligne d'un comparatif pour la reverser dans une synthèse plus large : autant que cette ligne porte le nom de l'entité.
Le corollaire est désagréable pour beaucoup de sites : le chantier ressemble davantage à une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. de templates qu'à un chantier éditorial. On redécoupe plus qu'on ne réécrit.
Le référencement sur Perplexity commence par le crawl

Côté technique, la moitié des sites que je vois se plaindre de leur invisibilité IA se bloquent eux-mêmes.
PerplexityBot, robots.txt et WAF
Autorisez explicitement PerplexityBot et Perplexity-User dans votre robots.txt. Un Disallow: / hérité d'une prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.éprod, ou des règles anti-scraping ajoutées en 2024 par réflexe défensif, coupent la citation à la racine.
Mais le blocage le plus fréquent vient du WAF. Cloudflare, Akamai et consorts ont ajouté des règles de bot management qui renvoient un 403 aux crawlers IA par défaut. Ça ne se voit ni dans la Search Console, ni dans vos logs applicatifs si vous ne regardez que les 200. Filtrez vos logs serveurFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots. sur le user-agent, regardez le code de réponse. Du 403 ou du 429, et vous avez votre diagnostic avant même de parler de contenu.
Le rendu et la fraîcheur
Le contenu injecté côté client, c'est un pari. Pas forcément perdu, mais un pari : vous ne savez pas quel fragment sera récupéré, ni comment la page sera rendue au moment du crawl. Le HTML servi directement supprime le pari.
Sur la fraîcheur, la date affichée dans le corps de page pèse plus que le dateModified du balisage. Les deux ensemble valent mieux. Et une date de mise à jour sur un contenu qui n'a pas bougé d'une virgule, ça se repère : le modèle compare la promesse de fraîcheur au contenu réel.
Perplexity vs Google, Bing et ChatGPT : ce qui change vraiment

Perplexity n'est pas « meilleur » que Google. Il répond à un autre moment du parcours. Google reste le moteur de découverte et de navigation ; Perplexity intervient en phase de comparaison et de décision, avec un utilisateur qui arrive déjà informé.
| Critère | Perplexity | ChatGPTAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses. | |
|---|---|---|---|
| Unité classée | la page | le passage | le passage, plus rarement sourcé |
| Sources visibles | 10 liens bleus | bandeau de 5 à 10 sources citées | citations partielles selon le mode |
| Poids de la fraîcheur | variable selon la requête | filtrant sur les sujets datés | dépend de l'activation de la recherche web |
| Volume de trafic renvoyé | élevé | faible mais qualifié | faible, souvent sans clic |
Bing sert encore à quelque chose
Perplexity s'appuie sur son propre crawler et sur des index tiers, et les signaux de classementPosition d'une page web dans les résultats de recherche pour une requête donnée. classiques restent une des entrées de sa sélection de sources. Traduction opérationnelle : Bing Webmaster ToolsOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. mérite dix minutes de votre temps, ne serait-ce que pour pousser vos URLs via IndexNow. Question éligibilité, pas trafic.
Le KPI, c'est la citation
Les volumes venus des moteurs de réponse restent marginaux comparés à l'organique classique. L'étude Semrush sur l'impact de la recherche IA documente cette asymétrie : peu de sessions, mais un profil d'intention nettement plus avancé. Jugez votre Perplexity SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. au nombre de visites et vous couperez le budget avant d'avoir vu l'effet.
Mesurer vos citations Perplexity sans outil magique

Personne n'explique jamais comment savoir si ça marche. Le protocole tient dans une feuille de calcul.
Construisez un panel de prompts, pas une liste de mots-clés
Trente à cinquante prompts, rédigés comme un humain parle à un assistant, répartis en trois familles.
Les prompts de marque interrogent votre nom directement : « que vaut [marque] », « [marque] avis », « alternatives à [marque] ». Ils mesurent votre réputation et le contrôle de votre narratif.
Viennent ensuite les prompts de catégorie, qui ne contiennent pas votre nom : « quel logiciel de facturation pour une PME française », « comment choisir un prestataire X ». Ce sont eux qui portent l'acquisition, et c'est là que la plupart des marques sont absentes.
Dernière famille, les prompts de comparaison, qui mettent en jeu deux acteurs nommés dont au moins un concurrent. Ils révèlent la façon dont le modèle vous positionne quand il doit trancher.
Ce que vous loggez à chaque run
Même jour de la semaine, même heure, session déconnectée pour éviter la personnalisation, langue et localisation françaises. Une passe hebdomadaire suffit. Une passe quotidienne produit du bruit que vous ne saurez pas interpréter.
| Prompt | Cité | Rang source | URL citée | Concurrents cités |
|---|---|---|---|---|
| logiciel facturation PME France | non | - | - | acteurA, acteurB |
| avis [marque] | oui | 2 | /tarifs/ | acteurA |
| [marque] vs acteurA | oui | 5 | /blog/comparatif/ | acteurA, acteurC |
De ce tableau sortent quatre KPIKey Performance Indicator. Indicateurs clés mesurant l'efficacité d'une stratégie SEO. qui suffisent à piloter : le taux de présence par famille de prompts, votre part de citation face aux concurrents sur les prompts catégorie, le nombre d'URLs distinctes citées sur votre domaine (votre surface citable réelle), et la proportion de réponses où votre marque est mentionnée dans le texte sans lien vers votre site. Cette dernière ligne compte : une mention nue construit de la notoriété que vous ne verrez jamais dans GA4.
L'arbre de décision qui sort de vos données
Présent sur les prompts de marque, absent sur les prompts de catégorie : votre notoriété va bien, mais vous n'avez pas de contenu non-marqué qui réponde à l'intention d'achat. Chantier éditorial.
Absent partout alors que vous êtes dans le top 10 Google sur les mêmes sujets : problème d'accès ou d'extraction. Allez voir vos logs et le rendu de vos templates avant d'écrire une ligne de plus.
Cité, mais sur une vieille URL ou une page obsolète : fraîcheur et consolidation. Vous avez probablement deux ou trois pages qui se disputent le même sujet, et le modèle a choisi la mauvaise.
Cité via un tiers (comparateur, annuaire, thread Reddit) et jamais depuis votre domaine : les sources tierces vous portent, votre site ne suit pas. Situation frustrante, mais c'est souvent le point de départ le plus rapide à exploiter.
Le protocole prend deux heures à mettre en place et vingt minutes par semaine à maintenir. Aucun outil de suivi ne vous apportera plus de finesse au démarrage, parce qu'aucun outil ne connaît vos prompts de catégorie mieux que vous.
Les formats qui se font citer, et ceux qui ne servent à rien

Les contenus qui remontent le plus souvent partagent un trait : ils contiennent une information qu'on ne peut pas paraphraser sans la source. Une méthodologie chiffrée, un comparatif nominatif, une définition opératoire, un retour de données propriétaires.
Les guides pratiques avec seuils et critères donnent au modèle une matière à recomposer. Les pages comparatives nomment les entités, donc elles se piochent facilement. Quant aux blocs de définition courte, ils s'insèrent tels quels dans une réponse.
Ce qui ne prend pas : les articles d'actualité recyclés sans angle, les pages de service en langue de bois commerciale, les contenus IA non éditorialisés qui répètent la moyenne du web. Un modèle qui cherche une source cherche une information absente de sa moyenne. Si votre contenu est la moyenne, il n'a aucune raison de vous citer.
Un point contre-intuitif : les blogs de niche très spécialisés s'en sortent souvent mieux que les gros sites généralistes. Le panorama du marché français publié par Sébastien Vallat va dans ce sens, avec des audiences très engagées et des requêtes précises où l'expertise pointue prime sur l'autorité de domaineScore (0-100) prédisant la capacité d'un domaine à se positionner. Métrique Moz, non utilisée par Google.. Acteur de taille moyenne sur un marché technique, c'est votre fenêtre.
Le GEO s'assoit sur le SEO

On vous vend le GEO comme une discipline neuve qui rendrait le SEO obsolète. Commode pour facturer une ligne de plus, et faux. Si votre indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. est bancale, votre maillage interneEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. approximatif et votre autorité thématiqueExpertise reconnue d'un site sur un sujet donné, renforcée par un contenu complet et interconnecté. inexistante, vous n'entrez même pas dans le jeu de sources que Perplexity va lire. Le GEOGenerative Engine Optimization. Optimisation pour apparaître dans les réponses des IA génératives. est une couche d'extractibilité posée sur un socle SEO qui tourne déjà.
Votre premier trimestre de GEO Perplexity

Le premier mois sert au diagnostic, pas à la production. Logs serveur filtrés sur les user-agents IA, vérification robots.txt et WAF, curl sur vos vingt pages stratégiques pour contrôler ce qui est réellement servi. Et surtout, construction du panel de prompts avec deux runs de baseline. Sans point de départ, vous ne prouverez aucune progression.
Vient ensuite le redécoupage. Prenez les dix pages qui portent votre chiffre d'affaires, réécrivez les 60 premiers mots sous chaque H2, remontez les blocs éditoriaux enterrés, sortez les FAQ des accordéons, datez ce qui doit l'être. Ajoutez le balisage FAQ et Article là où il est légitime, sans transformer votre site en sapin de Noël schema.
Le troisième mois, vous lisez les données et vous arbitrez. Si le taux de présence sur les prompts catégorie n'a pas bougé alors que le crawl est propre et les chunks refaits, le problème est ailleurs : couverture éditoriale insuffisante, ou absence de sources tierces qui vous mentionnent. Les deux se traitent, mais pas avec les mêmes équipes ni les mêmes budgets.
Reste le point qui bloque le plus souvent en interne. Si Perplexity cite votre marque sans envoyer de clic, votre dispositif de mesure est-il seulement capable de le voir ? Chez la plupart des équipes marketing que je croise, la réponse est non.
Questions fréquentes
Quelle IA est la plus utile pour travailler son SEO au quotidien ?
Aucune ne remplace un outil de données. Les modèles conversationnels servent à explorer des intentions, générer des variantes de prompts pour votre panel de suivi, ou repérer comment votre marque est décrite. Pour l'analyse de logs, le crawl et le suivi de positions, vous restez sur des outils spécialisés. Utilisez les deux, n'en remplace pas un par l'autre.
ChatGPT peut-il faire du SEO à ma place ?
Il produit de la structure, des variantes de titres, des reformulations de blocs. Il ne décide pas d'un angle, n'arbitre pas une architecture et ne vérifie aucune donnée. Le contenu IAContenu créé par intelligence artificielle. Google juge la qualité, pas l'origine. non éditorialisé se repère, par les moteurs comme par les lecteurs, et il ne se fait pas citer parce qu'il n'apporte rien qui ne soit déjà dans la moyenne du web.
Quels outils suivre pour piloter sa visibilité dans les moteurs de réponse ?
Un tableur pour votre panel de prompts, vos logs serveur pour le crawl, GA4 filtré sur les référents IA, et Bing Webmaster Tools pour l'éligibilité. Les plateformes de suivi de citations apportent du confort quand le volume de prompts devient ingérable à la main, rarement avant.
Combien de temps avant de voir un effet sur les citations ?
Les corrections d'accès (robots.txt, WAF, rendu) produisent un effet en quelques semaines, le temps que le recrawl passe. Le redécoupage éditorial met un à deux trimestres à se lire dans le taux de présence. Le plus long, c'est la couverture de sujets sur lesquels vous n'avez encore rien publié.