




Le server-side rendering (SSR), ou rendu côté serveurTechnique générant le HTML sur le serveur, facilitant l'indexation du contenu JavaScript., construit la page HTML sur le serveur à chaque requêteTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. : navigateur et robots reçoivent tout de suite le texte, les liens et les balises. Pour le SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche., Google n'attend plus l'exécution du JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. pour lire la page, et les robots d'IA qui ne l'exécutent pas la lisent enfin.
La contrepartie se paie côté serveur : un temps de réponse plus long, un cache à régler, des erreurs qui freinent l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web.. Ce guide s'adresse aux équipes marketing et tech qui choisissent un rendu ou auditent un site JavaScript. Il tranche trois questions : ce que le SSR change pour les robots, quand le prérendu fait mieux, et comment vérifier ce que reçoit vraiment un robot.
Comment fonctionne le rendu côté serveur ?
Avec le SSR, le serveur exécute le code de l'application et renvoie une page HTML déjà remplie ; le JavaScript arrive ensuite pour la rendre interactive. web.dev, le site de l'équipe Chrome, le définit comme l'affichage d'une application sur le serveur pour envoyer du code HTML au client plutôt que du JavaScript.
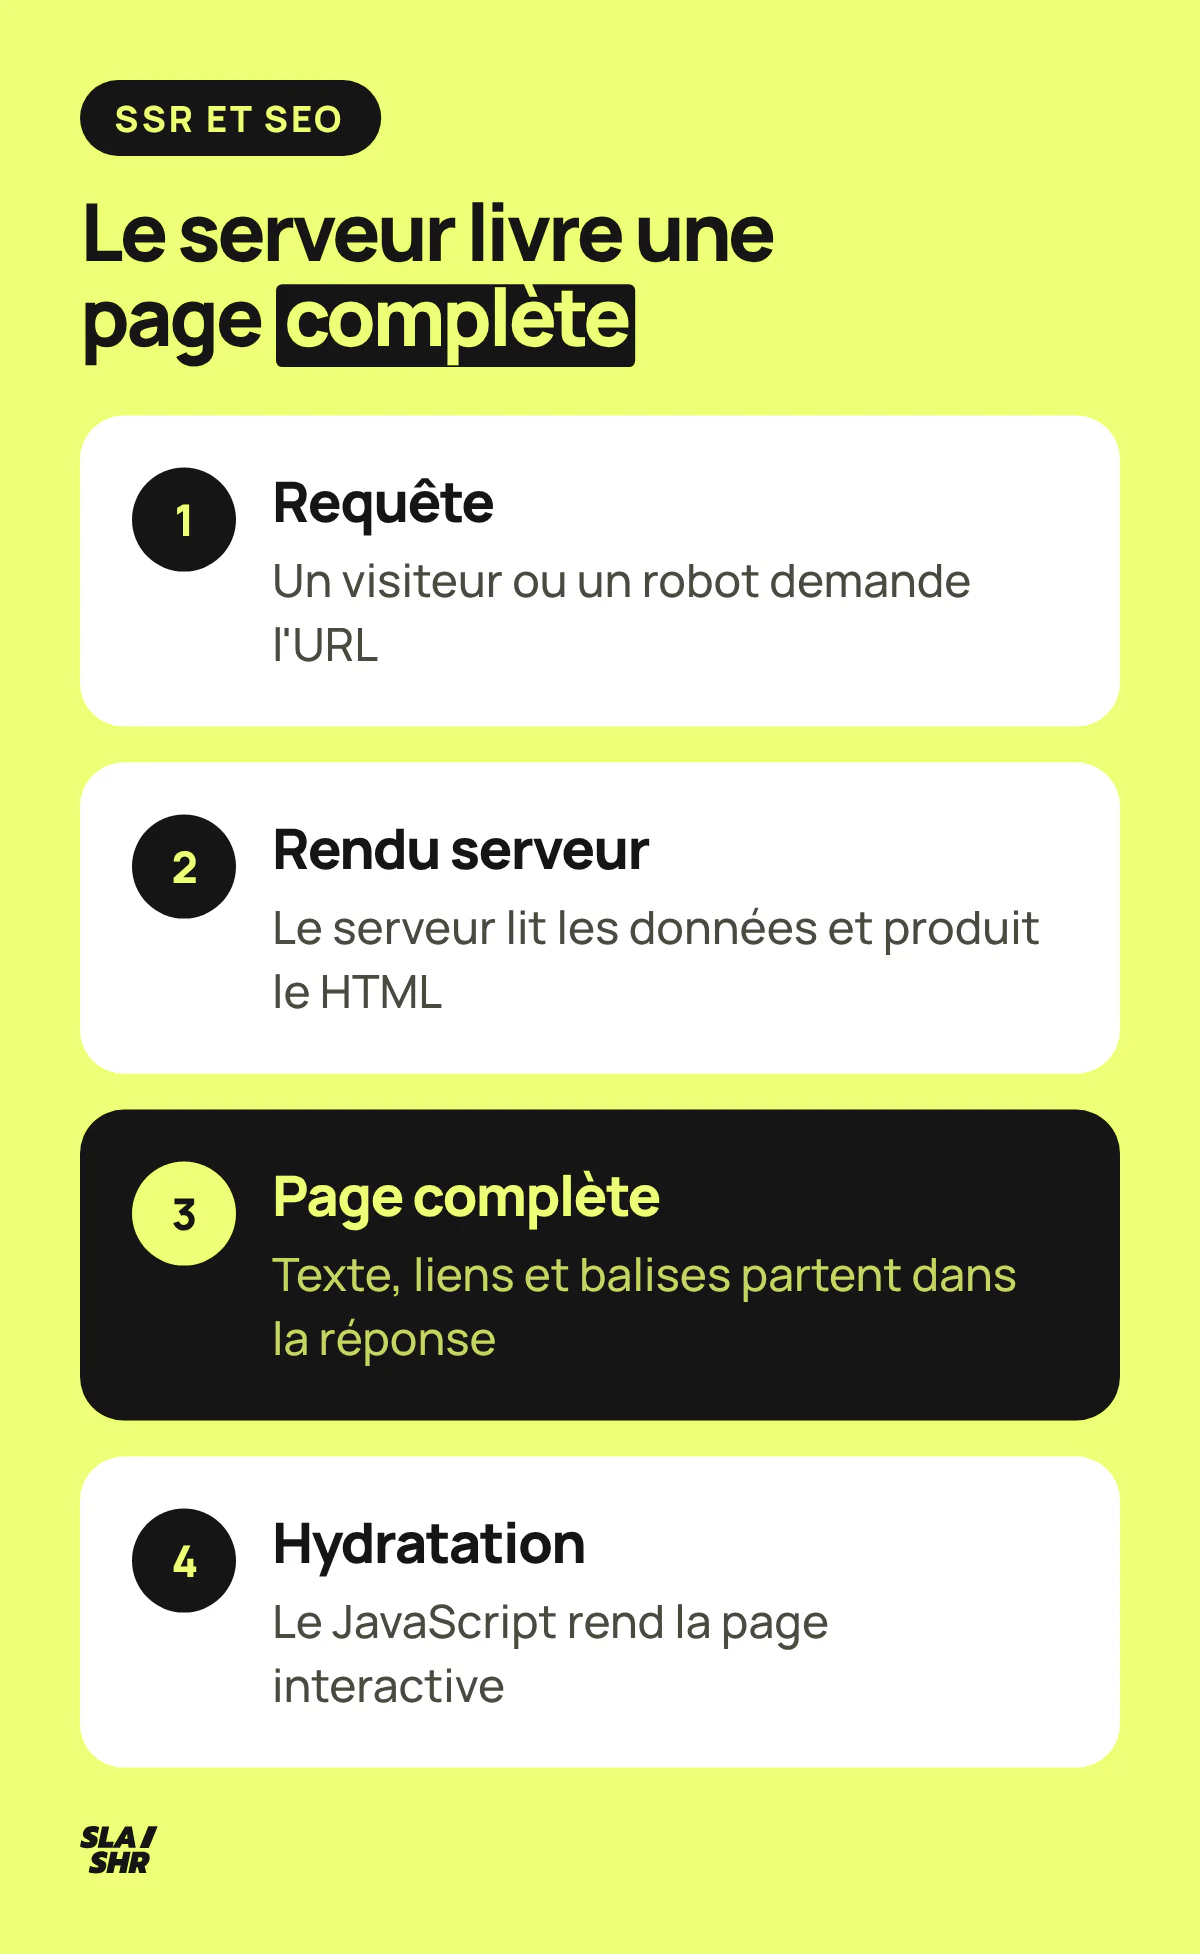
Le trajet tient en quatre temps. D'abord, le navigateur ou le robot demande une URL. Le serveur récupère les données (fiche produit, prix, article), exécute les composants et produit le HTML. La réponse part avec le contenu déjà écrit. Le navigateur télécharge enfin les scripts et les attache à ce HTML : c'est l'hydratation, qui ajoute l'état de l'application et l'interactivité.
En rendu côté client (CSR), le serveur envoie un HTML presque vide, souvent une simple <div id="root"> et des scripts, et le navigateur construit la page en JavaScript. Google appelle ce modèle un « shell d'application » : le code HTML initial ne contient pas le contenu réel, et il faut exécuter le JavaScript pour le lire.

Le principe est ancien : un site en PHP génère ses pages sur le serveur, et la documentation de Nuxt compare son rendu universel au rendu serveur traditionnel de PHP ou de Ruby. Le sujet revient avec les frameworks JavaScript (React, Vue, Angular), capables de produire la même application sur le serveur et dans le navigateur.
SSR ou rendu côté client : ce que voient Google et les robots d'IA
Google indexe les deux modes, mais pas au même moment, et la plupart des robots d'IA ne lisent que le HTML servi. Google traite les applications JavaScript en trois phases : exploration, affichage (le rendu), indexation. La première, le crawling, lit la réponse HTML du serveur et relève les URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. des attributs href.
Une page en 200 part ensuite dans une file d'attente d'affichage. Elle peut y rester quelques secondes ou plus longtemps. Puis un Chromium headless exécute le JavaScript, et GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. cherche de nouveaux liens dans le HTML rendu.
Avec le SSR, contenu et liens sont lus dès la première phase. En rendu client, ils attendent la deuxième. La documentation JavaScript de Google est nette : le rendu côté serveur ou le prérendu reste recommandé, parce que le site s'affiche plus vite pour les visiteurs comme pour les robots, et parce que tous les robots n'utilisent pas forcément JavaScript.
Ce dernier point pèse lourd avec les assistants IA. Dans l'étude publiée par Vercel et MERJ en décembre 2024, aucun des grands robots d'IA mesurés n'exécutait le JavaScript : GPTBot, OAI-SearchBot et ChatGPT-User d'OpenAIAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses., ClaudeBot d'Anthropic, PerplexityBot. Seuls GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche., qui s'appuie sur l'infrastructure de Googlebot, et AppleBot, qui rend les pages avec un robot de type navigateur, faisaient exception. Pour être cité par Perplexity, le passage qui répond doit donc figurer dans le HTML servi.
Le constat date de fin 2024 et reste à revérifier. En attendant, ne comptez pas sur ces robots pour lire un texte absent du HTML initial, ni sur les réponses qu'ils alimentent.

Le rendu client reste indexable par Google, à condition que rien ne casse le rendu. Un fichier JavaScript bloqué suffit : Google n'affiche pas le JavaScript des fichiers bloqués par le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., d'où l'intérêt de revoir la gestion du robots.txt après chaque changement de structure. Les autres erreurs fréquentes sont détaillées dans les bonnes pratiques JavaScript et SEO.
Les avantages du SSR pour le SEO
Les avantages du rendu côté serveur pour le référencement découlent tous du même fait. Le contenu est dans la première réponse.
Une indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. sans attente. Le texte, le title, la meta descriptionBalise HTML décrivant le contenu d'une page. Affichée sous le titre dans les SERP, elle influence le CTR. et la canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. sont lus à l'exploration, sans dépendre de la file de rendu. Les avis clientsÉvaluations laissées par les clients sur Google Business Profile. Facteur de ranking local. d'une fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées. en sont un bon exemple : servis côté serveur, Google les lit sans attendre la file de rendu, comme le détaille notre article sur le contenu UGC et le SEO.
Des liens découverts dès le premier passage. Le maillage présent dans le HTML part dans la file d'exploration à la première lecture. En rendu client, Googlebot ne relève ces liens qu'après le rendu.
Une page lisible par tous les robots. Vercel en tire une recommandation claire dans son étude : rendre côté serveur le contenu principal (articles, fiches produit, documentation), les métadonnées et la navigation. SSR, régénération incrémentale (ISR) et génération statique (SSG) gardent ce contenu accessible à tous les robots.
Un affichage plus rapide. Selon web.dev, le rendu côté serveur produit généralement un premier affichage du contenu (FCP) rapide. Il envoie aussi moins de JavaScript, ce qui réduit le temps de blocage et peut faire baisser l'INPInteraction to Next Paint. Mesure la réactivité aux interactions utilisateur. Remplace le FID depuis 2024., l'indicateur de réactivité des Core Web VitalsMétriques de Google mesurant l'expérience utilisateur : LCP (chargement), INP (interactivité), CLS (stabilité visuelle).. L'équipe de React le rappelle de son côté : le rendu serveur réduit la quantité de JavaScript que le visiteur télécharge avant de voir la page.

Gardez la vitesse à sa place. Google écrit que bien noter aux Core Web Vitals va dans le sens de ce que ses systèmes de classementPosition d'une page web dans les résultats de recherche pour une requête donnée. récompensent, sans garantir une bonne position. Il affiche le contenu le plus pertinent même quand l'expérience sur la page déçoit ; l'expérience compte quand plusieurs contenus utiles se valent. Le gain principal du SSR reste un contenu lu tout de suite, par tous les robots.
SSR, SSG ou ISR : quel rendu pour quelle page ?
Pour le SEO, SSR et prérendu se valent. Les deux livrent un HTML complet au robot ; ils diffèrent par le moment où ce HTML est produit, donc par le temps de réponse et le coût serveur.
La génération statique (SSG) produit le HTML au build. web.dev lui reconnaît un TTFB rapide et constant, puisque rien n'est généré à la demande, et des fichiers faciles à distribuer sur un CDN.
Sa limite : un fichier par URL, difficile à tenir quand les URL sont imprévisibles ou très nombreuses. Le SSR à la requête prend le relais pour les données en direct et les pages personnalisées, que le rendu statique gère mal. La régénération incrémentale (ISR) sert une page prérendue et la régénère : en arrière-plan à la première visite qui suit l'expiration de la période choisie, ou à la demande quand le contenu change.
| Type de page | Rendu conseillé | Pourquoi |
|---|---|---|
| Accueil, landing, article, documentation | Prérendu au build (SSG) | Contenu stable, HTML complet et TTFB court |
| Fiche produit, catégorie, annonce | SSR, ou prérendu régénéré (ISR) | Prix, stock et disponibilité changent, le HTML doit suivre |
| Recherche interne, filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. combinés | SSR, ou rendu client si la page reste hors index | Valeur SEO faible, volume d'URL élevé |
| Espace client, panier, back-office | Rendu client | Derrière un login, rien à indexer |
Un site surtout statique n'a donc pas besoin du SSR à la requête : le prérendu lui donne le même HTML, plus vite. Le rendu client ne lui suffit pas pour autant si ses pages doivent ranker et être citées.

C'est la logique que défend l'équipe de React : les frameworks permettent d'utiliser un serveur sur les pages qui en ont besoin, sans l'imposer aux autres, et les applications les plus performantes choisissent leur rendu page par page. Sur un site React, le guide SEO React applique cette grille gabarit par gabarit. Le guide Next.js SEO montre comment déclarer chaque mode avec l'App Router, de generateStaticParams à cacheLife.
Les risques SEO d'un SSR mal réglé
Un SSR mal réglé dégrade l'exploration au lieu de l'aider : réponses lentes, erreurs serveur, pages absentes servies en 200, HTML qui change à l'hydratation. Chaque risque a sa parade.
Le temps de réponse. Générer une page à chaque requête prend du temps et peut augmenter le TTFB (Time to First ByteTime To First Byte. Temps entre la requête et la réception du premier octet de réponse du serveur.), le délai avant le premier octet de la réponse. Le blog de React et web.dev le disent tous les deux. Comme repère, web.dev situe un bon TTFB à 0,8 seconde ou moins et un mauvais au-delà de 1,8 seconde. Le TTFB ne figure pas parmi les Core Web Vitals. Google le surveille pourtant pour explorer : si les temps de réponse du site, TTFB compris, s'allongent, il réduit son exploration. Sur un gros site, c'est le budget de crawl qui se resserre. La parade est connue : un cache HTML devant le rendu, et le prérendu partout où la page le permet. web.dev note que le SSR associé à une mise en cache du HTML peut réduire nettement le temps de rendu serveur.
Les erreurs 5xx. Quand le serveur de rendu tombe, toutes les pages qu'il sert renvoient une erreur. Pour Google, les codes 5xx et 429 font ralentir temporairement l'exploration ; les URL déjà indexées restent en place, puis finissent par sortir de l'index, et le contenu reçu avec un 5xx est ignoré. Surveillez ces erreurs dans le rapport « Statistiques sur l'exploration » de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. après chaque mise en production.
Les robots servis à part. Next.js 16 a un cas particulier. Avec Cache Components, il repère certains robots à leur user agent (Bingbot, Applebot, les robots Google suffixés -Google, entre autres) et leur rend la page à la requête, sans le static shell servi aux navigateurs, pour placer les métadonnées dans le <head>. Sa documentation prévient : si une source de données disponible au build manque à la requête, ce rendu peut échouer, et ces robots reçoivent une erreur 500Code HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur.. Le troisième contrôle de la section suivante teste ce chemin.

Les pages absentes servies en 200. Le SSR permet de renvoyer un vrai 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget., ce que Google juge particulièrement difficile dans une application monopage. Google peut ignorer l'affichage d'une page qui ne répond pas 200, alors qu'une page d'erreur servie en 200 risque l'indexation ou le classement en soft 404. Attention au streaming dans Next.js : un notFound() appelé après le début de la réponse laisse le code en 200 et ajoute un noindexDirective indiquant aux moteurs de ne pas indexer une page..
L'hydratation qui modifie le contenu. React attend que le rendu du navigateur soit identique au HTML du serveur et demande de traiter tout écart comme un bug. Ses causes les plus fréquentes : un test typeof window !== 'undefined' ou une API propre au navigateur dans la logique de rendu, des données différentes entre serveur et navigateur. Google indexe le HTML rendu, et les robots d'IA qui n'exécutent pas le JavaScript lisent celui du serveur : un écart entre les deux leur montre deux pages différentes.
Le rendu dynamique. Servir une version prérendue aux seuls robots et l'application aux visiteurs a longtemps servi de rustine. Google présente désormais ce rendu dynamique comme une solution de contournement déconseillée, parce qu'il ajoute de la complexité et consomme des ressources. Un contenu complètement différent entre robots et visiteurs peut en plus relever de la dissimulation (cloakingTechnique black hat affichant un contenu différent aux moteurs et aux utilisateurs. Fortement pénalisée.).
Vérifier ce que reçoit le robot en quatre contrôles
Quatre commandes suffisent pour contrôler un gabarit : balises, liens, temps de réponse, codes HTTP. Elles lisent le HTML brut, celui que reçoit un robot qui n'exécute pas le JavaScript.
URL="httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.example.com/produits/chaise-chene"

# 1. Title, H1 et canonical présents dans le HTML brut
curl -sL "$URL" | tr '\n' ' ' | grep -ioE "<title[^>]*>[^<]*|<h1[^>]*>.{0,100}|<link[^>]*canonical[^>]*>"

# 2. Nombre de liens <a href> dans le HTML brut
curl -sL "$URL" | tr '\n' ' ' | grep -ioE "<a [^>]*href" | wc -l

# 3. Code HTTP et temps de réponse, avec l'agent de curl puis celui de Bingbot
curl -s -o /dev/null -w "%{http_code}, TTFB %{time_starttransfer} s\n" "$URL"
curl -s -o /dev/null -w "%{http_code}, TTFB %{time_starttransfer} s\n" \
  -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm) Chrome/100.0.4896.127 Safari/537.36" "$URL"

# 4. Une URL inventée doit répondre 404
curl -s -o /dev/null -w "%{http_code}\n" "https://www.example.com/produits/page-qui-n-existe-pas"
Lisez d'abord le code du troisième contrôle. Un 403, ou une page de vérification anti-robots dont le title annonce un contrôle au lieu du nom de la page (« Just a moment... », par exemple), même en 200, vient de la protection du site et ne dit rien de son rendu : relancez depuis une adresse autorisée par l'équipe technique, ou passez par l'inspection d'URL de la Search Console.
Le premier contrôle doit afficher le title propre à la page, la canonical et le début du H1, balises imbriquées comprises (tr met la page sur une seule ligne, pour les H1 écrits sur plusieurs). D'autres lignes <title> peuvent suivre : ce sont les titres d'icônes SVG, seul celui de la page compte.
Un title générique, partagé par toutes les pages, et aucun H1 signalent un contenu construit en JavaScript. La commande cherche des balises, à dessein : un texte peut figurer dans un script de données sans être affiché.
Le deuxième compte les liens. Une page de catégorie qui en affiche des dizaines à l'écran et zéro dans le HTML brut construit sa navigation dans le navigateur : Googlebot ne la découvrira qu'au rendu, et les robots d'IA qui n'exécutent pas le JavaScript jamais.
Les deux premières commandes suivent les redirections (-L), les deux suivantes non, pour montrer le vrai code. Si le troisième contrôle affiche un code 3xx (301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle., 302Redirection temporaire ne transférant pas le jus SEO. À utiliser avec précaution., 307, 308), l'URL testée redirige : relancez les contrôles sur l'URL finale de la redirection.
Le troisième mesure le délai avant le premier octet. Lancez-le deux ou trois fois, le premier appel peut tomber sur un cache vide. Comparez le résultat au repère de 0,8 seconde, puis les deux lignes entre elles : un écart net signale que le robot passe par un autre chemin que le visiteur, sans cache.
Sur la seule ligne Bingbot, un 5xx signale un rendu qui échoue pour les robots, le cas Next.js décrit plus haut. Un 403 ou un autre 4xx vient le plus souvent d'un pare-feu qui vérifie l'adresse des robots, comme Google documente la vérification des siens : votre faux Bingbot ne vient pas d'une adresse de Bing. Si la règle porte sur le seul user agent, le vrai Bingbot est bloqué aussi : vérifiez-la dans les journaux du serveur.
Le quatrième doit répondre 404 ; un 3xx signale une redirection à suivre jusqu'à sa cible. Un 200 sur une URL inventée, fréquent sur une application monopage, ouvre la porte aux soft 404.

Reste le côté rendu. L'outil d'inspection d'URL de la Search Console, test en ligne puis « Afficher la page testée », montre le HTML après exécution du JavaScript, une capture d'écran et les erreurs de la console. Pour tout le site, un crawl en rendu JavaScript compare le contenu avant et après exécution, page par page : le réglage est dans notre guide Screaming Frog. Faites ces contrôles sur trois gabarits au moins : accueil, catégorie, fiche.
Passer au SSR : frameworks et chantiers
Le SSR passe aujourd'hui par un framework. Il gère le rendu serveur, le prérendu et l'hydratation, page par page.
Côté React, l'équipe a déprécié Create React App le 14 février 2025 et recommande de démarrer avec un framework : Next.js, React Router ou Expo. Next.js en est à la version 16 (16.4, publiée le 6 octobre 2026). Gatsby, qui prérend ses pages au build, ne figure pas parmi les frameworks recommandés par l'équipe React : son état en 2026 et ses réglages SEO aident à décider de rester dessus ou de migrer.
Les nouvelles applications créées avec les réglages recommandés de create-next-app activent Cache Components : la page est prérendue en « static shell », et ce qui n'est pas mis en cache arrive en streaming dans la même réponse. La documentation de Next.js précise que ce streaming, rendu côté serveur, n'a pas d'impact sur le SEO.
Côté Vue, Nuxt utilise par défaut le rendu universel, que sa documentation justifie par l'expérience utilisateurUser Experience. Qualité de l'expérience vécue par un utilisateur sur un site. Facteur de ranking indirect., la performance et l'indexation. Côté Angular, ng new --ssr crée un projet avec rendu serveur et ng add @angular/ssr l'ajoute à un projet existant ; par défaut, Angular prérend alors toute l'application, et chaque route peut passer en rendu serveur.

Le passage lui-même tient en cinq chantiers :
- Répartir les gabarits entre prérendu, SSR et rendu client avec la grille plus haut.
- Repérer le code qui suppose un navigateur (
window,localStorage,matchMedia) : sur le serveur, il casse le rendu ou crée un écart à l'hydratation. - Mettre le HTML en cache et suivre le TTFB dès la préproduction.
- Enregistrer avant la bascule le HTML brut de trois URL par gabarit, puis comparer après : title, H1, canonical, liens, codes HTTP.
- Surveiller ensuite les erreurs serveur et la vitesse d'exploration dans la Search Console.
Un tel passage change le HTML de toutes les pages en même temps : c'est une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. au sens SEO, avec son plan de recette. Slashr intervient en SEO aux côtés de l'équipe qui développe le site, dans le cadre d'un accompagnement SEO de refonte et de migration. Pour un site JavaScript déjà en ligne, l'audit du HTML servi, du rendu et des codes HTTP fait partie de notre accompagnement SEO.
Questions fréquentes
Le SSR est-il obligatoire pour être indexé par Google ?
Non. Google exécute le JavaScript et indexe la page rendue, après un passage dans une file d'attente qui peut durer de quelques secondes à plus longtemps. Il recommande quand même le rendu côté serveur ou le prérendu, plus rapides et lisibles par les robots qui n'exécutent pas le JavaScript.
Le SSR améliore-t-il le classement ?
Pas directement. Google affiche le contenu le plus pertinent même quand l'expérience sur la page déçoit, et la vitesse départage surtout des contenus de qualité proche. Le gain du SSR tient au contenu lu dès l'exploration, par tous les robots, et à un premier affichage plus rapide.
SSR ou SSG : lequel choisir pour le SEO ?
Les deux livrent un HTML complet au robot. La génération statique convient aux pages stables et répond plus vite, le SSR aux pages qui changent à chaque visite ou dépendent du visiteur. La régénération incrémentale (ISR) garde la vitesse du statique pour les fiches produit et les articles mis à jour de temps en temps.
ChatGPT et Perplexity lisent-ils un site en rendu client ?
D'après l'étude de Vercel et MERJ de décembre 2024, leurs robots n'exécutaient pas le JavaScript : ils ne lisaient que le HTML servi. Gemini et AppleBot faisaient exception. Une page en rendu client leur apparaissait donc vide ou presque.
Comment savoir si une page est rendue côté serveur ?
Récupérez son HTML brut avec curl et cherchez le title, le H1 et les liens. S'ils y sont avec leur texte, la page est rendue côté serveur ou prérendue. S'il n'y a qu'une <div> vide et des scripts, elle est rendue dans le navigateur.
Sources
- Rendu sur le Web, web.dev
- Comprendre les bases du SEO JavaScript, Google Search Central
- Rendering Modes, Nuxt : nuxt.com/docs/guide/concepts/rendering
- The rise of the AI crawler, vercel.com
- Sunsetting Create React App, react.dev
- Comprendre les signaux Web essentiels et les résultats de recherche Google, Google Search Central
- Comprendre l'expérience sur la page dans les résultats de recherche Google, Google Search Central
- Time to First Byte (TTFB), web.dev
- Gestion du budget d'exploration pour les sites volumineux, Google Search Central
- Codes d'état HTTP, erreurs réseau et DNS, Google Search Central
- Rapport « Statistiques sur l'exploration », Aide Search Console, Aide Google
- Blog de Next.js, notes de version
- Getting Started: Caching, Next.js
- Next.js, html-bots.ts (dépôt GitHub), github.com
- Résoudre les problèmes JavaScript liés à la recherche, Google Search Central
- File-system conventions: not-found.js, Next.js
- hydrateRoot, référence React DOM, react.dev
- L'affichage dynamique comme solution de contournement, Google Search Central
- Announcing user-agent change for Bing crawler bingbot, Bing Webmaster Blog
- Outil d'inspection d'URL, Aide Google
- Creating a React App, react.dev
- File-system conventions: loading.js, Next.js
- Server and hybrid rendering, Angular : angular.dev/guide/ssr
- Guides: Streaming, Next.js
- Guides: ISR, Next.js
- Validation des requêtes des robots d'exploration et des extracteurs Google, Google Search Central