




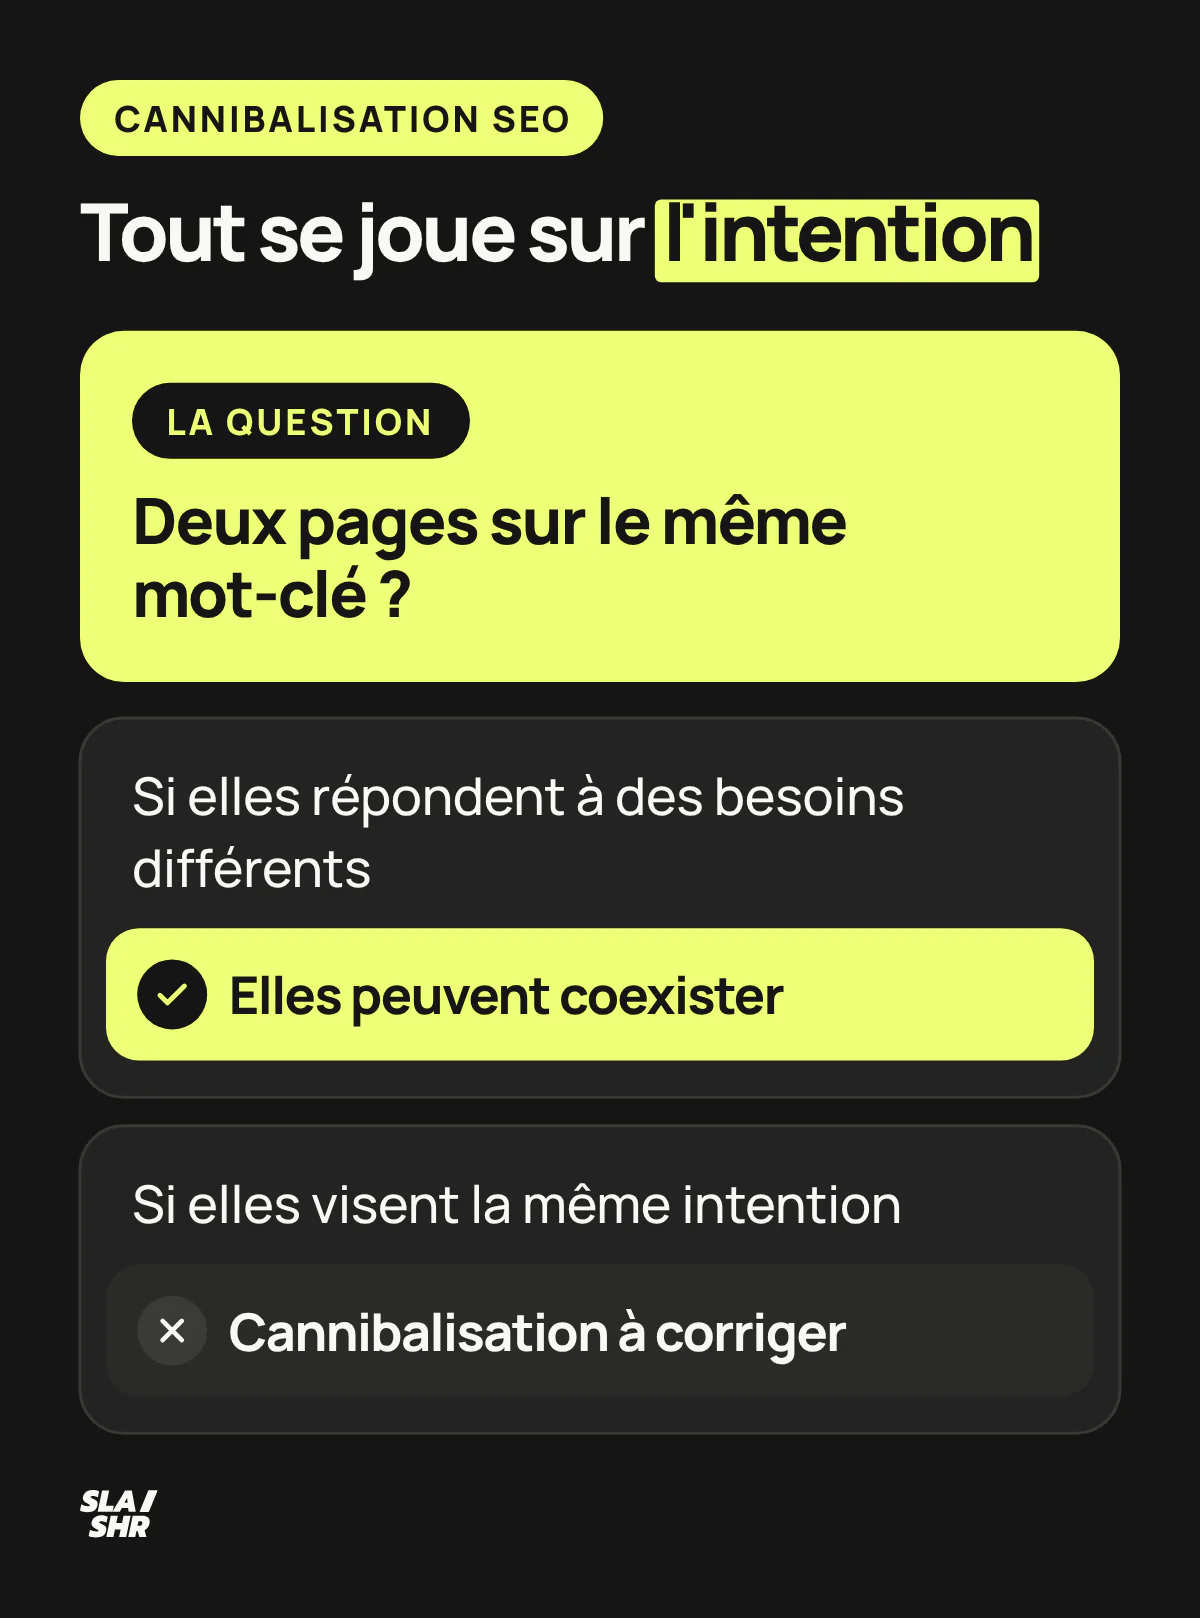
La cannibalisation SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche.Situation où plusieurs pages d'un même site se font concurrence sur les mêmes mots-clés. désigne deux pages ou plus d'un même site qui visent la même intention de rechercheObjectif réel de l'utilisateur derrière sa requête : informationnelle, navigationnelle, transactionnelle ou commerciale. : Google doit choisir entre elles, les fait alterner dans ses résultats, et aucune ne s'installe. Elle se repère dans la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche., requête par requête, et se tranche en comparant les top 10 des requêtes visées par chaque page.
Deux pages qui partagent un mot-clé peuvent très bien répondre à deux besoins. Une catégorie de chaussures de running et un guide pour bien les choisir se rangent sur deux SERPSearch Engine Results Page. Page affichée par un moteur de recherche en réponse à une requête utilisateur. différentes. Ce guide s'adresse aux sites qui publient depuis quelques années, e-commerce en tête, où les articles du blog finissent par croiser les catégories et les fiches produits.
Cannibalisation SEO : deux pages pour une seule intention
On parle de cannibalisation quand plusieurs pages d'un même site répondent au même besoin, si bien que Google n'a aucune raison stable de préférer l'une à l'autre. Les outils disent aussi « cannibalisation des mots-clés » (keyword cannibalization en anglais). Le terme trompe un peu : le mot-clé partagé est le symptôme, le besoin partagé est le problème.
La cannibalisation se distingue du contenu dupliqué. Le contenu dupliqué, c'est un même contenu servi par plusieurs URL : versions HTTP et HTTPS, tri et filtrage d'une page catégorie, paramètres de suivi. Google le juge normal : il n'enfreint pas ses règles sur le spam. Il regroupe ces URL et en retient une, la page canonique.
La cannibalisation touche des pages écrites séparément, avec des textes différents, qui visent pourtant la même réponse. Les deux se rejoignent quand deux articles sont presque des copies l'un de l'autre.
Prenons un exemple réel. Le 13 octobre 2026, sur Google France, « chaussures running homme » et « comment choisir chaussures running homme » ne partageaient qu'une URL sur leurs premiers résultats. Intersport et Decathlon étaient classés sur les deux requêtes, chacun avec deux pages : sa catégorie sur la première, son guide d'achat sur la seconde. Leurs pages se complètent, chacune tient sa SERP.

Le conflit commence quand le guide vise lui aussi « chaussures running homme » dans son title, son H1 et les ancres qui pointent vers lui. Ou quand une fiche produit reprend la requête générique de sa catégorie, cas fréquent sur les pages transactionnelles : le guide pour optimiser une page catégorie détaille comment lui faire viser les requêtes génériques du catalogue, du H1Balise HTML du titre principal d'une page. Il ne doit y en avoir qu'un seul par page. au title.
Le conflit arrive rarement par choix : des contenus publiés sans plan d'ensemble, plusieurs rédacteurs qui ignorent ce qui existe, un site qui grandit pendant des années sans que personne ne relise qui vise quoi.
Pourquoi deux pages sur la même intention se nuisent ?
Quand vos pages répondent au même besoin, c'est Google qui choisit laquelle montrer, requête après requête. Il affiche en général au plus deux pages d'un même site dans ses premiers résultats. Il peut retenir la page la moins utile pour vous : un article de blog remonte à la place de la catégorie, et l'internaute qui voulait acheter atterrit sur un guide.
Les signaux se partagent aussi. Les liens externes et les liens internesEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. se répartissent entre deux URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. au lieu de se concentrer sur une seule. Google le dit à propos des pages en double : une redirection ou une canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. lui permet de regrouper les signaux des URL individuelles, comme les liens, en une seule URL favorite. Sans ce regroupement, chaque page garde les siens.
Viennent ensuite les effets de pilotage. Les positions passent d'une URL à l'autre, les rapports deviennent illisibles et chaque mise à jour du contenu se fait deux fois.
Le budget de crawlNombre de pages que Googlebot peut et veut crawler sur un site dans un temps donné. revient souvent dans les listes d'effets. Il ne concerne vraiment que les gros sites, ou ceux qui accumulent les URL découvertes et non indexées.
Le guide de Google sur le sujet vise les sites de plus d'un million de pages uniques dont le contenu change chaque semaine, ceux de plus de 10 000 pages qui changent chaque jour, et ceux qui accumulent les URL « Détectée, actuellement non indexée ».
Le guide du crawl budget en SEO détaille ce cas. Si votre site n'a pas un grand nombre de pages qui changent vite, Google estime que ce guide ne vous concerne pas : un sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. à jour et un œil sur le rapport d'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. des pages suffisent.

Une exception se défend : deux pages en positions 1 et 2 sur la même requête, chacune sur un besoin différent, par exemple un comparatif et une page transactionnelle. C'est le maximum que le système de diversité des sites laisse en général à un même site. Si la situation est voulue et que les deux pages convertissent, gardez-la et suivez-la.
Repérer la cannibalisation dans la Search Console
La Search Console montre, pour une requête donnée, toutes les pages de votre site qui ont obtenu des impressionsNombre de fois qu'une page apparaît dans les résultats de recherche, qu'elle soit cliquée ou non. : c'est le point de départ le plus fiable, parce qu'il part des requêtes réelles.
La manipulation tient en trois étapes :
- Ouvrez le rapport Performances (les trois derniers mois par défaut).
- Cliquez sur « + Ajouter un filtre », choisissez Requêtes, puis « Personnalisé (expression régulière) », et saisissez la requête entre
^et$:^chaussures running homme$. Sans ces deux signes, la correspondance est partielle. - Passez sur l'onglet Pages : chaque URL du site qui est apparue sur cette requête s'affiche avec ses clics, ses impressions et sa position.
L'option « Requêtes contenant » paraît plus simple, mais elle cherche une chaîne : « chaussures running homme » y ramasse aussi « comment choisir chaussures running homme ». Le guide d'achat sortirait alors au coude-à-coude avec la catégorie, sur des requêtes qui ne sont pas les mêmes.
Lisez ensuite la répartition. Une URL qui prend l'essentiel des impressions, et une autre qui en capte quelques-unes : rien à faire. Deux URL au coude-à-coude, ou la page que vous voulez voir ranker reléguée derrière une page secondaire : c'est une cannibalisation potentielle, à confirmer par le test de la section suivante. Testez d'abord vos requêtes à enjeu commercial, puis celles où une de vos pages se trouve entre les positions 4 et 20.

Un piège de lecture : le graphique agrège les données par propriété, et deux résultats du même site sur une même requête n'y comptent que pour une impression. Le tableau de l'onglet Pages, lui, compte page par page. Les totaux ne concordent donc pas, et c'est normal.
Les autres moyens de repérer des conflits
La requête site:votresite.fr "chaussures running homme" dans Google liste vos pages indexées qui contiennent l'expression. C'est un bon réflexe avant de publier, avec deux limites : Google prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.évient que la liste n'est pas exhaustive, et elle montre ce qui est indexé, sans rien dire du classement sur la requête.
Les outils payants industrialisent le repérage.
Dans SemrushSuite d'outils SEO complète pour l'analyse concurrentielle, les mots-clés et le suivi de positions., le rapport Cannibalization de l'outil Position Tracking signale les mots-clésTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. pour lesquels plusieurs pages du site sont dans le top 100 de Google, avec une vue par pages, une vue par mots-clés et un score de santé ; il ne couvre que les mots-clés suivis dans la campagne.
Screaming FrogLogiciel de crawl permettant d'auditer techniquement un site web. repère les pages quasi identiques : l'option Near Duplicates, à activer, compare les pages indexables avec un seuil de similarité de 90 % par défaut, et ses résultats s'affichent après l'analyse de fin de crawl. Elle trouve les copies ; un conflit d'intention entre deux textes différents lui échappe.
Sans abonnement, notre outil gratuit d'analyse de cannibalisation fait ce tri sur un fichier CSV d'une ligne par requête et par page, tiré de l'API de la Search Console ou d'un outil de suivi de positions.
Reste la recherche dans votre CMS : tapez le sujet dans le moteur du back-office et relisez les titres qui sortent. Sur un blog de plusieurs centaines d'articles, c'est souvent là qu'apparaît le troisième article sur le même thème.
Fusionner ou garder deux pages : le test des deux top 10
Pour trancher, comparez les dix premiers résultats des requêtes visées par chaque page : à partir de 5 URL communes sur 10, Google sert à peu près la même réponse aux deux requêtes et une seule page suffit en principe ; en dessous, les deux besoins sont distincts et chaque page garde sa place.
La méthode :
- Pour chaque page en conflit, notez la requête qu'elle vise : celle de son title et de son H1, ou celle qui lui apporte le plus d'impressions dans la Search Console.
- Tapez les deux requêtes dans Google, en navigation privée et sur le même pays, ou passez par notre comparateur de SERP, qui fait aussi le compte de l'étape suivante.
- Comptez les URL identiques entre les deux top 10. Comptez des URL exactes : un même domaine classé avec deux pages différentes ne compte pas.
- Cinq URL communes ou plus : même intention, une seule page. Moins de cinq : deux intentions, deux pages à différencier et à lier.
Le seuil de cinq est une convention de travail de l'agence ; Google n'en publie aucun. Il se nuance comme pour la moyenne traîne et ses variantes longues : même avec cinq URL communes, regardez si les pages du top 10 répondent au mot qui change le besoin. Si aucune n'y répond, la variante peut mériter sa page. Sur des résultats instables, refaites le test quelques jours plus tard avant de trancher.
Les deux cas se rencontrent en vrai. Le duo « chaussures running homme » et « comment choisir chaussures running homme » n'avait qu'une URL commune : deux besoins, deux pages, et le travail porte sur le ciblage de chacune. À l'inverse, le 13 octobre 2026, « article seo » et « rédaction article seo » partageaient 5 URL sur les 9 premiers résultats organiques : une seule page les couvre, notre guide pour rédiger un article SEO.

Le positionnementPosition d'une page web dans les résultats de recherche pour une requête donnée. actuel de vos pages ne tranche rien. Une page en position 30 peut viser le bon besoin avec un contenu trop faible ; une autre en position 8 peut ranker faute de mieux. Le top 10 dit comment Google lit le besoin, vos positions disent seulement où vous en êtes. C'est le même test que pour regrouper des requêtes dans une recherche et analyse de mots-clés SEO, appliqué à des pages qui existent déjà.
Quand le test conclut à la fusion, choisissez la page à garder sur trois critères : le format que montre le top 10 (des catégories ou des guides), les liens externes reçus, puis le trafic et les conversionsAction souhaitée accomplie par un visiteur (achat, inscription, contact). Objectif ultime du SEO. des derniers mois.
Corriger : le levier dépend du diagnostic
Même intention, on fusionne et on redirige ; deux besoins, on réécrit et on maille ; doublon technique, on pose une canonical ; tris et filtres sans demande, on coupe leur explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web..

Même intention : fusionner puis rediriger en 301
Reprenez dans la page gardée ce que l'autre avait d'utile : une section, un exemple, une question de FAQ, une donnée. Puis redirigez l'ancienne URL en 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. vers elle. Google lit une redirection permanente comme le signal que la cible doit devenir la page canonique, et conseille de ne l'utiliser que lorsqu'on abandonne une page en double. La syntaxe selon votre serveur (Apache, nginx, PHP) et le test au curl sont dans le guide de la redirection 301.
Mettez ensuite à jour les liens internes qui pointaient vers l'ancienne page : chaque lien vers une URL redirigée ajoute un saut, et les chaînes de redirections se repèrent et se cassent en quelques étapes. Retirez l'URL redirigée du sitemap. Et laissez la redirection en place : pour une migration, Google conseille de garder les redirections au moins un an, le temps de transférer les signaux.
Deux besoins : différencier et mailler
Chaque page reprend dans son title et son H1 la requête de sa propre SERP. La page secondaire retire la requête principale de son title, de son H1 et des ancresTexte cliquable d'un lien hypertexte. Doit être descriptif et pertinent. qui pointent vers elle. Travaillez des variantes et la longue traîneExpressions de recherche longues et spécifiques (3+ mots) avec moins de volume mais un meilleur taux de conversion. propre à son besoin, sans les empiler : répéter des mots-clés pour ranker relève de l'accumulation de mots clés, l'une des techniques black hat que visent les règles anti-spam de Google.
Ajoutez un lien de la page secondaire vers la page principale, avec une ancre qui décrit ce qu'elle apporte. Et tenez une règle simple dans le maillage : une même ancre pointe vers une seule page.
Sur un sujet qui compte des dizaines de pages, c'est la logique du cocon sémantique, où chaque page fille renvoie vers la page pilier. Sur un catalogue rangé par rubriques, le siloing SEO garde la plupart des liens dans chaque rubrique : vérifiez alors que deux silos voisins ne visent pas la même requête.
Canonical pour les doublons techniques, robots.txt pour les tris et filtres sans demande
Une même page joignable par plusieurs URL (paramètres de suivi, variantes d'URL de la même page) relève de la canonical. Sur chaque variante, la balise désigne l'URL à garder, dans le <head> :
<link rel="canonical" href="httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.votresite.fr/page-principale" />
Google la traite comme un signal fort, sans garantie : il peut retenir une autre page canonique. Réservez-la aux pages dont le contenu principal est le même ; entre deux articles aux textes différents, la fusion ou la différenciation règlent le problème. Le guide de la balise canonical couvre sa mise en place et les erreurs courantes.
Les URL de tri et de filtres suivent une autre règle. Celles qui n'ont pas à être explorées (tris, filtres que personne ne recherche) se coupent dans le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., ou passent en fragments d'URL (après un #) : ce sont les deux méthodes que Google recommande pour la navigation à facettesSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO.. Il juge la canonical et le nofollowAttribut indiquant aux moteurs de ne pas suivre un lien ou de ne pas transmettre de jus SEO. en général moins efficaces à long terme que le robots.txt ou le fragment pour ces URL. Un filtre qui répond à une vraie recherche, lui, peut rester explorable et indexable.
Les tris et les filtres à couper qui sont déjà indexés passent d'abord en noindexDirective indiquant aux moteurs de ne pas indexer une page., sur une page laissée explorable, puis en Disallow une fois sortis de l'index. S'ils sont bloqués trop tôt, GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. ne lit pas leur noindex et ils peuvent rester dans les résultats.
Et le noindex ?
Google déconseille d'utiliser le noindex pour choisir la page canonique au sein d'un site : la page disparaîtrait complètement des résultats. Le noindex convient à une page qui doit rester en ligne sans avoir de rôle dans Google (page de remerciement, archive interne). Il sert aussi de première étape pour sortir de l'index des URL de tri ou de filtres. Il ne marche que si la page reste explorable : un Disallow dans le robots.txt empêcherait Googlebot de le lire.
Éviter la cannibalisation avant de publier
Le garde-fou tient en deux contrôles avant chaque nouvelle page : une requête cible par URL dans un fichier de mapping, et le test des deux top 10 contre la page la plus proche du site.
Le fichier de mapping associe chaque URL à une requête principale, une intention et un type de page (catégorie, fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées., article, page service). On l'ouvre avant d'écrire un brief. Si la requête y figure déjà, on travaille la page existante.
Ouvrez aussi la Search Console sur la requête : une page qui y apparaît déjà entre les positions 4 et 20 se met à jour avant d'en écrire une nouvelle. Si une page proche existe sans viser exactement la requête, faites le test des deux top 10 : 5 URL communes ou plus, la nouvelle idée devient en principe une section de la page existante.
Après la mise en ligne, posez la nouvelle page dans le maillage avec ses propres ancres, puis revenez quelques semaines plus tard sur l'onglet Pages de la requête : une seule URL doit y prendre les impressions.

L'architecture compte aussi. Une page tag qui reprend le nom d'une catégorie fabrique un concurrent sans que personne n'ait écrit une ligne. Des URL de tri, ou de filtres que personne ne recherche, laissées ouvertes à l'exploration fabriquent des doublons : coupez-les dans le robots.txt, après un noindex si elles sont déjà indexées.
Pour démarrer, prenez vos dix requêtes qui comptent le plus, passez-les dans l'onglet Pages de la Search Console, et faites le test des deux top 10 sur chaque paire suspecte. Sur un site de plusieurs milliers de pages, le tri se fait par lots ; vous pouvez confier ce chantier à notre agence SEO à Lille.
Questions fréquentes
Deux pages en positions 1 et 2, est-ce de la cannibalisation ?
Pas si elles répondent à deux besoins différents, par exemple un comparatif et une page produit. Google affiche en général au plus deux pages d'un même site dans ses premiers résultats : ce doublé occupe toute la place qu'un site obtient d'ordinaire. Il devient un problème quand les deux pages disent la même chose et alternent d'un jour à l'autre.
Quelle différence entre cannibalisation et contenu dupliqué ?
Le contenu dupliqué est un même contenu servi par plusieurs URL, que Google regroupe en choisissant une page canonique. La cannibalisation oppose des pages aux textes différents qui visent le même besoin. Le premier se règle surtout par la canonical ou la redirection, la seconde par la fusion ou la différenciation. Les URL de tri et les filtres sans demande suivent une autre règle : leur exploration se coupe dans le robots.txt, après un noindex si ces URL sont déjà indexées.
Faut-il toujours rediriger une page cannibalisée ?
Non. La 301 sert quand le test des deux top 10 conclut à une même intention et que la page redirigée a été fusionnée dans l'autre. Si les deux requêtes ont moins de 5 URL communes, les deux pages gardent leur place : réécrivez leur ciblage et liez-les.
Une catégorie et une fiche produit peuvent-elles se cannibaliser ?
Oui, quand la fiche reprend la requête générique de la catégorie dans son title et son H1. La catégorie vise la famille de produits (« chaussures running homme »), la fiche vise le modèle. Ramenez chaque page à son niveau et faites pointer les fiches vers leur catégorie.
Sources
- En quoi consiste le choix de l'URL canonique ?, Google Search Central
- Guide des systèmes de classement dans la recherche Google, Google Search Central
- Spécifier une URL canonique avec rel="canonical" et d'autres méthodes, Google Search Central
- Gestion du budget d'exploration, Google Search Central
- Rapport sur les performances (résultats de la Recherche) : vue d'ensemble et configuration de base, Aide Google
- Rapport sur les performances (résultats de recherche) : filtrage et comparaison avancés, Aide Google
- Comment utiliser l'opérateur de recherche "site", Google Search Central
- Position Tracking Cannibalization Report, semrush.com
- SEO Spider Configuration, screamingfrog.co.uk
- Migrations de sites, Google Search Central
- Règles concernant le spam dans la Recherche sur le Web Google, Google Search Central
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Gérer l'exploration des URL de navigation à facettes, Google Search Central