




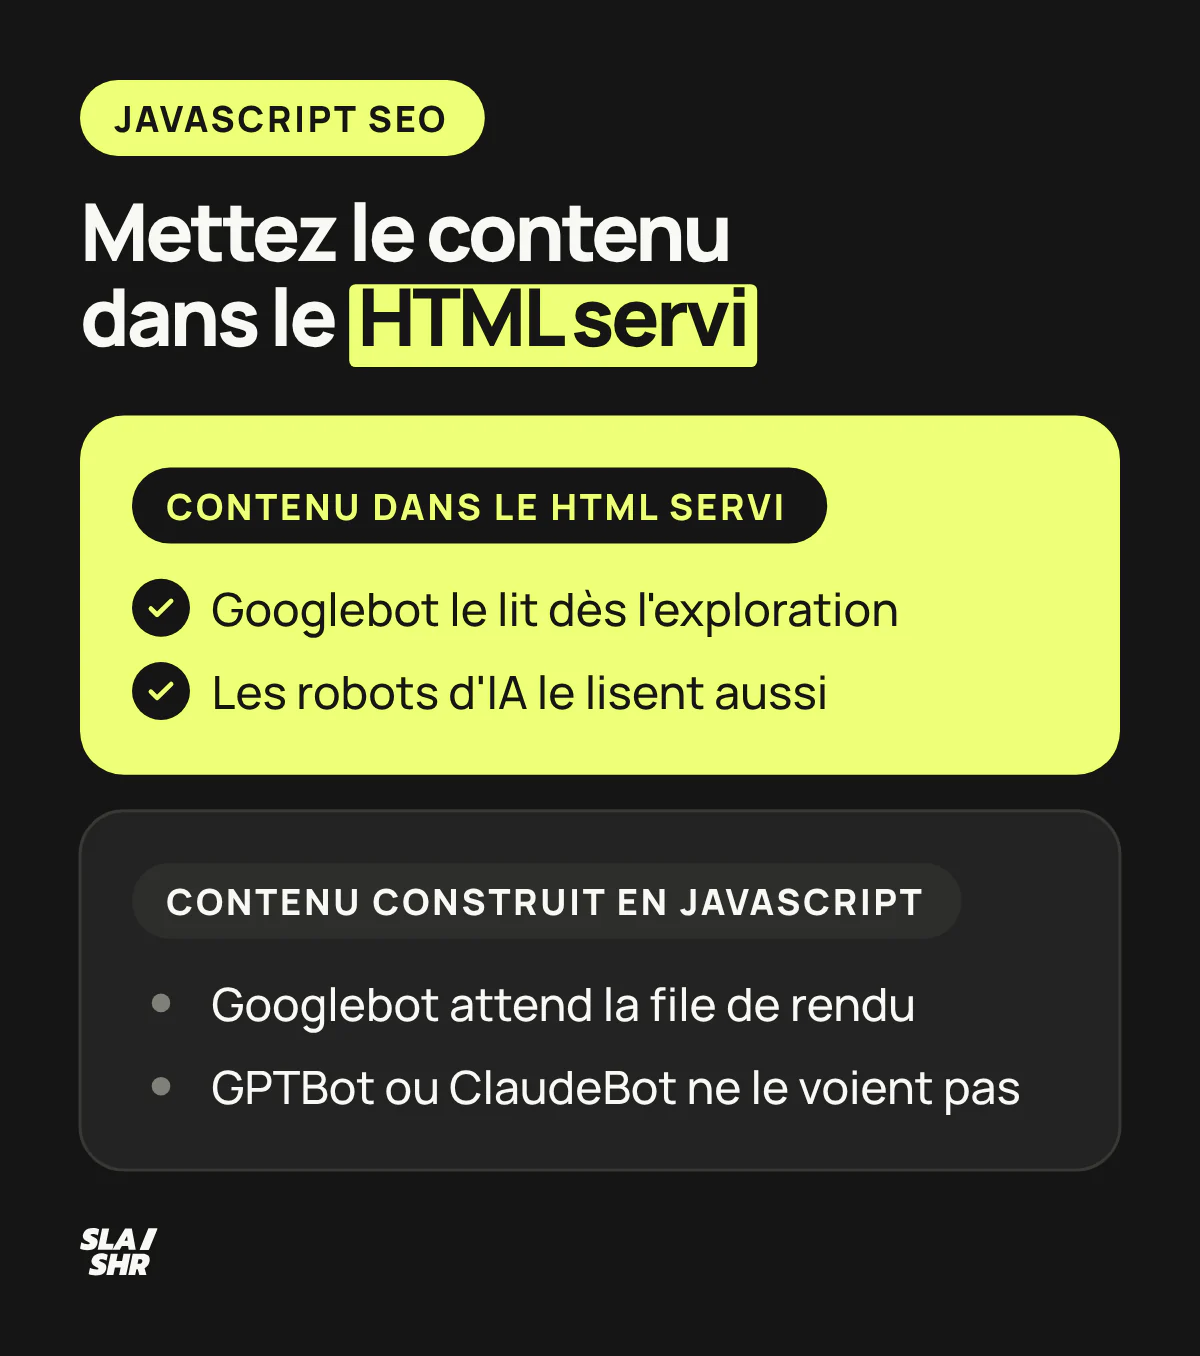
Google indexe les pages construites en JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche., mais en deux temps : il lit d'abord le HTML servi, puis exécute les scripts quand sa file de rendu le permet. La plupart des robots d'IA s'arrêtent à la première étape. Un site JavaScript se référence donc bien quand le contenu, les liens <a href> et les balises figurent dans le HTML servi, et qu'aucune erreur ne casse le rendu.
Ce guide s'adresse aux équipes SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. et aux développeurs d'un site en React, Vue, Angular, ou d'un CMS chargé de scripts. Il décrit ce que Google fait vraiment du JavaScript, les huit erreurs qui coûtent l'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats., et une méthode en trois commandes pour comparer le HTML brut et la page rendue.
Comment Google traite-t-il une page en JavaScript ?
Google traite une page JavaScript en trois phases : exploration, affichage (le rendu), indexation. Le contenu du HTML servi est lu dès la première. À l'exploration, Googlebot vérifie d'abord le robots.txt, lit la réponse HTML du serveur et ajoute à sa file les URL trouvées dans l'attribut href des liens.
Toutes les pages qui répondent 200 partent ensuite dans une file d'attente d'affichage, sauf si une balise ou un en-tête robots demande de ne pas les indexer. Google précise qu'une page peut y rester quelques secondes ou plus longtemps. Un Chromium headless exécute alors le JavaScript, Googlebot relève les nouveaux liens du HTML rendu, et c'est ce HTML rendu qui sert à l'indexation. Une page en 404 ou en erreur peut ne pas être rendue du tout.

Combien de temps dure l'attente ? La mesure la plus solide vient de Vercel et de MERJ, un cabinet de conseil SEO et data, publiée le 31 juillet 2024. Sur plus de 37 000 rendus de Googlebot rapprochés de leur exploration sur nextjs.org en avril 2024, le délai médian était de 10 secondes. Un quart des pages attendait plus de 26 secondes, 10 % environ 3 heures ou plus, et 1 % environ 18 heures ou plus.
Le périmètre compte : l'étude porte sur nextjs.org, où elle compte plus de 100 000 passages de Googlebot en un mois, et note que les URL à paramètre ?ref= et une section qui change peu attendaient plus longtemps. Sur ces passages, hors erreurs et pages non indexables, toutes les pages HTML avaient été rendues en entier. Le rendu reste donc surtout un délai, et un point où la page peut casser.

Le navigateur de Google n'est plus en retard sur le vôtre : depuis mai 2019, Googlebot utilise la dernière version de Chromium et la met à jour régulièrement. Les pièges viennent de ce qu'un robot ne fait pas comme un visiteur.
Googlebot arrive sans mémoire : le stockage local, le stockage de session et les cookies sont effacés à chaque chargement. Une page qui affiche un contenu selon une préférence enregistrée lui montre donc la version par défaut. Il refuse les demandes d'autorisation (caméra, géolocalisation). Il ne gère pas les WebSockets ni WebRTC. Et il met les fichiers en cache de façon agressive, quitte à ignorer vos en-têtes de cache.
Bing, ChatGPT, Perplexity : qui exécute le JavaScript ?
Bing exécute aussi le JavaScript ; la plupart des robots d'IA, eux, s'en passent. Bing a annoncé en octobre 2019 qu'il rendrait les pages avec le moteur de Microsoft Edge, en suivant sa dernière version stable. Google rappelle de son côté que d'autres moteurs peuvent choisir d'ignorer le JavaScript.
Chez les assistants IA, le constat est net. Dans l'étude publiée par Vercel et MERJ en décembre 2024, aucun des grands robots d'IA mesurés n'exécutait le JavaScript : GPTBot, OAI-SearchBot et ChatGPT-User d'OpenAI, ClaudeBot d'Anthropic, PerplexityBot. Deux exceptions seulement : Gemini s'appuie sur l'infrastructure de Googlebot, et AppleBot rend les pages avec un robot de type navigateur.

Le constat date de fin 2024 et reste à revérifier. En attendant, un paragraphe absent du HTML servi reste invisible pour les robots de ChatGPT et de Perplexity mesurés par l'étude, et a peu de chances d'être cité dans leurs réponses. C'est l'argument le plus fort pour servir le contenu côté serveur, plus que le délai de rendu de Google.
Quel rendu choisir : SSR, prérendu ou rendu client ?
Pour le SEO, le rendu côté serveur (SSR) et le prérendu se valent : les deux livrent un HTML complet au robot. Le SSR construit la page à chaque requête, le prérendu (génération statique, SSG) la produit une fois, au build. Le rendu côté client (CSR) envoie une coquille presque vide, que le navigateur remplit en JavaScript. C'est lui qui pose problème.
L'hydratation désigne l'étape où les scripts du navigateur se branchent sur le HTML rendu par le serveur pour lui ajouter l'état de l'application et l'interactivité. Le rendu dynamique, qui sert une version prérendue aux seuls robots, est en revanche à écarter : Google le présente comme une solution de contournement, déconseillée parce qu'elle ajoute de la complexité et consomme des ressources, et recommande à la place le rendu côté serveur, le rendu statique ou l'hydratation.

Le choix se fait page par page, et chaque framework a sa brique.
Côté React, Next.js permet de choisir le rendu de chaque page, et le référencement d'un site Next.js se règle ensuite dans l'API Metadata et les fichiers sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche..ts et robots.ts de l'App Router. Le choix du rendu page par page, les balises natives de React 19 et les pièges des applications monopages sont détaillés dans notre guide React SEO. Un site Gatsby part avec un HTML prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.érendu au build ; ses points propres, l'API Head et les routes client-only, sont dans notre guide SEO de Gatsby.
Côté Vue, Nuxt utilise le rendu universel par défaut. Côté Angular, ng add @angular/ssr ajoute le rendu serveur à un projet existant, et Angular prérend alors toute l'application par défaut.
La grille de décision par type de page (accueil, fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées., recherche interne, espace client) et les risques d'un SSR mal réglé sont dans notre article sur le rendu côté serveur et le SEO.
Les huit erreurs JavaScript qui coûtent l'indexation
Ces erreurs ont un point commun : elles cachent un contenu ou un lien au moment où Google le cherche. Les erreurs 2 et 3 bloquent la découverte des pages, les autres leur rendu ou leur indexation. Toutes se voient au test.

1. Bloquer les scripts, les feuilles de style ou l'API dans le robots.txt
Google n'exécute pas le JavaScript des fichiers bloqués par le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer.. Une règle Disallow posée sur un dossier de scripts ou sur l'API qui fournit le contenu peut vider la page rendue. Vercel en fait l'une de ses recommandations : laisser explorables les ressources nécessaires au rendu (API, fichiers JavaScript et CSS). Revoyez votre gestion du robots.txt après chaque refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée., et contrôlez les ressources chargées dans l'inspection d'URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé..
2. Construire la navigation sans liens <a href>
En règle générale, Google ne peut explorer un lien que s'il s'agit d'un élément <a> muni d'un attribut href. Il ne peut pas extraire de manière fiable l'URL d'un <a> sans href, ni d'une balise qui fait office de lien grâce à un événement de script. Dans le HTML que lit le robot, <a onclick="goto(...)">, <span href="..."> ou <a routerLink="..."> sont déconseillés, même si Google peut essayer de les analyser.
Un lien injecté en JavaScript reste explorable tant qu'il prend la forme d'un <a href>. La correction tient souvent en une ligne :
<!-- Google ne peut pas extraire cette URL de manière fiable -->
<span class="lien" onclick="location.href='/chaises'">Chaises</span>

<!-- Lien explorable : un script peut toujours intercepter le clic -->
<a href="/chaises">Chaises</a>
Les composants de lien des frameworks (Link de Next.js ou de React Router) produisent justement ce balisage. Un bouton reste le bon choix pour une action (ouvrir une fenêtre, gérer les cookies), jamais pour aller vers une autre page.
L'étude de Vercel et MERJ apporte une nuance : Google a repéré des URL écrites en clair dans des données JavaScript non affichées, mais pas une URL encodée. À l'inverse, certains sites rendent volontairement des liens non explorables en encodant l'URL : la méthode et ses limites sont dans notre article sur l'obfuscation de liens, et son usage le plus courant dans celui sur le mega menu. Pour tout lien que Google doit suivre, la règle reste le <a href>.
3. Charger les pages dans des URL en dièse
Une application monopage qui affiche ses vues sous httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://example.com/#/produits risque de n'exposer qu'une seule URL : GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. ne résout pas ces fragments de manière fiable. Le schéma d'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. AJAX qui permettait de lire ces fragments est obsolète depuis 2015. Google demande d'utiliser l'API History, qui donne à chaque vue une vraie URL (/produits), servie par le serveur quand on l'ouvre directement.
4. Charger le contenu au clic, au survol ou au défilement
La recherche Google n'interagit pas avec la page : elle ne clique pas, ne survole pas et ne fait pas défiler. Un texte chargé à l'ouverture d'un onglet, un sous-menu chargé au survol ou des produits chargés au défilement restent invisibles pour elle. Un onglet dont le texte figure déjà dans le HTML rendu, simplement masqué en CSS, reste lisible dans ce HTML.
Pour le chargement différé, Google demande de charger le contenu dès qu'il entre dans la fenêtre d'affichage : attribut loading="lazy" du navigateur pour les images et les iframes, ou API IntersectionObserver. Pour un défilement infini, chaque segment doit avoir sa propre URL (par exemple ?page=12) et des liens qui permettent de les parcourir, comme l'explique notre guide de la pagination SEO.
5. Retirer un noindex ou changer la canonical en JavaScript
Quand Google trouve un noindexDirective indiquant aux moteurs de ne pas indexer une page. dans le HTML d'origine, il peut ignorer l'affichage et l'exécution du JavaScript. Un script qui retire ce noindex risque de ne jamais être exécuté : l'étude de Vercel et MERJ l'a vérifié, les pages en noindex dans la réponse initiale n'étaient pas rendues. Si la page doit être indexée, le noindex n'a rien à faire dans le HTML servi.
La canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. suit une règle voisine. Google accepte qu'un script la définisse, mais pas qu'il la remplace par une autre URL que celle du HTML d'origine. Le mieux reste de la mettre dans le HTML servi, et de vérifier après rendu qu'il n'y en a qu'une.
Le reste des balises passe mieux. Google accepte un title et une meta descriptionBalise HTML décrivant le contenu d'une page. Affichée sous le titre dans les SERP, elle influence le CTR. définis en JavaScript, comme des données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets. JSON-LDFormat recommandé par Google pour implémenter les données structurées dans le code source. injectées par un script, à condition de tester le résultat. Les robots qui n'exécutent pas le JavaScript, eux, garderont ceux du HTML servi.
6. Servir les pages d'erreur avec un code 200
Dans une application monopage, le routage se fait dans le navigateur, et le serveur répond souvent 200 à toutes les URL, y compris pour un produit qui n'existe plus. Google peut alors indexer la page d'erreur, ou la classer en soft 404.
Google propose deux sorties : rediriger en JavaScript vers une URL qui renvoie un vrai 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. côté serveur (par exemple /not-found), ou ajouter une balise meta robots noindex sur la page d'erreur. Avec un rendu côté serveurTechnique générant le HTML sur le serveur, facilitant l'indexation du contenu JavaScript., le plus simple est de renvoyer directement le 404.
7. Laisser une erreur JavaScript casser le rendu
Une exception non gérée peut arrêter le rendu au milieu de la page. Les causes propres à Googlebot sont connues : une page qui attend une autorisation que Googlebot refuse, des données lues dans le stockage local ou un cookie d'une visite précédente, une fonction absente sans solution de repli (Google cite WebGL), un contenu chargé par WebSocket.
Google recommande la détection de fonctionnalités avec un polyfill ou un comportement de repli, et de collecter les erreurs JavaScript rencontrées par les visiteurs, Googlebot compris. Vercel ajoute les error boundaries dans une application React, pour qu'un composant en erreur ne fasse pas tomber toute la page.
Le cache pose un problème voisin. Googlebot peut ignorer vos en-têtes de cache et rendre la page avec une ancienne version d'un script. Google recommande de donner aux fichiers un nom qui change avec leur contenu, une empreinte comme main.2bb85551.js : chaque mise à jour produit alors un nouveau fichier, que Googlebot ne peut pas confondre avec l'ancien.
8. Alourdir la page de JavaScript
Un JavaScript lourd ralentit d'abord le visiteur. L'INPInteraction to Next Paint. Mesure la réactivité aux interactions utilisateur. Remplace le FID depuis 2024., l'indicateur de réactivité des Core Web VitalsMétriques de Google mesurant l'expérience utilisateur : LCP (chargement), INP (interactivité), CLS (stabilité visuelle)., doit rester sous 200 millisecondes ; selon web.dev, envoyer moins de JavaScript réduit le temps de blocage de la page, ce qui peut faire baisser l'INP. Gardez la vitesse à sa place : de bons Core Web Vitals ne garantissent pas une bonne position.
Côté Google, le rendu coûte plus cher que la lecture d'un HTML statique. Vercel note que pour un gros site, à partir de 10 000 pages uniques qui changent souvent, ce coût peut peser sur le budget de crawl. Réduire le JavaScript inutile accélère alors le rendu et peut laisser plus de pages explorées.
Comparer le HTML brut et la page rendue en trois commandes
La méthode tient en trois commandes : récupérer le HTML brut, récupérer le DOM rendu par un Chrome headless, puis comparer balises et liens. Tout ce qui n'apparaît que dans le rendu attend la file de Google et échappe aux robots d'IA qui n'exécutent pas le JavaScript.
URL="https://www.example.com/categorie/chaises"
CHROME="google-chrome"   # ou chromium, ou le chemin complet du binaire de Chrome
UA="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/148.0.0.0 Safari/537.36"
export LC_ALL=C   # grep lit les octets tels quels, quel que soit l'encodage de la page

# 1. Le HTML brut (code HTTP affiché) et le DOM après exécution du JavaScript
curl -sL --compressed -H "Accept-Language: fr-FR,fr;q=0.9" "$URL" -o brut.html -w "%{http_code}\n"
"$CHROME" --headless --accept-lang=fr-FR --virtual-time-budget=10000 --user-agent="$UA" --dump-dom "$URL" > rendu.html

# 2. Title, canonical, meta robots, nombre de H1Balise HTML du titre principal d'une page. Il ne doit y en avoir qu'un seul par page. et de liens, avant et après le JavaScript
for f in brut.html rendu.html; do
  echo "== $f"
  tr '\n' ' ' < "$f" > ligne.txt   # une seule ligne : les balises écrites sur plusieurs lignes comptent
  # grep -a : lire le fichier comme du texte, même s'il contient un octet nul
  grep -aioE "<title[^>]*>[^<]*|<link[^>]*canonical[^>]*>|<meta[^>]*name=[\"']?robots[^>]*>" ligne.txt
  echo "H1 : $(grep -aioE '<h1[[:space:]>]' ligne.txt | wc -l), liens <a href> : $(grep -aioE '<a([[:space:]][^>]*)?[[:space:]]href=' ligne.txt | wc -l)"
done

# 3. Les faux liens du DOM rendu : <a> sans href, href="#", routes en #/, javascript:
tr '\n' ' ' < rendu.html > ligne.txt
echo "<a> sans href : $(grep -aioE '<a([[:space:]][^>]*)?>' ligne.txt | grep -aviEc '[[:space:]]href=')"
grep -aioE '<a[[:space:]][^>]*href="(#|#!?/[^"]*|javascript:[^"]*)"' ligne.txt | head -5
L'option --dump-dom écrit le DOM sérialisé une fois la page chargée. Avec --virtual-time-budget=10000, Chrome attend 10 secondes de temps virtuel avant de considérer la page prête ; ce temps ne s'écoule pas tant que des requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. réseau sont en cours.
Si Chrome ne rend pas la main au bout d'une minute, relancez-le sans --virtual-time-budget : sur certains sites, l'option le fait attendre plusieurs minutes. Avec --compressed, curl décompresse la réponse d'un serveur qui envoie du gzip sans qu'on le demande, et LC_ALL=C empêche grep de s'arrêter sur un caractère d'un autre encodage.
Les deux requêtes demandent la même langue (en-tête Accept-Language pour curl, --accept-lang pour Chrome) : sans cela, un site multilingue peut servir le français à l'une et l'anglais à l'autre, et l'écart de title ou de canonical ne vient alors pas d'un script. Le tr met chaque fichier sur une seule ligne : sans lui, un <a> écrit sur plusieurs lignes dans un HTML indenté échappe au comptage, et le HTML brut paraît plus pauvre qu'il n'est.
Vérifiez d'abord que les deux fichiers montrent la vraie page. Un 403, ou un title du type « Just a moment... » dans les deux, vient d'une protection anti-robots : la balise robots noindex qui l'accompagne vient de la page de vérification.
Le blocage peut aussi ne viser qu'une des deux requêtes. Si seul curl est bloqué, le HTML brut est vide ou réduit à une page de blocage, face à une page complète dans le rendu. Sur trois sites testés, curl recevait un 403 titré « Accès bloqué », un 202 sans contenu, et même un 200 qui ne contenait qu'un script de redirection vers un captcha.
Ce cas imite une coquille remplie en JavaScript : ouvrez brut.html pour trancher. Une vraie coquille contient un conteneur vide (souvent <div id="root">) et les scripts du site ; une page de blocage parle de captcha, de vérification ou d'accès refusé.
Si seul Chrome est bloqué, son code HTTP n'est pas affiché. Sans l'option --user-agent, il s'annonce comme « HeadlessChrome » : sur un site testé, curl recevait la page en 200 et Chrome une erreur 403 « ERROR: The request could not be satisfied ». Une page d'erreur ou de vérification dans le seul rendu.html signale ce cas. Dans les deux situations, relancez depuis une adresse autorisée par l'équipe technique, ou passez par l'inspection d'URL.
Comparez ensuite les deux blocs. L'écart est le diagnostic. Sur une page entièrement rendue côté serveur, title, canonical, meta robots, H1 et nombre de liens sont identiques des deux côtés. D'autres lignes <title> peuvent suivre celle de la page : ce sont les titres d'icônes SVG. Les écarts se lisent ainsi :
- Aucun H1 ni lien dans le HTML brut, des dizaines dans le rendu : la page est une coquille remplie en JavaScript. Sur une page d'accueil testée le 13 octobre 2026, le HTML brut ne comptait ni H1 ni lien, le DOM rendu 1 H1 et 38 liens.
- Un H1 ou des liens en plus dans le rendu : une partie de la page est construite dans le navigateur. Sur une autre page d'accueil testée le même jour, le H1 n'existait qu'après rendu, et une douzaine de liens s'ajoutaient aux 99 du HTML brut. Google lira ces éléments au rendu, les robots d'IA jamais. Regardez lesquels : un bandeau de cookies ajoute souvent ses propres liens.
- Un title différent après rendu : la balise est réécrite par un script. Google indexe la version rendue, les robots qui n'exécutent pas le JavaScript gardent la première. Chrome décode les entités HTML et normalise l'écriture des balises (guillemets,
/>final) : un écart qui ne tient qu'à l'écriture (&Accelerated Mobile Pages. Framework Google pour créer des pages mobiles ultra-rapides (moins utilisé aujourd'hui).;#8211;décodé en tiret,'en apostrophe, une espace insécable réécrite en ) ne compte pas. Des caractères illisibles du seul côté brut viennent de l'encodage de la page (ISO-8859, Shift_JIS), affiché tel quel : ils ne comptent pas non plus. - Des
<a>sans href ou deshref="#": des faux liens, à remplacer par des<a href>s'ils mènent à une page. Unjavascript:qui ouvre le gestionnaire de cookies ou une fenêtre d'inscription est une action, il peut rester tel quel.
Les ancresTexte cliquable d'un lien hypertexte. Doit être descriptif et pertinent. internes d'un sommaire (href="#section") sont de vrais liens vers la même page : la troisième commande ne les liste pas. Le contrôle inverse compte aussi : un texte présent dans le HTML brut puis masqué par un script, comme sur certains paywalls, reste lisible par tout robot qui lit le HTML. Google juge ce montage peu fiable pour limiter l'accès, les alternatives sont dans le guide paywall et SEO.

Un Chrome headless reste une approximation de Googlebot : il ignore le robots.txt et passe par votre adresse IP. La référence reste l'outil d'inspection d'URL de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche.. Lancez le test en ligne, puis « Afficher la page testée » : il montre une capture d'écran, le HTML, les en-têtes, la sortie de la console JavaScript et les ressources chargées. Le test des résultats enrichis montre lui aussi le rendu DOM et la console.
Pour tout le site, un crawl en rendu JavaScript compare le contenu avant et après exécution page par page. Dans Screaming FrogLogiciel de crawl permettant d'auditer techniquement un site web., ce mode est réservé à la version payante, et le filtre « Contains JavaScript Links » liste les pages dont des liens n'apparaissent qu'après rendu : le réglage est dans notre guide Screaming Frog.
Par où commencer sur un site JavaScript
Commencez par les gabarits qui doivent ranker, et corrigez dans l'ordre où les erreurs bloquent Google. Google traite un site JavaScript bien rendu comme un site statique, au délai de rendu près ; le travail consiste à le prouver gabarit par gabarit.
- Listez les gabarits (accueil, catégorie, fiche, article) et passez trois URL de chacun dans les trois commandes.
- Corrigez d'abord ce qui bloque la découverte et le rendu : ressources bloquées par le robots.txt, liens sans
<a href>, URL en dièse. - Traitez ensuite l'indexation : noindex et canonical du HTML servi, vrais codes 404, contenu chargé sans interaction.
- Décidez du rendu des pages qui doivent être lues par les robots d'IA : SSR ou prérendu, page par page.
- Suivez les pages indexées et le rapport « Statistiques sur l'exploration » de la Search Console après chaque mise en production.

Passer un site du rendu client au rendu serveur change le HTML de toutes les pages en même temps : c'est une refonte au sens SEO, avec son plan de recette. Si votre projet en prend le chemin, notre accompagnement SEO à la refonte de sites web sécurise le trafic pendant la bascule.
Questions fréquentes
Google indexe-t-il le contenu chargé en JavaScript ?
Oui. Google rend les pages qui répondent 200 dans un Chromium à jour et indexe le HTML rendu. Le contenu doit pour cela apparaître sans interaction, dans des fichiers que le robots.txt laisse explorer, et sans erreur qui arrête le rendu.
Combien de temps Google met-il à rendre une page JavaScript ?
Google parle de quelques secondes ou plus. Sur nextjs.org en avril 2024, Vercel et MERJ ont mesuré un délai médian de 10 secondes entre l'exploration et le rendu, mais environ 18 heures ou plus pour le 1 % de pages les plus lentes. L'étude porte sur un seul site, nextjs.org : ces délais ne valent pas garantie pour le vôtre.
ChatGPT et Perplexity lisent-ils le JavaScript ?
D'après l'étude de Vercel et MERJ de décembre 2024, non : leurs robots ne lisaient que le HTML servi. GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche. et AppleBot faisaient exception. Une page en rendu client leur apparaissait vide ou presque.
Un site React ou Angular peut-il bien se référencer malgré le JavaScript ?
Oui, à condition de choisir le bon rendu pour les pages qui doivent ranker. Next.js, Nuxt et @angular/ssr livrent un HTML complet par rendu serveur ou par prérendu. Liens, codes HTTP et balises restent à vérifier, quel que soit le framework.
Sources
- Comprendre les bases du SEO JavaScript, Google Search Central
- How Google handles JavaScript throughout the indexing process, Vercel et MERJ, vercel.com
- The new evergreen Googlebot, Google Search Central Blog
- Résoudre les problèmes JavaScript liés à la recherche, Google Search Central
- The new evergreen Bingbot simplifying SEO by leveraging Microsoft Edge, Bing Webmaster Blog
- L'affichage dynamique comme solution de contournement, Google Search Central
- The rise of the AI crawler, Vercel et MERJ, vercel.com
- Rendu sur le Web, web.dev
- Rendering Modes, Nuxt : nuxt.com/docs/guide/concepts/rendering
- Server and hybrid rendering, Angular : angular.dev/guide/ssr
- Sunsetting Create React App, react.dev
- Bonnes pratiques concernant les liens pour Google, Google Search Central
- Link Component, Next.js
- Corriger le contenu au chargement différé, Google Search Central
- Comprendre les signaux Web essentiels et les résultats de recherche Google, Google Search Central
- Comprendre l'expérience sur la page dans les résultats de recherche Google, Google Search Central
- Chromium, headless_command_switches.cc (dépôt GitHub), github.com
- Outil d'inspection d'URL, Aide Google
- SEO Spider Tabs, Screaming Frog, screamingfrog.co.uk