




Screaming Frog SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. SpiderLogiciel de crawl permettant d'auditer techniquement un site web. est un crawler de bureau : il suit les liens de votre site comme le robot d'un moteur et relève, pour chaque URL, code de réponse, title, directives, canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. et profondeur. L'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. reste l'affaire de Google. Gratuit jusqu'à 500 URL, il demande une licence au-delà.
Ce que fait Screaming Frog, en gratuit et en payant
Screaming Frog relève tout ce qu'un robot trouve en suivant les liens de votre site, puis le range en onglets et en filtres : codes de réponse, titles, meta descriptions, directives, canonicals, hreflang, images, profondeur. Il tourne sur votre ordinateur, sous Windows, macOS ou Linux. Ce tutoriel suit la version 24, sortie le 19 mai 2026 : fonctions et menus sont vérifiés dans sa documentation. Les captures, en français, viennent de la version 19.2 (octobre 2023, crawl de notre ancien site) ; certains libellés ont pu bouger depuis. Les menus sont nommés comme dans l'interface française des captures, ou en anglais comme dans la documentation quand la capture ne montre pas leur traduction.
Cinq modes se choisissent dans le menu Mode :
- Spider, le mode par défaut, part d'une URL et suit les liens.
- List contrôle une liste d'URL collée ou importée (txt, csv, Excel ou sitemap XML), le bon mode pour tester les URL d'une migration.
- SERP calcule la largeur en pixels de titles et de meta descriptions importés depuis un fichier, sans aucun crawl : vous testez vos réécritures avant de les mettre en ligne.
- Compare confronte deux crawls.
- APIs interroge la Search Console, GA4, PageSpeed Insights ou les outils de liens sur une liste d'URL, là encore sans crawler.
La version gratuite crawle jusqu'à 500 URL et couvre déjà le socle : liens cassés, erreurs et redirections, titles et meta, directives, hreflang, doublons exacts, sitemaps XML et visualisations. Le reste des fonctions avancées demande une licence, affichée à 245 € par an et par utilisateur en octobre 2026 : configuration du crawl, rendu JavaScript, sauvegarde et réouverture des crawls, comparaison, quasi-doublons, extraction personnalisée, connexions à la Search Console, à GA4 et à PageSpeed Insights, authentification par formulaire, segments. Avec la licence, le plafond d'URL dépend de la mémoire et du disque de votre machine.

Prenons un site vitrine de 200 pages en HTML classique : la version gratuite suffit à un premier état des lieux. Au-delà de 500 URL, ou dès que le contenu dépend du JavaScript, la licence devient nécessaire.
Installer et lancer un premier crawl
Téléchargez la version de votre système sur le site de Screaming Frog, installez-la, saisissez l'URL de départ dans la barre du haut et cliquez sur Start : le crawl démarre en mode Spider avec les réglages par défaut.
Deux réglages valent un coup d'œil avant le premier lancement. Le stockage d'abord, dans File > Settings > Storage Mode : la base de données sur disque est le mode par défaut et enregistre chaque crawl automatiquement ; le rouvrir depuis File > Crawls demande une licence. La documentation recommande ce mode sur un disque SSD et annonce environ 2 millions d'URL avec 4 Go de RAM allouée.
La langue ensuite : l'interface existe en français, elle prend la langue de votre machine au démarrage et se change dans File > Settings > Language.

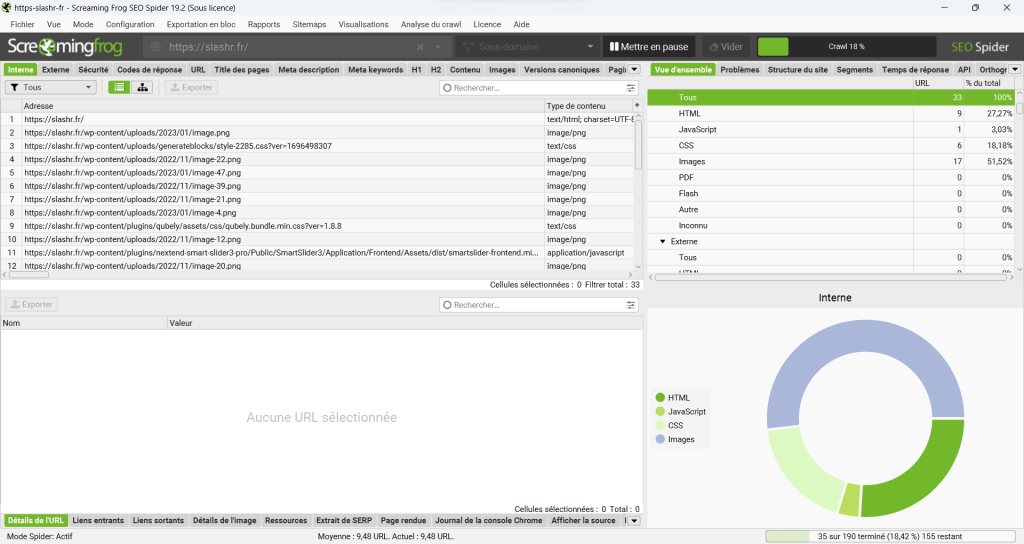
Pendant le crawl, la fenêtre se lit en trois zones. En haut à gauche, les onglets (Interne, Externe, Codes de réponse, Title des pages, Meta description, Versions canoniques…) listent les URL. En bas, le détail de l'URL sélectionnée, avec ses liens entrants et sortants. À droite, la vue d'ensemble compte les URL de chaque filtre, à côté des onglets Problèmes et Structure du site.
Régler le crawl avant de le lancer
Les réglages par défaut conviennent à un petit site en HTML. Dès que le site affiche son contenu en JavaScript, dépasse quelques milliers d'URL ou vit derrière une protection, réglez quatre points dans le menu Configuration avant de lancer, licence à l'appui. Un réglage oublié se paie d'un crawl à refaire.
Le rendu : texte seul ou JavaScript
Configuration > Spider > Rendu propose trois modes. Texte seul, le mode par défaut, lit le HTML brut renvoyé par le serveur. JavaScript exécute chaque page dans un navigateur Chromium sans interface et crawle le HTML rendu, liens compris. Le troisième, Old AJAX Crawling Scheme, ne concerne plus que de très vieux sites.
Sur une application React ou Vue rendue côté client, le mode texte seul voit une page presque vide. Crawlez en mode JavaScript et comparez les colonnes de nombre de mots : Word Count Change donne le nombre de mots ajoutés ou retirés par le JavaScript, JS Word Count % la part du texte qui en dépend. Une page dont tout le texte vient du JavaScript dépend du rendu de Google pour être comprise ; notre guide JavaScript et SEO détaille comment la rendre lisible dès le HTML.
Le périmètre : inclure, exclure, limiter
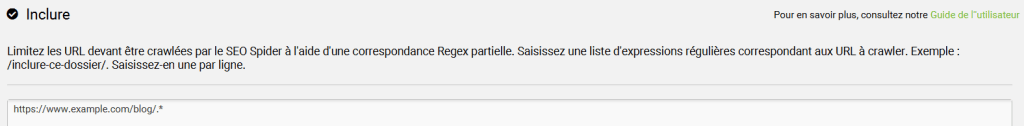
Configuration > Inclure et Configuration > Exclure prennent des expressions régulières, une par ligne, en correspondance partielle : un fragment comme \?price suffit à écarter toutes les URL qui portent ce paramètre (le point d'interrogation s'échappe d'un antislash). La rubrique de dépannage de l'Inclure demande pourtant que l'expression couvre l'URL entière : l'URL complète terminée par .*, comme ci-dessous, fonctionne dans les deux lectures. Le second piège est net : la page de départ doit contenir un lien vers une URL qui correspond, sinon le crawlProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. s'arrête à elle.
# Inclure : le blog seulement
httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.example.com/blog/.*

# Exclure : toutes les URL qui portent le paramètre ?price
\?price
Une URL exclue n'est pas crawlée du tout : les pages qu'on atteint seulement depuis elle disparaissent aussi du crawl. Pour borner un gros site sans regex, Configuration > Spider > Limites fixe la profondeur, le nombre total d'URL ou le nombre de paramètres.
Le robots.txt
Par défaut, Screaming Frog respecte le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. et suit les directives données à GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. quand aucune ne vise son propre user-agent. Le réglage Ignore robots.txt but report status de Configuration > robots.txt crawle quand même les URL bloquées et les signale : c'est lui qui vérifie qu'une règle ne coupe pas une section qui devrait ranker. La syntaxe des directives et leurs pièges sont détaillés dans notre guide du robots.txt en SEO. Dans l'onglet Codes de réponse, le filtre Blocked by Robots.txt affiche, pour chaque URL bloquée, la ligne du fichier qui la bloque.
La préproduction et les accès protégés
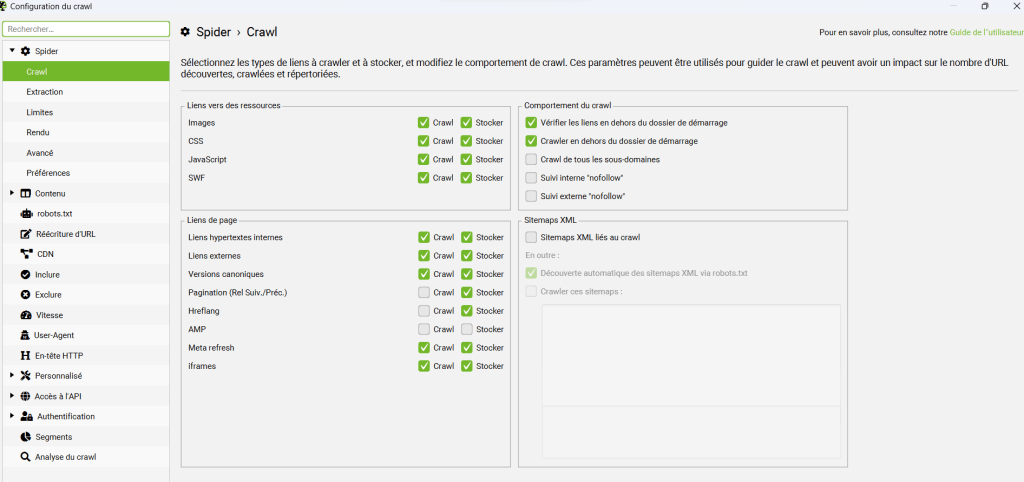
Si votre préproduction est en noindexDirective indiquant aux moteurs de ne pas indexer une page., nofollowAttribut indiquant aux moteurs de ne pas suivre un lien ou de ne pas transmettre de jus SEO., Screaming Frog crawle la page d'accueil et s'arrête : par défaut, il ne suit ni les liens nofollow, ni les liens d'une page en meta nofollow. Cochez Suivi interne "nofollow" dans Configuration > Spider > Crawl.

Le même écran choisit aussi les ressources à crawler (images, CSS, JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche.) et les sitemaps XML liés à suivre.
Une protection par mot de passe HTTP (basic ou digest) est détectée pendant le crawl : une fenêtre demande les identifiants, même sans licence. Pour une connexion par formulaire, Configuration > Authentification, onglet Forms Based, ouvre un navigateur dans lequel vous vous connectez. La documentation prévient que l'outil clique alors sur tous les liens de la page, déconnexion et suppression comprises : utilisez un compte sans droit d'écriture.
Lire un crawl dans le bon ordre
Un crawl remonte des dizaines de filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. à la fois. Lisez-les dans l'ordre où ils gênent le moteur : ce qui empêche d'atteindre les pages, puis ce qui les retire de l'index, puis ce qui dégrade leur affichage, enfin la structure.

1. Codes de réponse. Ouvrez les filtres Client Error (4xx), Server Error (5xx) et Redirection (3xx). Pour chaque 404, l'onglet du bas Liens entrantsLien provenant d'un site externe pointant vers votre site. Facteur de ranking majeur. donne les pages qui pointent dessus : corrigez le lien à la source, chaque redirection ajoute un aller-retour au crawl. Le menu Rapports > Redirect Chains liste les chaînes et les boucles de redirection ; notre guide des redirections SEO aide à choisir le bon code pour chacune.
2. Directives et canonicals. Dans l'onglet Directives, le filtre Noindex liste les pages exclues de l'index ; dans Versions canoniques, les filtres Canonicalised et Missing montrent les pages qui renvoient vers une autre URL et celles qui n'ont pas de canonical. Screaming Frog classe le filtre Noindex en avertissement de priorité haute : une page stratégique en noindex sort des résultats sans bruit. Le guide de la balise canonical aide à trancher chaque cas, et notre article sur l'indexation de votre site sur Google couvre ce qui se passe une fois la page crawlée.
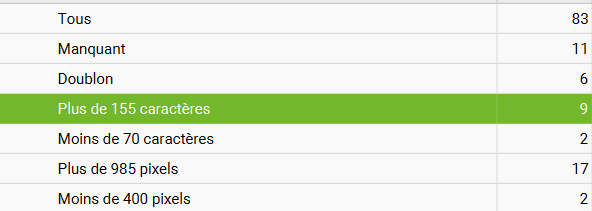
3. Titles et meta descriptions. Les filtres Manquant, Doublon et Plus de X pixels trient les balises à reprendre. Les seuils en pixels approchent les troncatures de Google, que Google ajuste souvent selon la documentation : servez-vous-en pour trier, puis testez vos réécritures en mode SERPSearch Engine Results Page. Page affichée par un moteur de recherche en réponse à une requête utilisateur. avant de les publier.
4. Contenu dupliqué. L'onglet Contenu sépare les doublons exacts, détectés par défaut, des quasi-doublons, repérés à partir de 90 % de similarité par un algorithmeProgramme informatique utilisé par les moteurs de recherche pour classer les pages web. Google utilise plus de 200 facteurs de ranking. minhash (seuil par défaut, réglable). Les quasi-doublons s'activent dans Configuration > Contenu > Doublons et se remplissent après l'Analyse du crawl ; seules les pages indexables sont comparées. Google ne sanctionne pas la duplication en soi : sa documentation la juge normale sur un site et hors de ses règles anti-spam. Le risque est ailleurs, Google choisit lui-même l'URL qu'il affiche parmi les doublons. Canonical, redirection ou réécriture se décident page par page. Sur une boutique, des fiches aux descriptions presque identiques remontent dans ce filtre ; si la vôtre tourne sur Shopify, notre prestation SEO Shopify traite ces cas jusque dans le thème.
5. Profondeur. Le filtre Pages With High Crawl Depth et l'onglet Structure du site montrent les pages éloignées de l'accueil en nombre de clics. La documentation de l'outil rappelle que les pages liées depuis l'accueil reçoivent plus de PageRankAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne. interne que les pages enfouies. Une redirection compte comme un niveau dans la colonne Crawl Depth.
HreflangAttribut HTML indiquant la langue et la région ciblée d'une page pour le SEO international., si le site est multilingue. L'onglet Hreflang signale les liens de retour manquants (Missing Return Links), les URL hreflang qui ne répondent pas en 200 et les codes de langue ou de région incorrects. Un hreflang combine une langue au format ISO 639-1 et, en option, une région au format ISO 3166-1 Alpha 2 ; la région seule n'est pas valide. Pour corriger ce que l'onglet remonte (liens de retour manquants, codes de langue ou de région), suivez la méthode de notre guide du SEO multilingue.
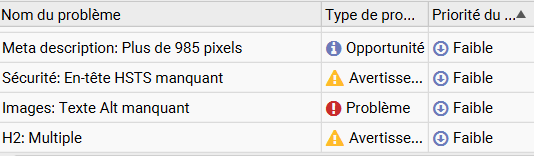
6. L'onglet Problèmes, en dernier. Il reprend les filtres précédents et classe chacun en Problème, Opportunité ou Avertissement, avec une priorité haute, moyenne ou faible et une description. Exportation en bloc > Issues > All produit un fichier par problème. La documentation le dit elle-même : cet onglet ne remplace pas un SEO qui connaît le site et ses priorités. Il arrive en dernier parce que ses priorités sont génériques : une alerte sur l'en-tête HSTS et un noindex sur une catégorie s'y côtoient, et seul votre contexte dit lequel compte.
Croiser le crawl avec la Search Console et GA4
Une anomalie se corrige d'abord là où elle coûte du trafic : connectez la Search Console et GA4 pour voir, à côté de chaque URL crawlée, ses clics et ses sessions.
Dans Configuration > Accès à l'API > Google Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche., l'outil récupère par défaut les clics, impressionsNombre de fois qu'une page apparaît dans les résultats de recherche, qu'elle soit cliquée ou non., CTR et positions des 30 derniers jours. L'option URL Inspection ajoute le statut d'indexation de Google, dans la limite de 2 000 URL par propriété et par jour.
Côté Google AnalyticsOutil gratuit Google pour analyser le trafic et le comportement des visiteurs d'un site. 4, sept métriques arrivent par défaut (sessions, engagement, conversionsAction souhaitée accomplie par un visiteur (achat, inscription, contact). Objectif ultime du SEO., revenu…) et vous pouvez en choisir jusqu'à 65. Cochez aussi le crawl des nouvelles URL découvertes dans la Search Console : celles qu'aucun lien interne n'atteint sortent dans le filtre Orphan URLsUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. après l'Analyse du crawl.
Le même menu branche PageSpeed InsightsOutil Google analysant la performance d'une page et fournissant des recommandations d'optimisation., les métriques de liens de MajesticOutil spécialisé dans l'analyse des backlinks avec les métriques Trust Flow et Citation Flow., AhrefsOutil SEO payant spécialisé dans l'analyse des backlinks et la recherche de mots-clés. et Moz, et des modèles d'IA (OpenAIAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses., GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche., Ollama, Anthropic). Ce que mesurent Ahrefs et Majestic, et ce qu'ils coûtent, est détaillé dans notre comparatif des outils SEO de 2026.

Une 404 qui reçoit encore des clics ou des backlinks se redirige vers son équivalent le plus proche. Une 404 sans clic ni lien externe reste une 404, et vous corrigez les liens internes qui pointent dessus. Un title tronqué sur une page qui clique déjà vaut une réécriture rapide ; le même défaut sur une page sans impression passe en fin de liste. Un noindex posé par erreur sur un gabarit de pages sans trafic se corrige en lot, au niveau du gabarit.
Exporter, générer le sitemap et visualiser
Chaque tableau s'exporte avec le bouton Exporter, et trois sorties nourrissent la suite de l'audit : l'export groupé des problèmes, le sitemap XMLFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. et les visualisations.
L'export groupé (Exportation en bloc > Issues > All) range chaque problème dans un fichier séparé, en CSV, Excel ou Google Sheets, soit un fichier par ticket pour l'équipe technique. Pour aller chercher une donnée que les onglets n'affichent pas, comme un prix, une date de mise à jour ou un fil d'Ariane, Configuration > Personnalisé > Extraction collecte n'importe quel élément du HTML en XPath, en sélecteur CSS ou en regex. Pour remonter d'un défaut répété à la ligne du template qui le produit, Claude Code et le plugin claude-seo prennent le relais dans votre repo.
Sitemaps > XML Sitemap génère le fichier à partir du crawl. Par défaut, il ne garde que les pages HTML en 200 et écarte les pages en noindex, canonicalisées vers une autre URL ou paginées, ainsi que les PDF. Au-delà de 49 999 URL, l'outil découpe en plusieurs fichiers et crée l'index de sitemaps. Google rappelle qu'un sitemap aide à découvrir les URL sans garantir qu'elles seront explorées ni indexées : générez-le pour la découverte, puis suivez l'indexation dans la Search Console.

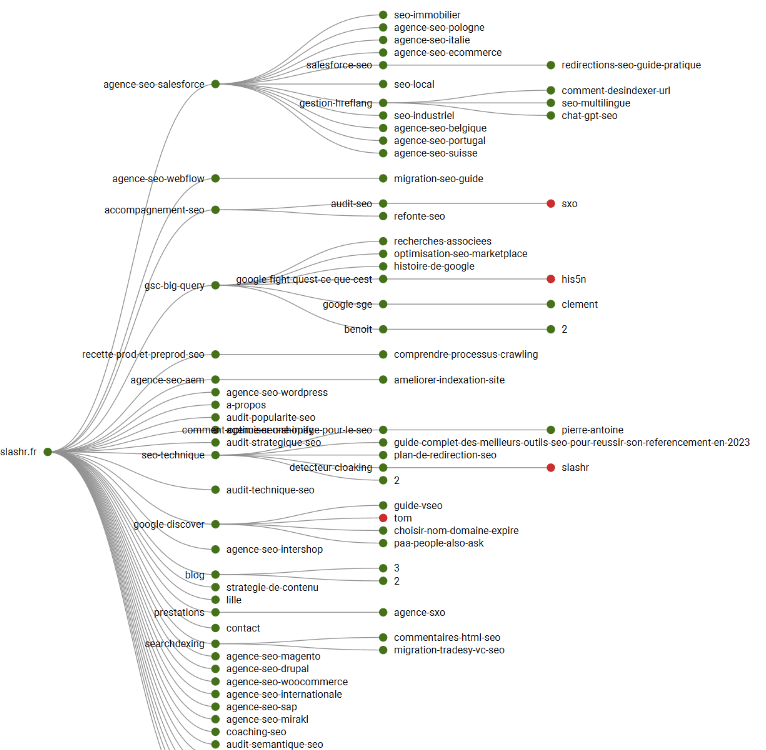
Le menu Visualisations dessine le maillage interneEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. (Force-Directed Crawl Diagram, sa version 3D, Crawl Tree Graph) et l'organisation des URL par répertoire (Directory Tree). Sur un site de quelques centaines de pages, le graphe en arbre montre d'un coup d'œil les branches qui ne mènent nulle part.
Valider les corrections : second crawl et mode Compare
Une correction se constate sur un nouveau crawl : relancez avec la même configuration, puis comparez les deux crawls en mode Compare pour voir ce qui a bougé, filtre par filtre. Le second crawl fait la preuve.
La comparaison demande une licence et le stockage en base de données. Passez en Mode > Compare et choisissez deux crawls avec Select Crawl, ou sélectionnez-les dans File > Crawls.
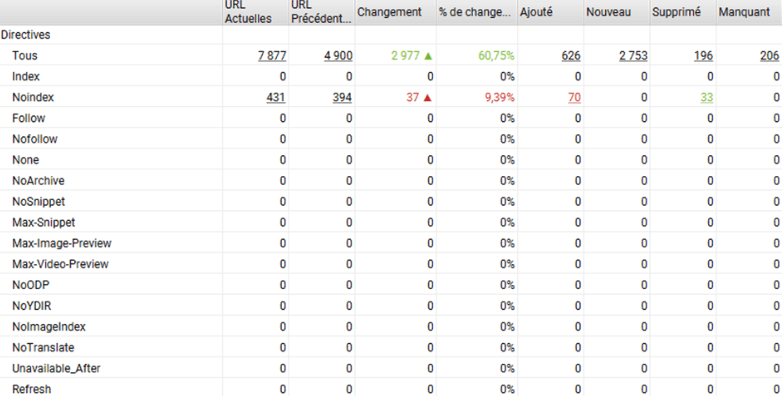
Chaque filtre affiche le nombre d'URL du crawl actuel et du précédent, le changement, puis quatre colonnes : Ajouté et Supprimé pour les URL présentes dans les deux crawls qui sont entrées dans le filtre ou en sont sorties, Nouveau et Manquant pour les URL qui n'existent que dans un des deux crawls.

Avant une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée., le réglage URL Mapping (Configuration > Compare) compare une préproduction et le site en ligne malgré des domaines différents : une regex fait correspondre les URL de l'un à celles de l'autre, et vous voyez avant la bascule les titles perdus, les noindex oubliés et les pages disparues. Ce contrôle avant la bascule fait partie d'un accompagnement SEO de refonte et de migration.
La version 24 automatise une partie de cette boucle : la comparaison automatique des deux derniers crawls planifiés d'un projet, les changements repris dans l'e-mail de fin de crawl, et un serveur MCP qui laisse Claude ou un autre assistant lancer des crawls, interroger et exporter les données (licence payante, stockage en base de données). Crawler, corriger, recrawler : sans le second crawl, l'audit reste une liste. Si vous préférez confier le crawl et sa lecture, notre agence SEO technique s'en charge.
Questions fréquentes
Screaming Frog est-il gratuit ?
Oui, jusqu'à 500 URL par crawl, avec les réglages par défaut. La licence coûte 245 € par an et par utilisateur sur la grille d'octobre 2026, avec un tarif dégressif à partir de cinq licences. Elle débloque la configuration du crawl, le rendu JavaScript, les connexions aux API de Google et la comparaison de crawls.
Screaming Frog existe-t-il en français ?
Oui. L'interface est disponible en anglais, espagnol, allemand, français et italien ; elle prend la langue de votre ordinateur au démarrage et se change dans File > Settings > Language.
Comment se former à Screaming Frog ?
Le guide utilisateur et les tutoriels officiels couvrent chaque fonction, gratuitement. Screaming Frog vend aussi une formation en ligne de deux heures au plus, animée par un membre de son équipe, à partir de 500 £, pour dix collègues invités (davantage sur demande). Pour une formation qui part de votre site et de vos propres crawls, notre formation SEO sur mesure s'adapte au niveau de l'équipe.
Screaming Frog suffit-il pour un audit SEO ?
Il couvre la partie technique que révèle un crawl : accès aux pages, indexabilité, balises, structure. Positions, backlinks et données de trafic viennent d'autres outils, branchés par API ou consultés à côté. Notre guide pour choisir votre stack de logiciels SEO aide à compléter.
Sources
- SEO Spider Pricing, Screaming Frog
- SEO Spider Release History, Screaming Frog
- SEO Spider General (user guide), Screaming Frog
- SEO Spider Configuration (user guide), Screaming Frog
- SEO Spider Tabs (user guide), Screaming Frog
- What is canonicalization, Google Search Central
- Tell Google about localized versions of your page, Google Search Central
- Learn about sitemaps, Google Search Central
- How To Compare Crawls, Screaming Frog
- Screaming Frog SEO Spider Update
- SEO Spider Training, Screaming Frog
- SEO Spider FAQ, Screaming Frog