




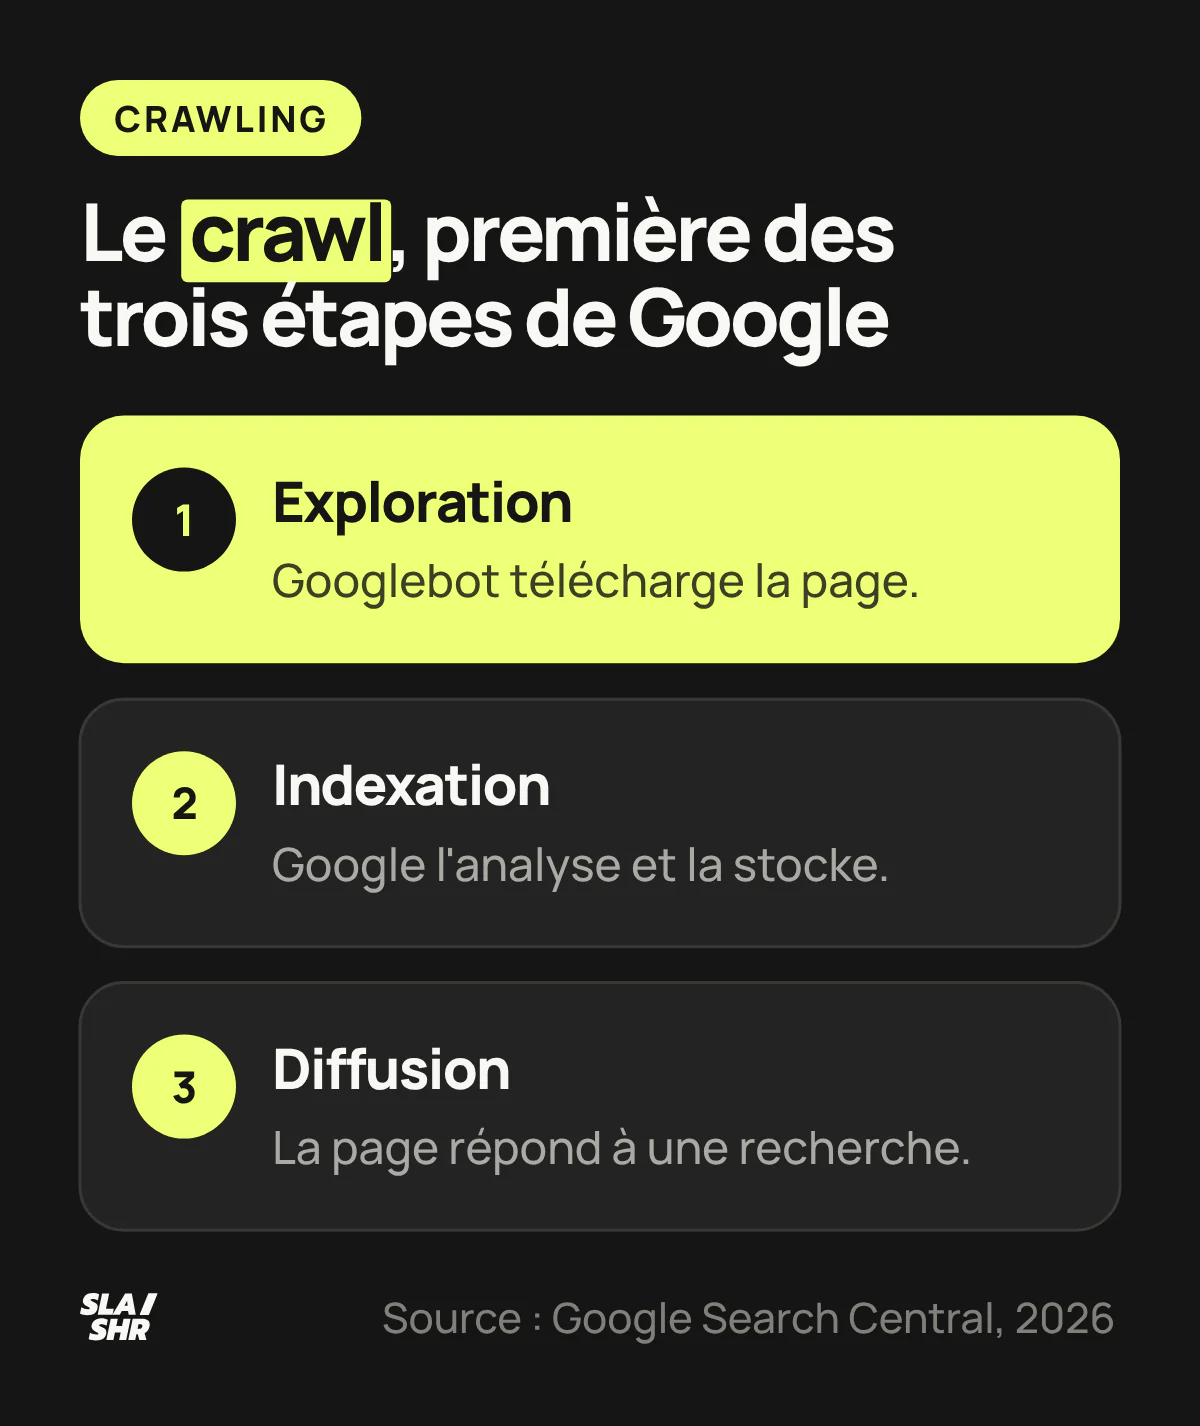
Le crawling, ou explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web., est l'étape où un robot comme GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. découvre des URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. par les liens et les sitemaps, puis télécharge chaque page pour l'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats.. Une page que Googlebot n'a jamais récupérée ne peut pas être indexée avec son contenu.
Crawling : définition et rôle en SEO
Le crawling désigne l'exploration automatique du web par des programmes appelés robots d'exploration, crawlers, spiders ou bots. Chez Google, ce robot s'appelle Googlebot. Bing a Bingbot, et chaque moteur a le sien.
Il n'existe aucun registre central des pages du web. Google cherche donc sans cesse de nouvelles URL pour les ajouter à la liste des pages connues, un travail qu'il appelle la détection d'URL. Les robots explorent le web en suivant les liens entre pages : depuis une page connue, par exemple une page de catégorie, Googlebot extrait le lien vers un nouvel article. Il récupère aussi les listes d'URL que vous lui envoyez dans un sitemap.
Le crawl sert deux objectifs, que la Search Console sépare dans ses statistiques. La découverte, quand l'URL n'a encore jamais été explorée. L'actualisation, quand Googlebot repasse sur une page connue pour voir si elle a changé.

Googlebot existe en deux versions, Smartphone et Desktop. Pour la plupart des sites, Google indexe surtout la version mobile du contenu, si bien que la majorité des requêtes viennent du robot pour mobile. Les deux répondent au même nom dans le robots.txt : impossible d'y cibler l'un sans l'autre.
Le mot sert aussi pour vos propres outils. Crawler un site, en SEO, c'est le parcourir avec un logiciel qui imite un robot pour repérer les erreurs avant Google.
Le processus de crawling de Google, étape par étape
Une URL passe par une file d'attente, un contrôle du robots.txt, une requête HTTP, l'extraction des liens et un rendu JavaScript avant d'arriver à l'indexation. Google décrit ce circuit dans sa documentation sur le SEO JavaScript. Six étapes, dans l'ordre :
- La file d'attente. Chaque URL découverte entre dans une file d'attente d'exploration. Googlebot décide par algorithme quels sites explorer, à quelle fréquence et combien de pages récupérer sur chacun. Il dose aussi sa vitesse pour ne pas surcharger le serveur : sur la plupart des sites, ses accès sont espacés de plusieurs secondes en moyenne.
- Le contrôle du robots.txt. Avant toute requête, Googlebot lit le robots.txt du site. Si l'URL est interdite, il ne la demande pas et passe à la suivante.
- La requête HTTP. Googlebot télécharge la page et lit son code de réponse. Pour la recherche, il explore les 2 premiers Mo d'un fichier HTML ou texte et les 64 premiers Mo d'un PDF. Chaque ressource CSS ou JavaScript est récupérée à part, avec la même limite.
- L'extraction des liens. Dans le HTML reçu, Googlebot repère les URL des liens
<a href>et les ajoute à la file d'attente. Un lien construit autrement, un<span>ou unonclicksans attributhref, n'est en général ni analysé ni extrait. Certains sites s'en servent volontairement : un mega menu SEO obfusqué affiche tous ses liens à l'internaute mais ne laisse crawlables que ceux de l'univers de la page. - Le rendu. Toute page en 200 passe dans une file d'attente de rendu, sauf si une balise meta robots ou un en-tête lui interdit l'indexation. Elle peut y rester quelques secondes ou davantage. Un Chromium sans interface (headless), toujours à jour, affiche alors la page et exécute le JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche., puis Googlebot cherche de nouveaux liens dans ce HTML rendu.
- La transmission à l'indexation. Le HTML rendu part à l'indexation. Ce qui n'apparaît pas dans ce rendu, Google ne peut pas l'indexer : c'est tout l'enjeu du JavaScript en SEO.

L'étape 5 a une conséquence pratique : Googlebot télécharge une page en noindexDirective indiquant aux moteurs de ne pas indexer une page. pour lire la consigne, puis peut se passer du rendu, et la page reste hors de l'index.
Chaque étape peut arrêter l'URL. Et une page qui les franchit toutes peut encore rester hors de l'index. La Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. la classe alors en « Explorée, actuellement non indexée ». Côté découverte, un sitemap XML propre aide Google à trouver vos URL, sans garantir qu'elles seront explorées et indexées.
Extraire et évaluer les mots : le travail de l'indexation
Le processus qu'utilisent les moteurs de recherche pour extraire et évaluer les mots des pages web, afin de répondre aux requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. des internautes, s'appelle l'indexation. Le crawling la prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.écède : il récupère la page, l'indexation la comprend.
Google décrit l'indexation comme le traitement et l'analyse du contenu textuel, des balises et attributs clés comme l'élément <title> et les attributs alt, des images et des vidéos. Pendant cette étape, il regroupe les pages au contenu proche et choisit la plus représentative du groupe, la page canonique, celle qui peut s'afficher dans les résultats. Il relève aussi des signaux sur cette page : sa langue, le pays visé, sa facilité d'utilisation.

Deux confusions reviennent. La première : une page explorée peut rester hors de l'index, et Google l'écrit lui-même, toutes les pages qu'il traite ne sont pas indexées. La seconde : la pertinence face à une requête se juge plus tard, à la diffusion, quand Google choisit quelles pages de l'index afficher pour une recherche donnée. L'index stocke, le classementPosition d'une page web dans les résultats de recherche pour une requête donnée. vient ensuite, et c'est lui que mesure le positionnement sur les moteurs de recherche.
Pour les leviers qui font entrer une page dans l'index, le guide pour améliorer l'indexation de votre site prend le relais.
Ce que chaque réglage change au crawl
Le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. agit sur l'exploration, le noindex et la canonique sur l'indexation, les codes HTTP sur les deux. Les mélanger produit souvent l'inverse de l'effet voulu. D'où cette grille.
| Ce que Googlebot trouve | Effet sur l'exploration | Effet sur l'index |
|---|---|---|
| URL interdite dans le robots.txt | Aucune requête | Indexable sans son contenu si d'autres pages la lient |
| Balise meta robots noindex | Page explorée, consigne lue | Page retirée ou jamais ajoutée |
| Code 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. ou 410 | Signal fort de ne plus explorer l'URL | URL retirée de l'index |
| Code 5xx ou 429 | Googlebot ralentit | URL conservée un temps, puis retirée |
| Soft 404 (page vide servie en 200) | Continue d'être explorée | Erreur soft 404 dans la Search Console |
Lien sans <a href> |
URL non découverte par ce lien | Aucun |
Le piège classique combine les deux premières lignes. Une page bloquée dans le robots.txt ne sera jamais lue : Googlebot ne voit pas son noindex, et elle peut rester visible si d'autres pages la lient.
Pour sortir une page de Google, laissez-la explorable avec un noindex, ou supprimez-la en 404 ou 410 ; la marche à suivre est dans le guide pour désindexer une URL de Google. Le robots.txt sert à garder Googlebot hors des zones sans intérêt pour la recherche, et le guide du robots.txt en SEO détaille la syntaxe que Google lit.

Les liens font l'autre moitié du travail. Puisque Googlebot découvre surtout les nouvelles URL par les liens des pages déjà explorées, une page qu'aucun lien interne ne rejoint ne compte plus que sur le sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche.. Un maillage interne en vrais liens <a href> rapproche vos pages utiles de celles que Googlebot visite souvent. Une structure en silo, où chaque page de tête de rubrique lie toutes ses pages filles, évite qu'une page d'une rubrique ne dépende du seul sitemap. Sur une catégorie e-commerce, c'est le modèle de pagination SEO qui décide à combien de clics de la catégorie se trouvent les produits des dernières pages.
Budget de crawl : qui doit s'en occuper
Le budget de crawlNombre de pages que Googlebot peut et veut crawler sur un site dans un temps donné. est l'ensemble des URL que Google peut et veut explorer sur un site. Google adresse son guide sur le sujet à trois profils, avec des chiffres qu'il présente comme des repères approximatifs :
- les sites de plus d'un million de pages uniques dont le contenu change environ une fois par semaine ;
- ceux de plus de 10 000 pages dont le contenu change chaque jour ;
- ceux dont une grande partie des URL reste en « Détectée, actuellement non indexée ».
Si vos pages sont explorées le jour de leur publication, le sujet ne vous concerne pas.
Google construit ce budget à partir de deux composantes.
La limite de capacité d'exploration dépend de votre serveur : elle borne le temps pendant lequel il garde des connexions ouvertes pour Google, selon le nombre de connexions parallèles et leur durée. Elle monte si les temps de réponse restent stables, et baisse si le site ralentit ou renvoie des erreurs 5xx ou 429.
Le besoin d'exploration dépend de vos pages : l'inventaire d'URL que Google connaît, leur popularité, la fréquence à laquelle elles changent. Le budget se calcule par nom d'hôte, si bien que www.example.com et code.example.com ont chacun le leur.
Sur un catalogue, Google désigne lui-même le coupable : la navigation à facettesSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. est de loin la source la plus courante de surexploration que lui signalent les propriétaires de sites. Prenons une liste de t-shirts filtrable par couleur et par taille :
exemple.fr/t-shirts?couleur=bleuexemple.fr/t-shirts?couleur=bleu&Accelerated Mobile Pages. Framework Google pour créer des pages mobiles ultra-rapides (moins utilisé aujourd'hui).;couleur=vertexemple.fr/t-shirts?couleur=bleu&couleur=vert&taille=sexemple.fr/t-shirts?couleur=bleu&couleur=vert&taille=s&taille=m
Chaque combinaison crée une URL nouvelle aux yeux du robot, qui ne peut juger de son utilité qu'après l'avoir explorée. C'est la surexploration : le temps passé sur ces URL manque pour découvrir les pages utiles. Multipliées par le nombre de catégories, ces URL dépassent vite le nombre de vraies pages du site.
Pour les filtres que vous ne voulez pas voir dans la recherche, Google recommande de les interdire dans le robots.txt, ou de passer les filtres en fragments d'URL (#couleur=bleu), que la recherche Google, en règle générale, n'explore pas. La canonique et le nofollowAttribut indiquant aux moteurs de ne pas suivre un lien ou de ne pas transmettre de jus SEO. marchent moins bien sur la durée.

Le guide de Google liste d'autres gestes, dont ces quatre :
- renvoyer un code 404 ou 410 pour les pages supprimées définitivement ;
- corriger les soft 404, qui continuent d'être explorées ;
- éviter les longues chaînes de redirections ;
- garder un serveur rapide et stable.
Le noindex n'y figure pas. Google demande quand même la page avant de lire la consigne : un noindex ne fait pas économiser de crawl, et désindexer les CGV ou les mentions légales ne libère rien. Les leviers sont détaillés dans l'article sur le crawl budget en SEO, et les soft 404 ont le leur.
Crawler votre propre site avec un outil SEO
Un crawler SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. parcourt votre site comme un robot, lien après lien, pour lister les erreurs avant que Googlebot ne tombe dessus. Screaming FrogLogiciel de crawl permettant d'auditer techniquement un site web., Sitebulb, Oncrawl ou les modules d'audit de SemrushSuite d'outils SEO complète pour l'analyse concurrentielle, les mots-clés et le suivi de positions. et SE Ranking font ce travail. La version gratuite de Screaming Frog explore jusqu'à 500Code HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. URL, la licence lève la limite ; notre guide de Screaming Frog détaille son paramétrage.
Un crawl d'outil remonte les codes de réponse (404, 5xx, redirections en chaîne), les liens cassés, les pages trop profondes, les title et canoniques en double, les URL de facettes qui se multiplient. Deux réglages le rapprochent de ce que voit Google : l'user-agent Googlebot Smartphone, puisque Google explore surtout avec son robot mobile, et le rendu JavaScript si votre site en dépend.
Un crawler a une limite. Il ne voit que ce que les liens rejoignent : une page orphelinePage sans aucun lien interne pointant vers elle, difficilement accessible pour les moteurs., présente dans le sitemap mais liée de nulle part, lui échappe tant que vous ne lui donnez pas le sitemap ou la liste des URL de la Search Console à comparer.

Reste à savoir ce que Googlebot a vraiment exploré. Les logsFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots. du serveur le disent : chaque requête y laisse une ligne avec l'URL, le code renvoyé et l'user-agent. Les mêmes journaux montrent le passage des robots d'IA (GPTBot, OAI-SearchBot, PerplexityBot) : notre guide de l'analyse de logs GEO donne les commandes pour les compter et vérifier leur adresse IP.
Méfiez-vous de cet user-agent, souvent usurpé par d'autres robots. Google conseille de faire une résolution DNS inverse de l'adresse IP (commande host), de vérifier que le nom obtenu appartient à googlebot.com, google.com ou googleusercontent.com, puis de refaire une résolution directe sur ce nom. Pour un regard extérieur sur ces trois sources, l'audit technique fait partie de l'accompagnement de notre agence SEO.
Suivre le crawl de Google dans la Search Console
Le rapport Statistiques sur l'exploration montre ce que Googlebot a fait sur votre site. Il s'ouvre depuis Paramètres, puis Statistiques sur l'exploration.
Le graphique du haut suit trois courbes : le nombre total de demandes d'exploration, la taille de téléchargement totale et le temps de réponse moyen. Google ne donne pas de seuil de temps de réponse.
Ce qui compte, ce sont les ruptures. Un pic de latence signale un problème de serveur ou d'hébergement à creuser. Une chute brutale des demandes a plusieurs causes possibles, que l'aide du rapport liste dans cet ordre :
- une règle trop large ajoutée au robots.txt ;
- un site qui répond lentement ;
- des erreurs serveur en hausse ;
- un site rarement mis à jour ou de qualité moyenne.
Attention en lisant le total : chaque étape d'une chaîne de redirections compte comme une demande distincte.
L'état de l'hôte résume les problèmes de disponibilité des 90 derniers jours, en trois catégories :
- Exploration du fichier robots.txt. Votre site n'est pas tenu d'avoir un robots.txt, mais il doit répondre par un fichier (code 200) ou par une absence nette (403, 404 ou 410). Si la requête échoue, Google cesse d'explorer le site pendant les 12 premières heures, puis utilise le dernier fichier disponible jusqu'au trentième jour.
- Résolution DNS. Les moments où votre serveur DNS n'a pas reconnu le nom d'hôte. Google trace une ligne d'alerte : par exemple, plus de 5 % de résolutions en échec sur une journée compte comme un problème.
- Connectivité du serveur. Les fois où le serveur n'a pas répondu, ou pas en entier.
Le bas du rapport ventile les demandes de quatre façons : par réponse, par type de fichier, par objectif (découverte ou actualisation) et par type de Googlebot. En temps normal, les réponses 200 forment la grande majorité, sauf pendant une réorganisation ou une migration du site. Une part d'images qui gonfle sans raison, ou des découvertes qui s'effondrent après une mise en ligne, méritent une analyse de logs.
Pour une URL précise, l'outil d'inspection d'URL donne la date de la dernière exploration et le type de robot utilisé.

Le bon réflexe après chaque mise en production : ouvrir ce rapport, vérifier l'état de l'hôte et la part des réponses 200, puis crawler le site en Googlebot Smartphone pour repérer ce qui a cassé.
Questions fréquentes
Quelle différence entre crawling et indexation ?
Le crawling récupère la page : Googlebot la télécharge et suit ses liens. L'indexation l'analyse (texte, balises, images), choisit la version canonique et la stocke dans l'index. Une page peut être explorée sans être indexée, et une URL bloquée par le robots.txt peut être indexée sans son contenu si d'autres pages la lient.
Comment s'appelle le processus qui extrait et évalue les mots des pages web ?
L'indexation. Le crawling télécharge la page, puis l'indexation en analyse le texte, les balises et les médias pour la stocker dans l'index, où Google ira chercher les réponses aux requêtes.
À quelle fréquence Googlebot explore-t-il un site ?
Aucune fréquence fixe. Googlebot décide par algorithmeProgramme informatique utilisé par les moteurs de recherche pour classer les pages web. Google utilise plus de 200 facteurs de ranking. quels sites explorer, à quel rythme et combien de pages récupérer, et les pages populaires ou souvent modifiées sont revisitées plus souvent. Après une demande d'exploration, Google prévient que l'exploration peut prendre plusieurs jours, voire plusieurs semaines.
Comment faire explorer une nouvelle page plus vite ?
Liez-la depuis une page que Googlebot visite souvent, comme l'accueil ou une catégorie, ajoutez-la au sitemap, puis demandez l'indexation dans l'outil d'inspection d'URL. Un quota limite l'envoi d'URL individuelles, et une demande ne garantit pas l'inclusion dans les résultats.
Sources
- Guide détaillé de la recherche Google, Google Search Central
- Présentation de Googlebot, Google Search Central
- Comprendre les bases du SEO JavaScript, Google Search Central
- Bonnes pratiques de SEO concernant les liens pour Google, Google Search Central
- Qu'est-ce qu'un sitemap ?, Google Search Central
- Présentation du fichier robots.txt et guide, Google Search Central
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Gestion du budget d'exploration, Google Search Central
- Effet des codes d'état HTTP sur les robots d'exploration Google, Google Search Central
- Gérer l'exploration des URL de navigation à facettes, Google Search Central
- Pricing, screamingfrog.co.uk
- Valider les requêtes des robots d'exploration et des extracteurs Google, Google Search Central
- Rapport "Statistiques sur l'exploration", Aide Google
- Outil d'inspection d'URL, Aide Google
- Demander à Google d'explorer de nouveau votre site Web, Google Search Central
- Décembre : exploration et navigation à facettes, Google Search Central