
Un sitemap SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. est un fichier, le plus souvent en XML, qui liste les URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. que vous voulez voir dans les résultats de recherche. Il aide Google à les découvrir, sans garantir qu'elles seront explorées ni indexées. Un fichier accepte 50 000 URL ou 50 Mo non compressé ; au-delà, on le scinde en plusieurs fichiers, qu'un sitemap index regroupe.
La création tient en quelques lignes, et votre CMS le fait souvent pour vous. L'intérêt du fichier se trouve ailleurs : découpez-le par famille de pages, et la Search Console vous donne le taux d'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. de chaque famille. Vous voyez alors quel type de page Google refuse d'indexer, et dans quelle proportion.
Ce qu'un sitemap change vraiment pour votre référencement
Un sitemap aide Google à trouver vos URL et à planifier leur exploration. Il n'indexe rien. Sa documentation le dit en une phrase : le fichier aide les moteurs à découvrir les URL d'un site, mais ne garantit pas que tous ses éléments seront explorés et indexés. Une fiche produit dupliquée sur des dizaines d'URL passe les mêmes filtres de qualité et de canonicalisation, qu'elle figure dans le sitemap ou non, et consomme du budget de crawl au passage.
Google cite trois cas où le fichier sert vraiment. Un site volumineux, où il est plus difficile de relier chaque page à au moins une autre. Un site récent, que peu de liens externes rejoignent. Un site riche en vidéos et en images, ou prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.ésent dans Google Actualités. Les pages profondes d'un gros site entrent dans le premier cas, typiquement les produits que seule relie une pagination de catégorie profonde, en page 12 par exemple.

À l'inverse, Google estime qu'un site d'environ 500Code HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. pages ou moins, dont toutes les pages se rejoignent en suivant les liens depuis l'accueil, peut se passer de sitemap. Le maillage y suffit. Le fichier ne répare pas non plus une architecture qui laisse des pages orphelines. Une URL orpheline listée dans le sitemap sera découverte, peut-être indexée, mais ne recevra aucun lien interne : le sitemap signale qu'elle existe sans lui donner de place dans le site. Même sur un petit site bien maillé, il garde un usage, la mesure, détaillée plus bas.
Quels types de sitemaps utiliser selon votre site ?
Le XML couvre presque tous les besoins. C'est le format le plus polyvalent selon Google, celui qui porte les extensions image, vidéo et actualités ainsi que les versions linguistiques. Google accepte aussi les flux RSS, mRSS ou Atom et le simple fichier texte, sans préférence entre les formats.
| Format | Ce qu'il contient | Quand l'utiliser |
|---|---|---|
| XML | L'URL (loc) et la date de modification (lastmod) |
Par défaut, tous les sites |
| Sitemap index | La liste des fichiers sitemap | Pratique dès que vous scindez le fichier (au-delà de 50 000 URL ou 50 Mo), utile dès que vous segmentez |
| RSS, mRSS, Atom | Les URL récentes du flux | Blog ou média dont le CMS produit déjà le flux |
| TXT | Une URL par ligne, rien d'autre | Liste simple, sans date ni média |
| Extensions image, vidéo, news | Les métadonnées du média ou de l'article | Catalogues visuels, vidéos, éditeurs d'actualités |

Le sitemap index : n'attendez pas les 50 000 URL
Google impose de scinder un fichier au-delà de 50 000 URL ou 50 Mo non compressé, et un index peut lister jusqu'à 50 000 sitemaps. Attendre cette limite est une erreur de cadrage. Dès que votre site compte plusieurs familles de pages, un fichier par famille rend la mesure possible, même avec quelques milliers d'URL. Deux contraintes : les fichiers enfants se trouvent dans le même répertoire que l'index ou plus bas, et un index ne peut pas lister un autre index.
<?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <sitemap>
    <loc>httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://exemple.fr/sitemaps/categories.xml</loc>
    <lastmod>2026-10-12T09:30:00+02:00</lastmod>
  </sitemap>
  <sitemap>
    <loc>https://exemple.fr/sitemaps/produits-en-stock-1.xml</loc>
  </sitemap>
</sitemapindex>
Image, vidéo et actualités : seulement si le média porte la page
Un sitemap image sert quand vos images génèrent du trafic ou de la conversionAction souhaitée accomplie par un visiteur (achat, inscription, contact). Objectif ultime du SEO. : catalogue mode, immobilier, décoration, recettes. Google le dit lui-même : vous pouvez vous en passer si vous ne cherchez pas à faire indexer la plupart de vos fichiers multimédias. Même logique pour la vidéo, qui ne justifie un sitemap dédié que si vous visez les résultats vidéo.
Le sitemap Google Actualités concerne les éditeurs d'actualités. Il ne porte que les articles publiés au cours des deux derniers jours : passé ce délai, vous retirez l'URL du fichier ou seulement ses balises news:news, limitées à 1 000 par fichier. Aucune candidature n'est à déposer : Google identifie automatiquement les contenus éligibles à Google Actualités.
Le sitemap peut aussi déclarer les versions linguistiques d'une page, avec des balises xhtml:link et l'espace de noms xmlns:xhtml déclaré dans urlset. La structure complète est dans le guide d'implémentation de hreflang ; ces liens enfants ne comptent pas dans la limite d'URL du fichier.
Les balises d'un fichier sitemap XML : loc et lastmod comptent, priority et changefreq sont ignorées
Un sitemap XMLFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. valide tient en quelques lignes : la déclaration XML, l'espace de noms du protocole 0.9, une balise url par page et sa loc.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://exemple.fr/chaussures-running</loc>
    <lastmod>2026-09-28</lastmod>
  </url>
</urlset>
Le protocole rend toutes les autres balises facultatives. Parmi elles (lastmod, changefreq, priority), Google n'utilise que la première.

loc : l'URL canonique, absolue, en 200
loc contient l'adresse complète, protocole compris : Google explore l'URL telle qu'elle est écrite et demande des URL absolues. Listez seulement les URL que vous voulez voir dans les résultats, donc des pages qui répondent en 200 et qui sont leur propre canonique. Google précise que le sitemap influence le choix de l'URL canoniqueBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. : y placer une variante canonicalisée vers une autre page envoie un signal qui contredit votre balise. Comme dans tout fichier XML, les caractères spéciaux s'échappent, et un &Accelerated Mobile Pages. Framework Google pour créer des pages mobiles ultra-rapides (moins utilisé aujourd'hui).; dans une URL s'écrit &.
lastmod : utilisée si elle est fiable
La balise lastmod donne la date de la dernière modification importante de la page. Google s'en sert pour planifier la réexplorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. des URL déjà connues, à condition qu'elle soit cohérente et vérifiable. Son billet de juin 2023 donne l'exemple : si votre page a changé il y a sept ans et que lastmod annonce hier, Google cesse de croire vos dates de modification. Un CMS qui réécrit la date à chaque génération du fichier produit exactement ce cas.
priority et changefreq : ignorées
Google ignore les valeurs priority et changefreq, et Bing aussi. Laissez-les si votre générateur les produit, sans perdre de temps à les régler.
Créer votre sitemap XML sans y passer la semaine
Le fichier doit se régénérer seul quand le contenu change. C'est le seul vrai arbitrage. Pour un site qui compte beaucoup d'URL, Google recommande de le faire produire par le logiciel du site, à partir de sa base de données. Un export figé devient faux à la première fiche ajoutée. Le crawler garde un rôle de contrôle : le générateur de sitemap de Screaming Frog n'inclut par défaut que les pages HTML en 200, sans les pages en noindexDirective indiquant aux moteurs de ne pas indexer une page., canonicalisées ou paginées, et donne une liste de référence à comparer au fichier en ligne.

Sur un CMS
WordPress publie un sitemap natif depuis la version 5.5, sous la forme d'un index à l'adresse /wp-sitemap.xml. Par défaut, il couvre tous les types de contenus et taxonomies publics, les archives auteur et la page d'accueil, donc souvent plus que ce que vous voulez voir indexé. Une extension SEO WordPress reprend la main et vous laisse exclure des types de contenus.
Shopify génère seul un sitemap.xml à la racine, qui renvoie vers des sitemaps distincts pour les produits, les collections, les blogs et les pages, mis à jour à chaque ajout. Sur PrestaShop, le module Google Sitemaps écrit un fichier index par boutique (1_index_sitemap.xml pour la première). Ces découpages suivent les types d'objets du CMS : ils ne séparent ni les facettes, ni les produits hors stock, ni vos autres segments de mesure.
Sur un site sur mesure
Vous écrivez un endpoint qui interroge la base et sort le XML, avec un cache court. La requête SQL est le vrai point de contrôle : elle décide de ce qu'est une page indexable sur votre site (statut publié, canonique, stock), et c'est elle qui produit la segmentation.
Le générateur en ligne, pour un audit ponctuel
Les générateurs en ligne crawlent le site et rendent un XML figé. Utile pour photographier l'existant avant une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. ; en production, le fichier devient faux à la première mise à jour.
Segmenter vos sitemaps pour mesurer votre taux d'indexation réel
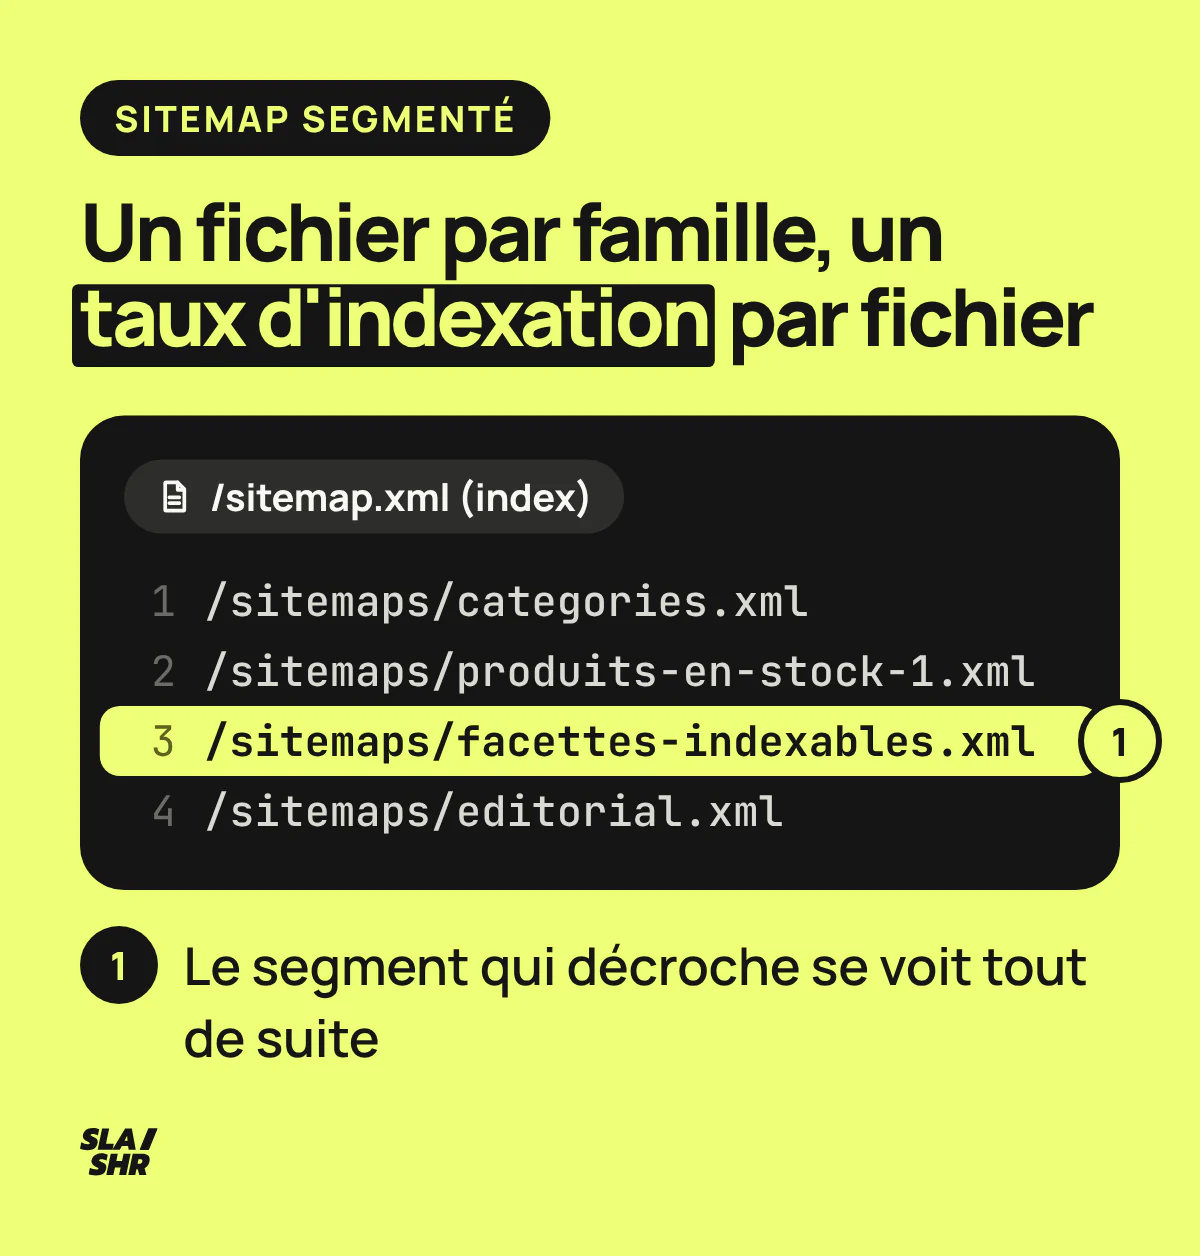
Le découpage transforme la Search Console en outil de diagnostic : avec un fichier par famille de pages, vous lisez quelle famille Google refuse d'indexer, et dans quelle proportion.
Le mécanisme tient en deux rapports. Le rapport Sitemaps affiche, pour chaque fichier envoyé, le nombre d'URL découvertes. Le rapport Indexation des pages se filtre ensuite sur un sitemap précis et donne le nombre d'URL indexées de ce fichier. Pour un index, le compte additionne les URL de tous les fichiers enfants : envoyez donc aussi chaque fichier de segment. Google le prévoit, puisqu'envoyer plusieurs sitemaps sert justement à suivre chacun dans la Search Console.
taux d'indexation = URL indexées du segment / URL découvertes dans le segment
Sur un sitemap unique de plusieurs dizaines de milliers d'URL, ce ratio ne dit rien. Il devient un diagnostic dès que chaque fichier correspond à une famille homogène.
Le découpage type pour un e-commerce
/sitemap.xml                          (index)
  /sitemaps/categories.xml
  /sitemaps/produits-en-stock-1.xml
  /sitemaps/produits-en-stock-2.xml
  /sitemaps/produits-hors-stock.xml
  /sitemaps/facettes-indexables.xml
  /sitemaps/editorial.xml
  /sitemaps/pages-froides.xml
Chaque fichier isole une intention et un mode de production. Les catégories sont peu nombreuses et portent le trafic générique, les produits en stock portent le chiffre d'affaires. Les produits hors stock posent une question commerciale avant d'être une question SEO, et les facettes indexables restent la zone à risque de tout catalogue. L'éditorial suit un autre rythme de publication que le catalogue.
Un exemple chiffré
Prenons un catalogue fictif de 20 000 URL découvertes dans le rapport Sitemaps, réparties en cinq fichiers envoyés un par un.
| Fichier | URL découvertes | URL indexées | Taux |
|---|---|---|---|
| categories.xml | 400 | 384 | 96 % |
| produits-en-stock.xml | 11 000 | 9 350 | 85 % |
| produits-hors-stock.xml | 2 000 | 900 | 45 % |
| facettes-indexables.xml | 5 600 | 1 904 | 34 % |
| editorial.xml | 1 000 | 910 | 91 % |
| Total | 20 000 | 13 448 | 67 % |
Le détail par fichier dit quoi faire : catégories et éditorial vont bien, les fiches en stock perdent 15 % de leurs URL, et les facettes, 28 % des URL du sitemap, ne font indexer qu'une URL sur trois.

L'arbre de décision une fois les chiffres en main
Les seuils qui suivent sont un repère de lecture de l'agence, à caler sur l'historique de votre site : Google n'en publie aucun.
- Au-dessus de 90 % : rien à faire, passez au segment suivant. C'est le cas attendu pour
categories.xmleteditorial.xml. - Entre 60 et 90 % : une partie du parc pose problème. Exportez les URL exclues et regardez le motif dominant. « Page en double sans URL canonique sélectionnée par l'utilisateur » signale de la duplication interne. « Explorée, actuellement non indexée » signale une valeur perçue trop faible : contenu mincePages avec peu de contenu ou de valeur ajoutée, pénalisées par Google., trop proche d'autres pages du segment.
- Sous 60 % : la question porte sur le segment entier. Sur
facettes-indexables.xml, vérifiez d'abord si des combinaisons de filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. sans requête réelle derrière ont été ouvertes à l'indexation. Surproduits-hors-stock.xml, séparez les ruptures temporaires, qui restent en ligne en 200 avec la disponibilitéOutOfStock, des produits retirés du catalogue, à rediriger vers un équivalent ou à passer en 404 ou 410 avant de les sortir du fichier. - Sous 30 % avec un volume important, sur des pages sans demande (facettes sans requête réelle, pages froides) : retirez ces URL de l'index plutôt que de les corriger une à une, puis sortez-les du fichier. Elles consomment de l'exploration au détriment du reste. Les ruptures de stock temporaires restent en ligne, quel que soit le taux.
Deux pièges guettent la segmentation. Découper par date de publication (2024.xml, 2025.xml) mélange les familles de pages dans chaque fichier : le taux obtenu ne dit pas laquelle décroche. Et un découpage non maintenu dérive : un produit qui repasse en stock doit changer de fichier, sinon chaque taux mélange deux populations.
Trouver, déclarer et soumettre votre sitemap
Le sitemap d'un site se déclare le plus souvent dans son robots.txt. Le vôtre se déclare au même endroit et s'envoie dans la Search Console.
Pour localiser celui d'un site, ouvrez domaine.fr/robots.txt et cherchez la ligne Sitemap:. Si elle manque, testez les chemins courants : /sitemap.xml, /sitemap_index.xml, /wp-sitemap.xml, /sitemap.xml.gz. Sur votre propre site, le rapport Sitemaps de la Search Console liste les fichiers envoyés et la date de leur dernière lecture.

Pour la déclaration, une ligne dans le robots.txt suffit, placée n'importe où dans le fichier :
Sitemap: https://exemple.fr/sitemap.xml
L'URL doit être complète, protocole et domaine compris, et vous pouvez déclarer plusieurs lignes. Google, Bing et les autres grands moteurs lisent ce champ, sans console ni compte. Le guide du robots.txt détaille la syntaxe des autres directives.
Dans la Search Console, rapport Sitemaps, collez l'URL de l'index puis celles des fichiers de segment, et cliquez sur Envoyer. Le rapport n'affiche que les sitemaps envoyés par ce biais ou par l'API, pas ceux que Google a trouvés dans le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., et Google accepte jusqu'à 500 fichiers d'index par site. Le rapport Sitemaps indique ensuite l'état de chaque fichier et la date de sa dernière lecture.

Le ping de sitemap ne sert plus chez Google : il a annoncé son abandon en juin 2023, et l'adresse renvoie une erreur 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget.. Chez Bing, le sitemap s'envoie dans les Webmaster ToolsOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. ou se déclare dans le robots.txt ; Bing tente de le récupérer dès l'envoi, puis le relit en général au moins une fois par jour.
Auditer un sitemap : le diff qui trouve les vrais problèmes
Un sitemap se vérifie par comparaison : la liste des URL qu'il déclare contre la liste des URL que votre crawler trouve en suivant les liens internesEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs.. Les logs serveurFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots. ajoutent un troisième ensemble, ce que GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. demande vraiment, mais le diff des deux premiers suffit à trouver l'essentiel.

Commencez par savoir si le fichier est un index :
curl -sL --compressed https://exemple.fr/sitemap.xml | gunzip -cf | grep -c '<sitemapindex'
0 désigne un sitemap simple, 1 un index. Sur un sitemap simple, extrayez directement les URL :
curl -sL --compressed https://exemple.fr/sitemap.xml | gunzip -cf \
| grep -o '<loc>[^<]*' | sed 's/<loc>//; s/&/\&/g' \
| LC_ALL=C sort -u > sitemap-urls.txt
Sur un index, récupérez la liste des fichiers enfants, puis bouclez dessus :
curl -sL --compressed https://exemple.fr/sitemap.xml | gunzip -cf \
| grep -o '<loc>[^<]*' | sed 's/<loc>//; s/&/\&/g' > fichiers.txt
while read -r f; do
{ curl -sfL --compressed "$f" || echo "Échec : $f" >&2; } | gunzip -cf
done < fichiers.txt \
| grep -o '<loc>[^<]*' | sed 's/<loc>//; s/&/\&/g' \
| LC_ALL=C sort -u > sitemap-urls.txt
Trois détails comptent. gunzip -cf décompresse un fichier servi compressé (un .xml.gz) et laisse passer tel quel un fichier servi en clair, même si son nom finit par .gz. Le sed retire la balise et décode les & : Shopify en met dans les adresses de ses fichiers enfants, et une URL restée encodée ne se compare plus. Le motif <loc> laisse de côté les balises image:loc des sitemaps image. Ces commandes tournent avec le grep de Linux comme avec celui de macOS.
L'option -f de curl et le echo signalent chaque fichier enfant refusé (un 429 quand le serveur limite les requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO., par exemple) : la liste serait sinon incomplète sans le moindre message, et le diff sortirait de fausses absentes. Récupérez ces fichiers plus tard avant de comparer.
Si sitemap-urls.txt sort vide, contrôlez la réponse avec curl -sL -o /dev/null -w '%{http_code} %{content_type}\n' suivi de l'URL : un 403 en text/html signale un site qui bloque curl derrière une page de défi. Sur votre propre site, autorisez votre adresse IP ou enregistrez le fichier depuis le navigateur.
Exportez ensuite deux listes d'un crawl lancé depuis l'accueil, sans lui fournir le sitemap, une URL par ligne : toutes les URL trouvées en suivant les liens, quel que soit leur statut, dans crawl-toutes.txt, et les seules URL indexables (pages HTML en 200, canoniques, sans noindex) dans crawl-indexables.txt. comm ne compare que des listes triées dans le même ordre, et cet ordre dépend de la locale : sort et comm tournent donc tous les deux avec LC_ALL=C. Sinon, comm signale une liste « pas dans l'ordre trié » et sort un résultat faux.
LC_ALL=C sort -u -o crawl-toutes.txt crawl-toutes.txt
LC_ALL=C sort -u -o crawl-indexables.txt crawl-indexables.txt
LC_ALL=C comm -23 sitemap-urls.txt crawl-toutes.txt > orphelines.txt
LC_ALL=C comm -13 sitemap-urls.txt crawl-indexables.txt > absentes-du-sitemap.txt
Vérifiez aussi que les deux listes écrivent les URL de la même manière (protocole, www, slash final de la page d'accueil) : sinon la même page apparaît des deux côtés. Le premier fichier contient les URL du sitemap que le crawl n'a jamais rencontrées, donc introuvables par le maillage interne : vos pages orphelines. C'est le résultat le plus utile de l'exercice, puisque vous demandez l'indexation de pages auxquelles le site ne donne aucun lien. Maillez-les ou sortez-les.
Le second fichier liste les URL indexables absentes du sitemap : le générateur filtre autrement que le site, une catégorie a été exclue par erreur, un type de contenu oublié après une migration.
Quatre erreurs à chercher en premier
Des URL en 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. ou 404 dans le fichier. Passez la liste au crawler en mode liste, filtrez les codes autres que 200 et corrigez à la source : le générateur ne se synchronise pas avec la base.
Des URL bloquées par le robots.txt. Vous demandez l'exploration et l'interdisez en même temps. Le rapport Indexation des pages, filtré sur le sitemap, les classe en « URL bloquée par le fichier robots.txt ».
Des URL non canoniques : paramètre de tracking, version en http ou sans www, slash final quand la canonique n'en a pas. Le générateur doit sortir la version canonique de chaque URL.
Un lastmod aligné sur la date de génération. Le symptôme se voit tout de suite : toutes les entrées portent la même date. Si vous ne pouvez pas produire une date fiable, retirez la balise ; Google accepte un lastmod sur une partie des pages seulement.
La vérification de lecture côté Google
Dans le rapport Sitemaps, l'état doit être « Opération effectuée » et la date de dernière lecture récente. Si la récupération échoue, Google réessaie pendant quelques jours, puis cesse de lire le fichier : corrigez-le et renvoyez-le. Une erreur sur quelques URL n'empêche pas la lecture du reste du fichier.
Sitemap, IndexNow et moteurs génératifs
Pour les réponses IA de Bing, le sitemap reste le signal de couverture et lastmod le signal de fraîcheur. Bing l'écrit dans son billet de juillet 2025 : la date de dernière modification l'aide à choisir les URL à réexplorer, ou à les ignorer si rien n'a changé depuis le dernier passage, et ces signaux de fraîcheur influencent la vitesse à laquelle une mise à jour apparaît dans les résultats et les réponses générées. Il demande une date au format ISO 8601, heure comprise.

IndexNow complète le fichier. Vous notifiez chaque URL ajoutée, modifiée ou supprimée, et la notification est partagée entre les moteurs participants : Bing, Naver, Seznam, Yandex, Yep et Amazon. Google ne figure pas dans cette liste ; pour lui, le canal reste le sitemap à jour avec un lastmod fiable.
Sur un site éditorial qui veut être cité vite, la conséquence est pratique : le sitemap se met à jour à la publication, avec la date réelle, et la notification IndexNow part au même moment. Ces signaux raccourcissent le délai de découverte ; ce qui rend une page citable reste son contenu.
Questions fréquentes
Un petit site a-t-il besoin d'un sitemap ?
Rarement pour la découverte. Google estime qu'un site d'environ 500 pages ou moins, dont toutes les pages se rejoignent par des liens depuis l'accueil, peut s'en passer. Le fichier reste utile pour suivre l'indexation dans la Search Console, et la plupart des CMS le produisent sans effort.
Faut-il laisser les pages en noindex dans le sitemap ?
Pas en temps normal : le sitemap liste les URL que vous voulez voir dans les résultats, et une page en noindex n'en fait pas partie. Pendant une désindexation, un sitemap temporaire qui liste les URL concernées aide Google à les réexplorer et à lire la directive, puisque Google conseille le sitemap pour faire réexplorer un grand nombre d'URL. Une fois les pages sorties de l'index, retirez-les du fichier.
Un sitemap HTML sert-il encore à quelque chose ?
Google ne le compte pas parmi les formats de sitemap : il accepte le XML, les flux RSS, mRSS ou Atom et le texte. Une page plan du site reste une page de liens, utile à un visiteur perdu dans un gros catalogue et aux pages profondes qu'elle relie. Si votre architecture rejoint déjà chaque page, elle n'apporte presque rien.
Faut-il déclarer le sitemap dans le robots.txt et dans la Search Console ?
Oui, les deux se complètent. La ligne Sitemap: du robots.txt sert à tous les moteurs qui lisent ce champ, Bing compris. L'envoi dans la Search Console donne le suivi : le rapport Sitemaps, avec le nombre d'URL découvertes, la date de lecture et les erreurs de chaque fichier, n'affiche que les fichiers envoyés par ce biais ou par l'API.
Sources
- Gérer vos sitemaps à l'aide du rapport sur les sitemaps, Aide Search Console
- Qu'est-ce qu'un sitemap ?, Google Search Central
- Créer et envoyer un sitemap, Google Search Central
- Gérer vos sitemaps à l'aide de fichiers d'index de sitemaps, Google Search Central
- Créer un sitemap Google Actualités, Google Search Central
- Contenu d'actualités sur Google, Aide Éditeur Google Actualités
- Indiquer à Google les versions localisées de votre page, Google Search Central
- Sitemaps XML format : sitemaps.org/protocol.html
- Le point de terminaison de ping pour Sitemaps va disparaître, Google Search Central (blog)
- Keeping Content Discoverable with Sitemaps in AI Powered Search, Bing Webmaster Blog
- SEO Spider General User Guide, Screaming FrogLogiciel de crawl permettant d'auditer techniquement un site web.
- New XML Sitemaps Functionality in WordPress 5.5, make.wordpress.org
- Rechercher et envoyer votre sitemap, Centre d'aide Shopify
- gsitemap.php (module Google Sitemaps 5.0.0), PrestaShop sur GitHub
- Rapport sur l'indexation des pages, Aide Search Console
- Comment Google interprète la spécification robots.txt, Google Search Central
- IndexNow FAQ : indexnow.org/faq
- Demander à Google d'explorer à nouveau vos URL, Google Search Central
- Données structurées spécifiques à un extrait produit (Product, Review, Offer), Google Search Central
- Codes d'état HTTP, erreurs réseau et DNS, Google Search Central
- Exporter des données directement depuis un rapport de la Search Console, Aide Search Console
- Exportation groupée des données de la Search Console vers BigQuery, Aide Search Console