




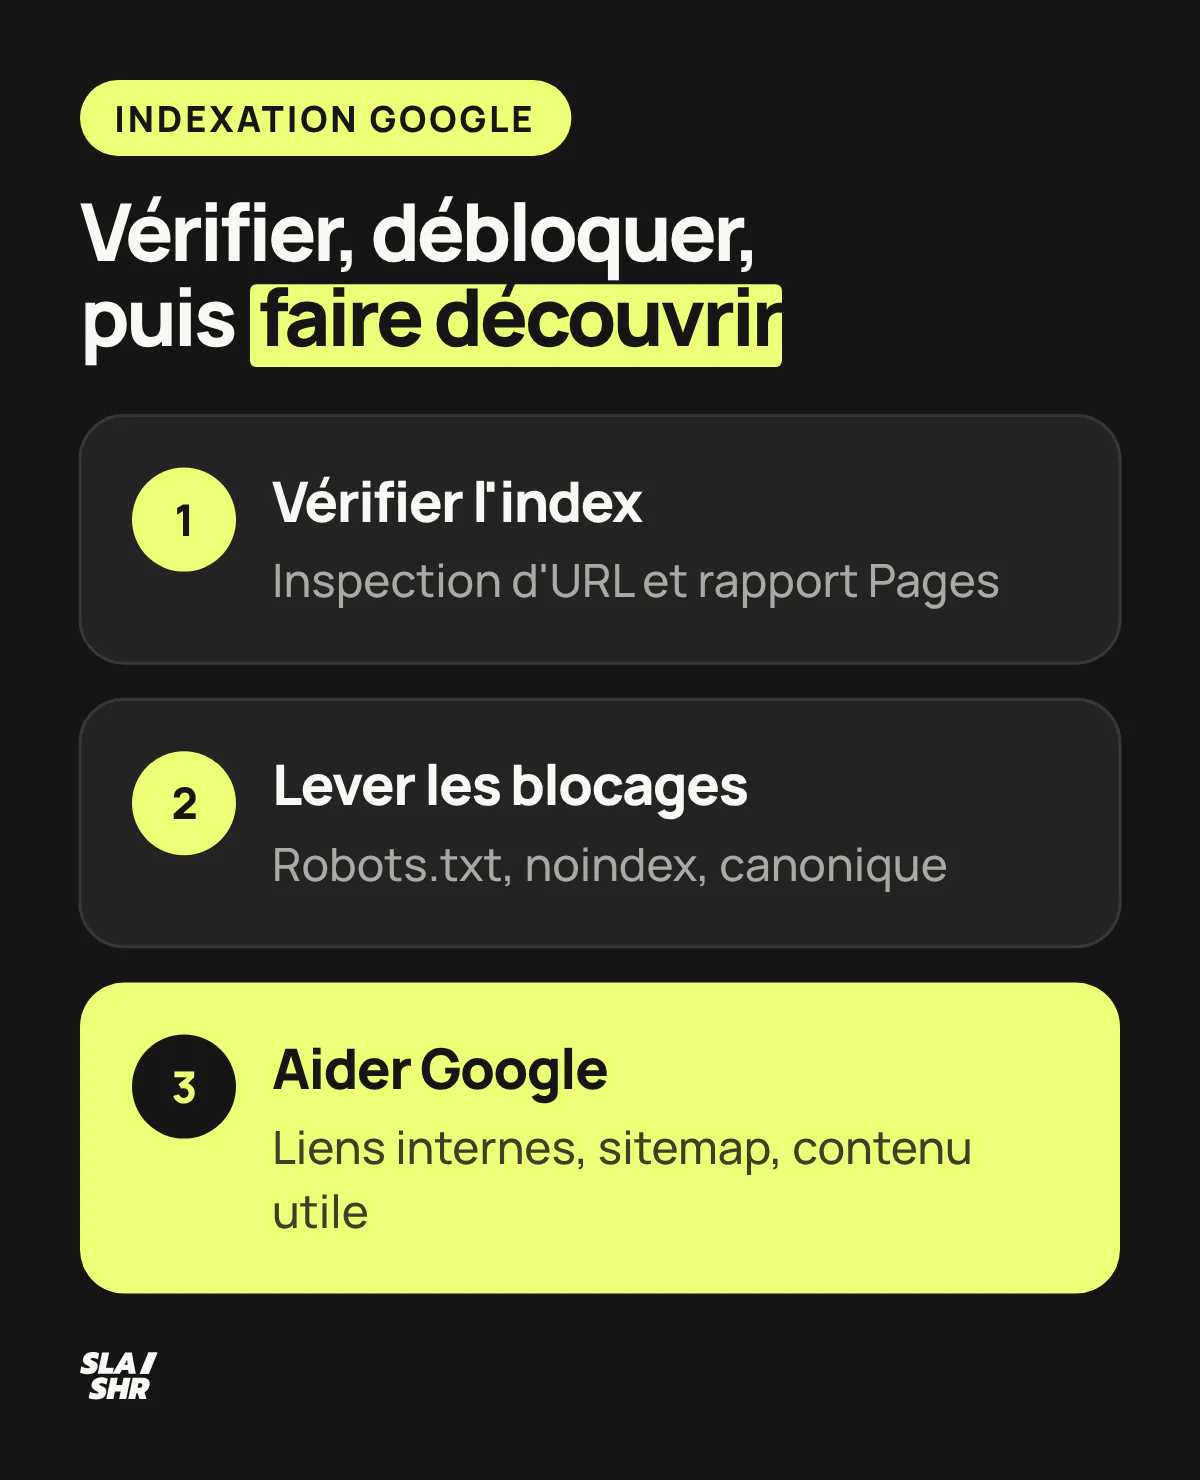
Pour améliorer l'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. de votre site, partez de ce que Google en dit : l'inspection d'URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. et le rapport d'indexation des pages de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. donnent un motif prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.écis pour chaque URL écartée. Chaque motif dit quoi faire. Une fois les blocages levés, liens internesEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. et sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. aident Google à trouver vos pages, sans garantie qu'il les garde.
Ne comptez pas voir toutes vos URL indexées : la Search Console fixe elle-même l'objectif, faire indexer la version canonique de chaque page qui compte. Ce guide s'adresse aux sites dont des pages importantes manquent dans Google, du site vitrine tout juste lancé au catalogue de plusieurs milliers de fiches.
Découverte, exploration, indexation : où une page décroche
Une page franchit trois étapes avant d'apparaître dans Google, et elle peut décrocher à chacune : Google doit trouver son URL, l'explorer, puis décider de l'indexer.
Google découvre une URL surtout de deux façons : en suivant un lien depuis une page qu'il connaît déjà (une page de catégorie qui lie un nouvel article, par exemple), ou par un sitemap que vous lui envoyez. Une demande d'indexation dans la Search Console lui signale aussi une URL précise.
Googlebot télécharge ensuite la page : c'est l'exploration, ou crawl, que détaille notre article sur le crawling des moteurs de recherche. Vient enfin l'indexation : Google analyse le texte, les balises et les images, vérifie si la page double une autre URL, puis range ce qu'il en retient dans son index.
Google le dit dans son guide sur le fonctionnement de la recherche : l'indexation n'est pas garantie, et toutes les pages qu'il traite ne sont pas indexées. Une page indexée peut aussi rester invisible, faute de pertinence pour les requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. des internautes.

Cette découpe sert de grille de diagnostic. Une page inconnue de Google pose un problème de découverte, une page bloquée un problème d'accès, une page explorée puis écartée, si elle reste dehors, un problème de contenu ou de doublon. Les sections suivantes partent de la vérification, puis traitent les blocages avant la découverte et le contenu.
Vérifier ce que Google a indexé
Pour une page précise, l'outil d'inspection d'URL de la Search Console donne la réponse fiable. La commande site: et le rapport d'indexation des pages servent à d'autres échelles.
La recherche site:votredomaine.fr dans Google affiche un échantillon des pages indexées. Pratique pour un premier coup d'œil, à condition de garder sa limite en tête : Google prévient que l'opérateur site: ne renvoie pas nécessairement toutes les URL indexées. Une page absente de cette liste peut très bien être dans l'index, et le nombre affiché ne compte pas vos pages.
L'inspection d'URL tranche, URL par URL. Collez l'adresse dans la barre en haut de la Search Console.
« Cette URL est sur Google » veut dire que la page peut apparaître dans les résultats, sans garantie qu'elle y apparaisse. « Cette URL n'a pas été indexée par Google » veut dire qu'elle ne le peut pas : la section Indexation des pages donne alors le motif, la date de dernière explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web., les sitemaps qui la citent et la page par laquelle Google l'a sans doute découverte. Le bouton « Tester l'URL active » contrôle la version en ligne, utile juste après une correction.
Le rapport d'indexation des pages (menu Indexation, puis Pages) donne la vue d'ensemble : le nombre de pages indexées et non indexées, puis le tableau « Pourquoi des pages ne sont pas indexées », motif par motif.
Sa colonne Source sépare ce qui vient de votre site (« Site Web ») de ce qui vient de Google, et vous ne corrigez en général que la première catégorie. Google estime que si votre site comporte moins de 500 pages, ce rapport ne vous sera probablement d'aucune utilité : il conseille plutôt des recherches site: sur vos pages clés, page d'accueil comprise.

Pas encore de compte ? La Search Console est un service gratuit de Google : ajoutez votre site comme propriété, puis validez que vous en êtes propriétaire. Ce contrôle ouvre aussi tout chantier SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche., car une page non indexée ne rapporte rien : notre exemple de campagne SEO sur six mois place les corrections qui bloquent l'indexation avant tout le reste.
Lire le motif avant de corriger
Chaque URL non indexée porte un motif dans la Search Console, et ce motif dit quoi faire : lever un blocage, corriger une erreur, travailler la page, ou laisser les choses en l'état. Le libellé exact compte : le tableau reprend ceux du rapport.
| Motif dans le rapport | Ce qui se passe | Si la page doit être indexée |
|---|---|---|
| URL bloquée par le fichier robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. | GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. n'a pas le droit d'explorer la page | Retirer la règle Disallow qui la vise |
| URL marquée "noindexDirective indiquant aux moteurs de ne pas indexer une page." | Google a lu une directive noindex (balise ou en-tête HTTP) | Supprimer la balise meta robots ou l'en-tête X-Robots-Tag |
| Introuvable (404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget.) ou Erreur "soft 404" | La page n'existe plus, ou affiche un message de type « Page introuvable » avec un code 200 | Rétablir la page avec un vrai contenu, ou la rediriger en 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. si elle a déménagé |
| Erreur serveurCode HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. (5xx) ou Erreur liée à des redirections | Googlebot n'a pas obtenu la page | Vérifier l'hébergement, raccourcir les chaînes de redirection |
| Bloquée en raison d'une demande non autorisée (401) ou d'une interdiction d'accès (403) | Une authentification ou un pare-feu arrête Googlebot | Ouvrir la page aux visiteurs non connectés |
| Page avec redirection | L'URL redirige vers une autre | Rien sur cette URL ; vérifier que la cible est indexée |
| Autre page avec balise canonique correcte, Page en double | Google garde une autre URL comme canonique | Rien pour un vrai doublon ; sinon corriger la canonique ou différencier le contenu |
| Détectée, actuellement non indexée | URL connue, exploration reportée | Surveiller le serveur et le volume d'URL soumis |
| Explorée, actuellement non indexée | Page lue, puis écartée pour l'instant | Attendre si elle est récente ; sinon travailler le contenu et les liens, ou sortir la page |
Deux motifs n'appellent aucune correction sur l'URL signalée. « Page avec redirection » : l'URL de départ ne sera pas indexée, et la cible peut l'être ou non selon ce que Google en pense ; inspectez-la à part. « Autre page avec balise canonique correcte » : la page renvoie correctement vers sa canonique, qui est indexée. Pour les 404, Google conseille de ne corriger que celles des URL que vous liez sur votre site ou listez dans un sitemap ; une page supprimée sans remplaçante peut rester en 404.
Prenons un catalogue fictif de 4 000 URL connues de Google : 1 900 en « Page avec redirection » après une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée., 600 en « Autre page avec balise canonique correcte » pour des variantes de couleur, 300 en « URL marquée "noindex" ». En regardant les 300 noindex, on trouve 40 fiches produits actives, cochées par erreur dans le back-office. Ces 40 fiches sont la seule correction urgente : pour le reste, il suffit de contrôler par échantillon que les cibles des redirections et les canoniques sont bien indexées.

Les deux derniers motifs se ressemblent. « Détectée, actuellement non indexée » : Google connaît l'URL sans l'avoir explorée, en général pour ne pas surcharger votre serveur, et la date de dernière exploration manque. « Explorée, actuellement non indexée » : Google a lu la page et l'a laissée de côté. Pour traiter ce second cas par famille d'URL, suivez notre guide du statut explorée, actuellement non indexée.
Une fois la correction en place sur toutes les URL d'un motif, le bouton « Valider la correction » demande à Google de les revérifier. La validation prend généralement deux semaines environ, parfois beaucoup plus, et elle reste facultative : Google met à jour le décompte à chaque exploration d'une page concernée.
Robots.txt et noindex : lever les blocages volontaires
Le robots.txt et la balise noindex bloquent deux étapes différentes : le premier interdit l'exploration, la seconde interdit l'indexation. Une page à faire indexer ne doit être visée par aucun des deux.
Ouvrez votredomaine.fr/robots.txt dans votre navigateur. Le blocage le plus brutal tient en deux lignes, typiques d'une préproduction mise en ligne telle quelle :
User-agent: *
Disallow: /
Ces deux lignes interdisent tout le site à tous les robots. Supprimez la règle, ou restreignez-la aux répertoires qui n'ont rien à faire dans Google. Dans l'inspection d'URL, la ligne « Exploration autorisée ? » confirme le blocage. Les règles de syntaxe sont dans notre guide du robots.txt en SEO.
Un Disallow ne retire pas une page de Google pour autant. Google n'explore pas le contenu bloqué, mais il peut indexer l'URL si elle est référencée ailleurs sur le Web : la Search Console la range alors en « Indexée malgré le blocage par le fichier robots.txt », avec un extrait probablement très limité dans les résultats. Le robots.txt gère l'exploration ; pour retirer une page des résultats, l'outil prévu est le noindex.

Le noindex prend deux formes au même effet : la balise <meta name="robots" content="noindex"> dans le <head> de la page, ou l'en-tête HTTP X-Robots-Tag: noindex envoyé par le serveur. La balise se lit dans le code source. L'en-tête, lui, se règle dans la configuration du serveur, un .htaccess ou le code de l'application, et n'apparaît que dans les en-têtes de la réponse : c'est le blocage le plus facile à manquer.
Sur un CMS, le noindex peut venir d'une case cochée : visibilité du site désactivée pendant le développement, ou réglage d'indexation par type de contenu dans une extension SEO. Notre comparatif des extensions SEO pour WordPress détaille les réglages de noindex par type de contenu. Dans l'inspection d'URL, la ligne « Indexation autorisée ? » affiche la directive détectée.
Canonical et doublons : quand Google garde une autre URL
Quand plusieurs URL affichent le même contenu, Google n'en indexe qu'une, la canonique. La Search Console le présente comme un fonctionnement prévu : Google ne diffuse pas de pages en double.
Le problème commence quand la page que vous voulez voir dans Google est celle qui passe pour le doublon. Trois situations mènent là : une balise canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. mal posée, par exemple un gabarit qui déclare la page d'accueil comme canonique de toutes les pages ; des quasi-doublons que Google regroupe, comme des fiches produits dont seul le coloris change ; des URL à paramètres (tri, suivi de campagne) qui se font passer pour la version principale.
Dans l'inspection d'URL, comparez deux lignes : « URL canonique déclarée par l'utilisateur » et « URL canonique sélectionnée par Google ». Si elles diffèrent, Google n'a pas suivi votre déclaration, et le rapport classe en général la page en « Page en double : Google a choisi une autre URL canonique que l'utilisateur ». Lisez ces lignes dans la version indexée : le test en ligne ne peut pas prédire si la page sera retenue comme canonique.
La correction dépend du cas. Une page qui doit s'indexer déclare sa propre adresse comme canonique, en URL absolue, comme Google le recommande :
<link rel="canonical" href="httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.votredomaine.fr/chaussures/trail">
Une page qui double vraiment une autre garde sa canonique vers l'originale, ou disparaît au profit d'une redirection. Si Google regroupe deux pages que vous jugez distinctes, la Search Console donne la consigne : faites en sorte que leur contenu diffère sensiblement.

Le e-commerce produit ces doublons en série. Shopify génère seul les balises canoniques, mais un produit peut répondre à deux URL, avec ou sans la collection dans le chemin : notre guide SEO Shopify montre comment éviter que le thème envoie Googlebot vers la mauvaise. Sur une marketplace, où plusieurs vendeurs proposent le même produit, il faut décider quelle fiche reste indexable, sujet de notre article sur le SEO d'une marketplace.
Liens internes et sitemap : aider Google à trouver vos pages
Googlebot découvre les nouvelles URL principalement par les liens des pages qu'il a déjà explorées. Le sitemap vient en complément : il signale des URL, sans garantie qu'elles soient explorées.
Une page orphelinePage sans aucun lien interne pointant vers elle, difficilement accessible pour les moteurs., qu'aucun lien interne ne rejoint, ne se fait connaître que par le sitemap, un lien externe ou une demande d'indexation. Elle part avec un handicap.
Google se sert des liens pour trouver de nouvelles pages et comme signal de pertinence : liez chaque page qui compte depuis une page déjà explorée, une catégorie, un article qui fait du trafic, la page d'accueil pour les pages majeures. Sur une boutique, ce rôle de page hub revient aux catégories, et sur Shopify aux collections, qui mènent Googlebot vers les fiches produits.

Pour choisir les pages d'où partent ces liens, ouvrez le rapport Performances de la Search Console, onglet Pages : il classe vos URL par clics et impressionsNombre de fois qu'une page apparaît dans les résultats de recherche, qu'elle soit cliquée ou non.. Google indique que les URL les plus populaires sur Internet ont tendance à être explorées plus souvent ; vos pages qui font le plus de clics en donnent un indice, et un lien posé sur l'une d'elles a des chances d'être vu tôt.
Le lien doit aussi être explorable. En règle générale, Google ne suit qu'un élément <a> muni d'un attribut href. Un lien simulé en JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. sur un <span> ou un onclick est déconseillé : Google peut essayer de l'analyser, sans garantie de le suivre.
Retirez enfin le rel="nofollowAttribut indiquant aux moteurs de ne pas suivre un lien ou de ne pas transmettre de jus SEO." des liens internes qui pointent vers des pages à indexer. Depuis le 1er mars 2020, Google traite nofollow comme une indication pour l'exploration et l'indexation, et pour les liens vers vos propres pages que vous ne voulez pas faire explorer, sa documentation renvoie vers la règle Disallow du robots.txt. Une page à garder hors de l'index reçoit un noindex.

Le sitemap, lui, liste les URL que vous voulez voir explorées. Google le formule ainsi : un sitemap aide à découvrir les URL de votre site, mais ne garantit pas que tous ses éléments seront explorés et indexés. Mettez-y seulement les URL canoniques à indexer, qui répondent en 200, et soignez la balise <lastmod>, que Google utilise si elle est cohérente et vérifiable. Google ignore les valeurs <priority> et <changefreq> : un sitemap ne lui transmet ni importance ni fréquence d'exploration.
Envoyez le fichier dans le rapport Sitemaps de la Search Console, ou déclarez-le dans le robots.txt. L'inspection d'URL indique ensuite, ligne « Sitemaps », si la page y figure, ou affiche « Aucun sitemap référent ». Un sitemap segmenté par type de page permet de suivre l'indexation de chaque famille : la méthode est dans notre guide pour créer et segmenter un sitemap XML.
Demander l'indexation : à quel moment, avec quelles limites
La demande d'indexation de l'inspection d'URL fait passer une page nouvelle ou modifiée dans la file d'attente de Google, une URL à la fois, sans garantie d'indexation.
- Inspectez l'URL dans la Search Console.
- Si vous venez de corriger la page, cliquez sur « Tester l'URL active » : le test doit la déclarer indexable.
- Cliquez sur « Demander une indexation ». Si la page passe la vérification rapide des erreurs d'indexation, elle rejoint la file d'attente.
Les limites sont écrites dans l'aide de Google. Un quota limite l'envoi d'URL individuelles, et demander plusieurs fois la même URL n'accélère pas l'exploration. Une demande suffit.
Une page jugée non indexable par le test en ligne ne peut pas être envoyée. La demande est réservée au propriétaire ou à un utilisateur avec accès complet à la propriété. Et l'envoi ne garantit pas l'entrée dans l'index : Google précise que ses systèmes privilégient l'inclusion rapide des contenus utiles et de haute qualité.
Côté délais, l'indexation ne prend généralement qu'un jour ou deux après la demande, mais peut être beaucoup plus longue : la même page d'aide parle aussi d'une à deux semaines. Pour un site neuf, Google conseille de commencer par demander l'indexation de la page d'accueil, ce qui devrait lancer l'exploration du reste du site par ses liens.

Pour des dizaines de pages, le sitemap fait mieux que des clics répétés : Google recommande de l'envoyer après avoir mis à jour la balise <lastmod> des pages modifiées. Quant à l'API d'indexation de Google, elle ne sert qu'aux pages d'offres d'emploi (balisage JobPosting) et de vidéos en direct (BroadcastEvent).
Quand rien ne bloque : le contenu et la popularité décident
Une page accessible, sans noindex ni canonique ailleurs, peut rester hors de l'index après avoir été explorée : c'est le cas « Explorée, actuellement non indexée ». Google précise qu'elle sera peut-être indexée à l'avenir. Quand le statut dure, la réponse passe par la page elle-même : son contenu, ses liens, sa proximité avec une autre URL.
Google cite un contenu de faible qualité parmi les problèmes d'indexation courants, et la Search Console rappelle que certaines URL ne sont pas indexées parce qu'il s'agit de doublons ou parce qu'elles ne contiennent pas d'informations significatives. Une fiche réduite à un titre et un prix, un article qui reprend ce que d'autres pages disent déjà : Google a mieux ailleurs.
Enrichissez le contenu principal avec ce que le lecteur cherche vraiment. Les critères d'un contenu fiable aux yeux de Google (expérience, expertise, autorité, fiabilité) sont détaillés dans notre article sur l'E-E-A-T.
Sur un site qui a accumulé des pages faibles, trier rapporte plus qu'enrichir une à une. Fusionnez les quasi-doublons avec une redirection 301 vers la page qui reste, supprimez en 404 ou 410 les pages sans recherche ni visite, et sortez par noindex celles qui servent la navigation sans répondre à aucune requête.

Le budget de crawl concerne surtout les gros sites. Le guide de Google vise d'abord, en ordre de grandeur, les sites de plus d'un million de pages dont le contenu change chaque semaine, ceux de plus de 10 000 pages dont le contenu change chaque jour, et ceux dont une grande partie des URL reste en « Détectée, actuellement non indexée ». Si vos pages semblent explorées le jour de leur publication, Google estime que vous n'avez pas besoin de ce guide.
Reste la popularité. Pour qu'il découvre une page, Google doit recevoir un sitemap ou une demande d'exploration, ou trouver un lien vers elle quelque part sur le Web. Un backlinkLien provenant d'un site externe pointant vers votre site. Facteur de ranking majeur. sert donc d'abord la découverte, et les URL les plus populaires sur Internet ont tendance à être explorées plus souvent. Aucun backlink n'est requis pour autant : une page liée depuis le site et utile peut entrer dans l'index sans lien externe.

Dans l'ordre, donc : inspectez la page d'accueil et vos pages clés, corrigez les motifs dont la source est « Site Web », liez chaque page qui compte depuis une page déjà explorée, gardez un sitemap propre, et réservez la demande d'indexation aux pages vraiment modifiées.
Une fois indexée, la page doit encore se positionner, et le choix de ses requêtes, de la courte à la longue traîne, prend le relais. Si le diagnostic porte sur des milliers d'URL, une agence SEO peut le mener, sur un périmètre cadré par un devis SEO.
Questions fréquentes
Combien de temps faut-il pour que Google indexe un nouveau site ?
Google indique qu'il faut jusqu'à une semaine pour qu'il commence à explorer et à indexer une nouvelle page ou un nouveau site. Après une demande d'indexation, comptez en général un jour ou deux, parfois une à deux semaines ou davantage. Aucun délai n'est garanti : passé une semaine, inspectez la page d'accueil pour repérer un blocage.
Comment indexer son site sur Google gratuitement ?
Tout se fait sans payer : la Search Console est gratuite, et Google n'accepte aucun paiement pour explorer un site plus souvent. Créez une propriété, envoyez votre sitemap, demandez l'indexation de la page d'accueil, puis liez chaque nouvelle page depuis une page déjà indexée.
Peut-on forcer Google à indexer une page ?
Non. La demande d'indexation place la page dans une file d'attente sans garantie d'inclusion, et la répéter n'accélère rien. Une page accessible, indexable, liée depuis le site et utile a les meilleures chances d'entrer dans l'index.
Ma page est indexée mais n'apparaît pas dans les résultats : pourquoi ?
« Cette URL est sur Google » signifie que la page peut apparaître, sans garantie qu'elle apparaisse. Google l'affiche si elle est pertinente pour la requête, et les résultats varient selon la zone géographique, la langue et l'appareil de l'internaute. Le rapport Performances de la Search Console montre les requêtes sur lesquelles elle s'affiche déjà.
Sources
- Guide détaillé de la recherche Google, Google Search Central
- Rapport sur l'indexation des pages, Aide Google
- Comment utiliser l'opérateur de recherche "site", Google Search Central
- Outil d'inspection d'URL, Aide Google
- À propos de la Search Console, Aide Google
- Présentation du fichier robots.txt et guide, Google Search Central
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Spécifier une URL canonique avec rel="canonical" et d'autres méthodes, Google Search Central
- https://help.shopify.com/fr/manual/promoting-marketing/seo/seo-overview
- Liquid filters: within, shopify.dev
- Présentation de Googlebot, Google Search Central
- Bonnes pratiques de SEO concernant les liens pour Google, Google Search Central
- Gestion du budget d'exploration, Google Search Central
- Évolution de l'attribut nofollow : nouvelles méthodes pour identifier la nature des liens, Google Search Central
- Indiquer les liens sortants à prendre en compte pour le SEO, Google Search Central
- Qu'est-ce qu'un sitemap ?, Google Search Central
- Créer et envoyer un sitemap, Google Search Central
- Demander à Google d'explorer de nouveau votre site Web, Google Search Central
- Guide de démarrage rapide de l'API d'indexation, Google Search Central