
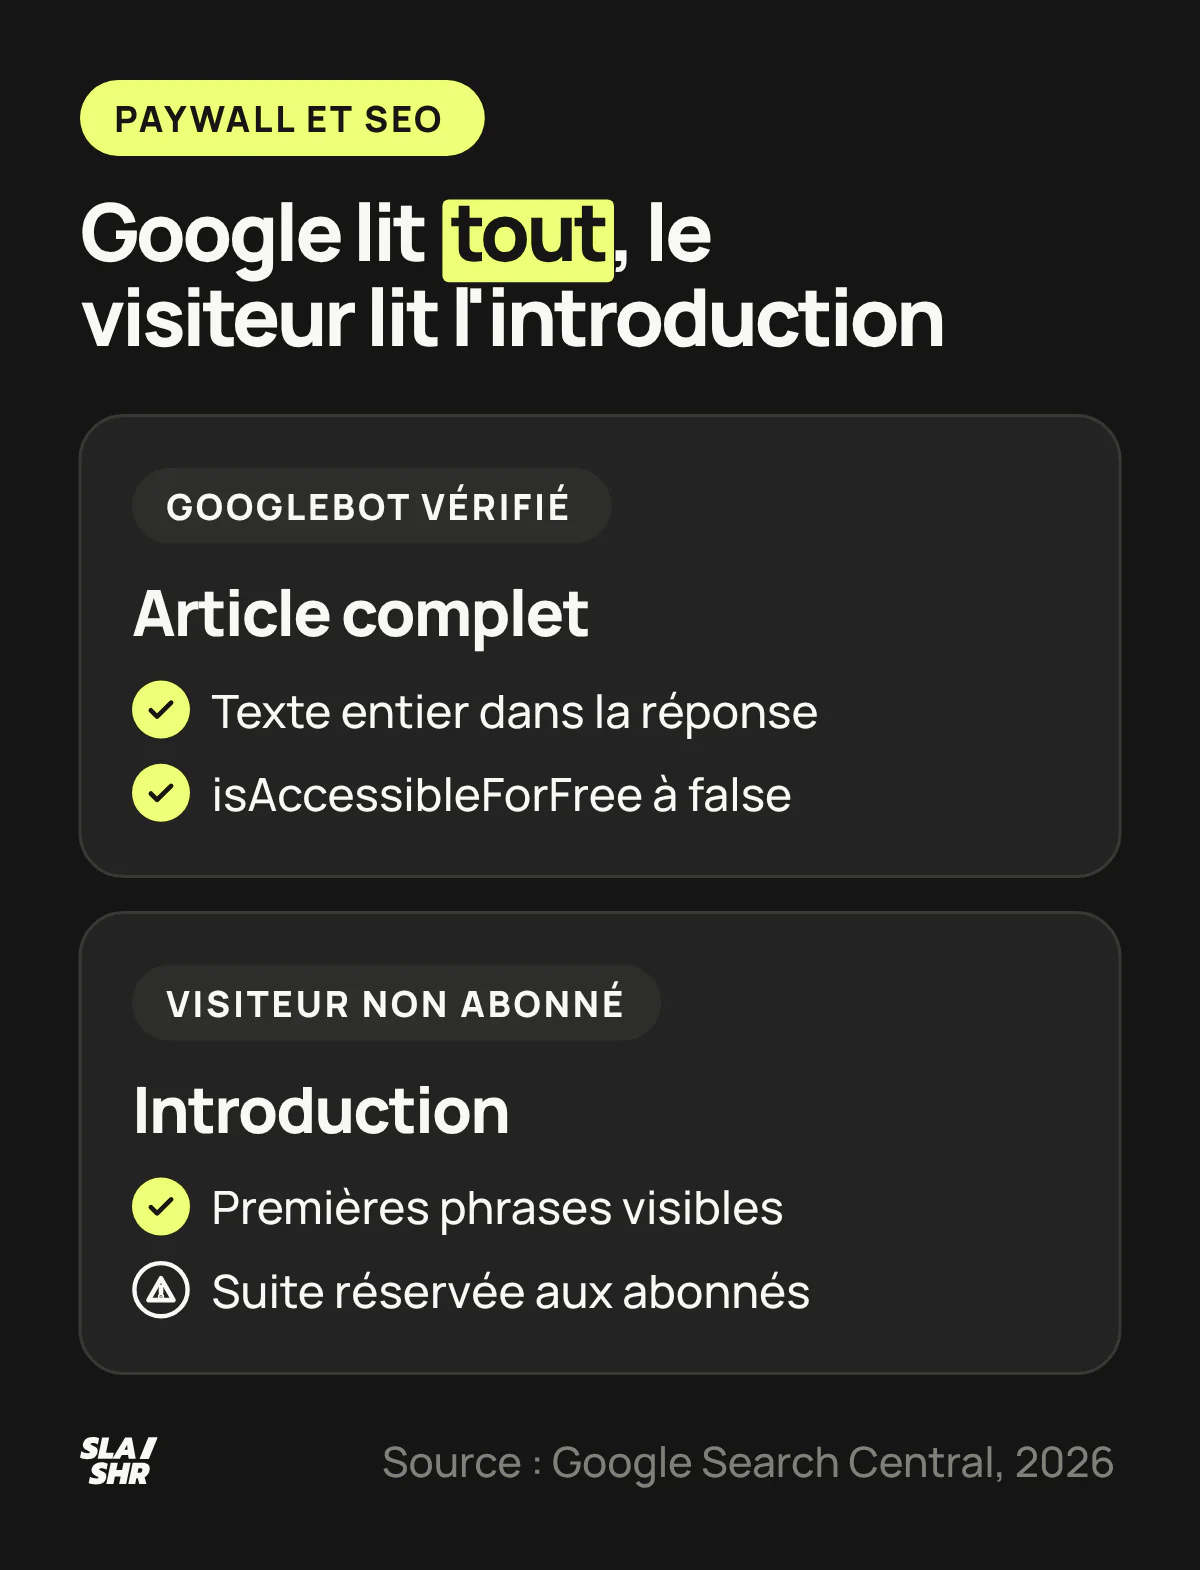
Un paywall n'est pas traité comme du cloakingTechnique black hat affichant un contenu différent aux moteurs et aux utilisateurs. Fortement pénalisée. si GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. voit le contenu complet, comme un abonné, et si le site suit les conseils de Google sur l'échantillonnage flexible. Déclarez la partie payante en données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets., isAccessibleForFree à false avec hasPart et cssSelector : ce balisage aide Google à distinguer votre paywall du cloaking.
Paywall dur, compteur, introduction : les types et leur effet sur le SEO
Le type de paywall règle ce que voit un visiteur venu de Google. Ce que Google indexe dépend d'autre chose, la version de la page que reçoit Googlebot, traitée plus bas. Les deux décisions se prennent séparément.
On distingue d'abord les paywalls durs et les paywalls souples. Le paywall dur (hard paywall) bloque tout l'article tant que le visiteur n'a pas payé. C'est le plus exposé côté trafic organique. Google recommande l'introduction parce qu'elle offre plus de valeur aux internautes qu'une page au contenu totalement bloqué, et il constate que la satisfaction se dégrade nettement au-delà d'un paywall affiché 10 % du temps. Un paywall dur s'affiche à chaque visite.
Le paywall souple laisse lire une partie gratuitement. Google en recommande deux formes, regroupées sous le nom d'échantillonnage flexible :
- le compteur (metered paywall) donne un quota d'articles, après lequel le paywall apparaît ;
- l'introduction (lead-in) montre le début de l'article, le reste est réservé. Google notait en 2017 qu'elle prend en général la forme des premières phrases ou de 50 à 100 mots de l'article.
Deux variantes complètent le tableau. Le freemium mélange articles gratuits et articles réservés sur le même site : chaque article payant se règle comme un paywall dur ou comme une introduction. Le mur d'inscription, qui demande seulement un compte gratuit, compte comme un paywall pour Google : dans ses conseils, le terme « paywall » s'applique aussi aux barrières qui demandent une simple inscription.

Paywall et cloaking : ce que Google accepte
Google accepte qu'un paywall lui montre plus qu'aux visiteurs, à deux conditions. Il doit voir tout le contenu derrière le paywall, comme n'importe quelle personne qui y a accès, et le site doit suivre ses conseils sur l'échantillonnage flexible. C'est écrit noir sur blanc dans ses règles concernant le spam, au chapitre du cloaking.
Le cloaking consiste à présenter à Googlebot un contenu différent de celui que voient les internautes. En apparence, un paywall fait exactement ça : Googlebot lit l'article entier, le visiteur lit trois lignes. Les données structurées lèvent l'ambiguïté.
Google l'a dit sans détour en octobre 2017, quand il a abandonné le First Click Free, une règle censée donner aux internautes de Google l'occasion de découvrir le contenu payant : sans ce balisage, le paywall peut être interprété comme une forme de cloaking, et les pages retirées des résultats. Le First Click Free a été remplacé par l'échantillonnage flexible, où chaque éditeur choisit sa formule.
La même question, ce que lit le robot face à ce que voit l'internaute, se pose pour l'obfuscation de liens. Le paywall reste accepté tant que Google voit ce que voit un abonné et que l'échantillonnage suit ses conseils. Les sites qui jouent avec sans rien déclarer relèvent des pratiques black hat et de leurs sanctions.

Où servir le texte complet : trois architectures de paywall
Pour un média qui vit de la recherche, la bonne architecture est le contrôle côté serveur avec Googlebot vérifié. Le choix qui pèse le plus est technique : l'endroit où le texte complet existe dans la réponse du serveur. Trois architectures se rencontrent, avec des conséquences très différentes pour l'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. et pour la protection du contenu.
1. Le texte dans le HTML, masqué en JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche.. Le serveur envoie l'article entier à tout le monde, et un script le cache tant que l'abonnement n'est pas confirmé. Google indexe tout sans effort. Le problème est commercial. Google prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.évient, dans son guide de dépannage JavaScript, que ce n'est pas un moyen fiable de limiter l'accès au contenu : le texte est dans le code source, à portée de n'importe quel lecteur. Sa consigne : le paywall ne doit fournir le contenu complet qu'une fois l'état de l'abonnement confirmé. Les pièges du rendu côté client sont détaillés dans le guide JavaScript et SEO.
2. Le contrôle côté serveur, avec Googlebot vérifié. Le serveur envoie l'introduction aux visiteurs, l'article complet aux abonnés connectés et à Googlebot. C'est la configuration que décrivent les règles anti-spam : Google voit ce que voit un abonné. Le piège est d'identifier Googlebot par son seul user-agent, que n'importe quel robot peut recopier. Google documente la vérification : une résolution DNS inverse de l'adresse IP, puis une résolution DNS directe du nom obtenu, qui doit retomber sur la même adresse IP. Pour un paywall, n'acceptez que les noms en googlebot.com, le masque des robots d'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. communs comme Googlebot. Les noms en google.com et googleusercontent.com, valides pour d'autres requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. de Google, couvrent aussi des extracteurs déclenchés par des utilisateurs, dont des applications hébergées sur Google Cloud : ne leur ouvrez pas le texte. Pour un gros volume de requêtes, Google conseille la méthode automatique, ici avec la liste common-crawlers.json des robots communs. Si vous visez Google Actualités, votre robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. ne doit pas bloquer Googlebot-News, qui explore avec les user-agents de Googlebot.
3. Le contrôle côté serveur strict, Googlebot compris. Sans abonnement, personne ne reçoit le texte, robot compris. Seule l'introduction est indexable, et la page se positionne sur ce qu'elle montre. Google le dit en tête de son guide de balisage : celui-ci ne concerne que le contenu que vous voulez faire explorer et indexer. Cette option convient aux archives et aux contenus dont la valeur tient à leur rareté, rarement à un média qui vit du trafic Google.
| Architecture | Ce que Google indexe | Protection du contenu | Pour qui |
|---|---|---|---|
| Texte masqué en JavaScript | L'article entier | Faible, le texte est dans le code source | À éviter |
| Serveur, Googlebot vérifié | L'article entier | Forte, si seul googlebot.com est accepté | Médias qui vivent du trafic Google |
| Serveur strict, Googlebot compris | L'introduction seule | La plus forte | Archives, contenus rares |

L'option 2 est la seule qui concilie indexation complète et contenu protégé. Le texte ne quitte le serveur que pour qui y a droit, robot de Google compris.
Deux détails la font tenir dans la durée. Si vous servez des pages AMPAccelerated Mobile Pages. Framework Google pour créer des pages mobiles ultra-rapides (moins utilisé aujourd'hui)., la règle d'accès des robots doit être la même que sur les pages standards, sinon la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. peut afficher des erreurs « Le contenu ne correspond pas ».
Et sur un site d'actualité de plus de 10 000 pages uniques qui change chaque jour, vous entrez dans les profils visés par le guide de Google sur le budget de crawl. Ce guide rappelle que des pages chargées plus vite peuvent permettre à Google de lire davantage de contenu : la vérification de Googlebot ne doit pas ralentir chaque réponse.
Baliser le contenu payant : isAccessibleForFree, hasPart et cssSelector
Une propriété est obligatoire, isAccessibleForFree, mise à false sur l'article. Google recommande d'y ajouter un hasPart de type WebPageElement, qui désigne la section payante par son cssSelector. La procédure de Google tient en quatre étapes :
- entourer chaque section payante d'une classe, par exemple
<div class="paywall">; - ajouter les données structurées de l'article (NewsArticle dans l'exemple de Google) ;
- y ajouter isAccessibleForFree et hasPart ;
- valider le code avec le test des résultats enrichis et corriger les erreurs critiques.
Le balisage d'un article de presse avec une section payante donne ceci :
<html>
  <head>
    <title>Article headline</title>
    <script type="application/ld+json">
    {
      "@context": "httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://schema.orgVocabulaire standardisé de balisage structuré reconnu par Google, Bing et Yahoo.",
      "@type": "NewsArticle",
      "headline": "Article headline",
      "image": "https://example.org/thumbnail1.jpg",
      "datePublished": "2025-02-05T08:00:00+08:00",
      "isAccessibleForFree": false,
      "hasPart": {
        "@type": "WebPageElement",
        "isAccessibleForFree": false,
        "cssSelector": ".paywall"
      }
    }
    </script>
  </head>
  <body>
    <div class="non-paywall">Contenu gratuit</div>
    <div class="paywall">Contenu payant</div>
  </body>
</html>
Le premier isAccessibleForFree dit à Google que l'article n'est pas entièrement accessible gratuitement. Celui de hasPart désigne la section concernée, et cssSelector reprend la classe posée à l'étape 1. Les deux propriétés sont de type booléen dans le tableau de Google : écrivez false sans guillemets, comme dans son exemple.

Google pose quatre consignes. La quatrième, choisir une implémentation qui ne fournit pas le contenu payant au navigateur si vous ne voulez pas qu'il y soit accessible, est celle des architectures plus haut. Les trois autres touchent au format :
- JSON-LDFormat recommandé par Google pour implémenter les données structurées dans le code source. et microdonnées sont acceptés ;
- les sections de contenu ne s'imbriquent pas ;
- cssSelector n'accepte que des sélecteurs de classe, du type .paywall.
Si plusieurs sections d'une même page sont payantes, leurs classes se listent dans un tableau.
"hasPart": [
  {
    "@type": "WebPageElement",
    "isAccessibleForFree": false,
    "cssSelector": ".section1"
  }, {
    "@type": "WebPageElement",
    "isAccessibleForFree": false,
    "cssSelector": ".section2"
  }
]
Le balisage vaut pour le type CreativeWork et ses sous-types : Article, NewsArticle, Blog, Comment, Course, HowTo, Message, Review et WebPage. Un site de formation ou un blog premium l'utilise donc comme un journal.
Régler le compteur et l'introduction sans abîmer le classement
Google conseille un compteur mensuel, à démarrer à 10 articles par mois pour les visiteurs venus de sa recherche, et une introduction visible au-dessus du paywall. Ses conseils sur l'échantillonnage flexible donnent les repères chiffrés.
Google préfère un compteur mensuel. Il l'explique par la granularité : passer d'un nombre entier au suivant pèse moins sur les internautes à 10 échantillons par mois qu'à 3 par jour. Le compteur mensuel concentre aussi le paywall sur les lecteurs les plus intéressés, les plus susceptibles de s'abonner, et laisse les nouveaux venus découvrir la valeur du contenu. Pour la plupart des éditeurs d'actualités quotidiennes, Google situe la bonne valeur entre 6 et 10 articles par internaute et par mois.
Testez par paliers. Google a mené des tests d'échantillonnage avec des éditeurs, et en tire une leçon : même des modifications mineures de l'échantillon peuvent nuire à l'expérience et, l'accès étant restreint, influencer sans le vouloir le classementPosition d'une page web dans les résultats de recherche pour une requête donnée. des articles.
Le seuil à surveiller est chiffré : selon Google, la satisfaction générale se dégrade nettement quand les paywalls apparaissent plus de 10 % du temps, ce qui correspond en général à environ 3 % de l'audience exposée au paywall. Google invite les éditeurs à mesurer la part actuelle des visiteurs de sa recherche qui rencontrent le paywall, et à choisir un quota mensuel qui donne un résultat comparable.

L'introduction se combine au compteur. Google recommande d'afficher les premières phrases de l'article au-dessus de la ligne de flottaisonContenu visible sans faire défiler la page. Zone stratégique pour l'engagement. du paywall : le visiteur juge l'intérêt du contenu, ce qui vaut mieux qu'une page entièrement bloquée. Les éditeurs mieux outillés vont plus loin : ils repèrent les lecteurs qui épuisent leur quota chaque mois et réduisent l'échantillon pour eux seuls, en laissant les autres lire plus librement.
Quels articles laisser en accès libre ?
Gardez ouverts les contenus qui captent la demande de recherche : guides de fond, définitions, pages piliers. Ce sont vos contenus éditoriaux en accès libre, et le choix des formats de contenu éditorial part des questions que vos lecteurs tapent dans Google. Réservez les analyses, les exclusivités et les données propres, qui justifient l'abonnement. Le tri part de la recherche de mots-clés : une requête à fort volume informationnel mérite une page ouverte, qui renvoie vers les articles payants du même thème. Une architecture en silos thématiques fait circuler l'autorité des pages ouvertes vers les pages réservées, que les visiteurs découvrent ensuite depuis le site.
Choisir une solution de paywall : la grille SEO
Côté SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche., une solution de paywall se juge sur six points, tous vérifiables avant de signer :
- Contrôle d'accès côté serveur : le texte complet n'arrive au navigateur qu'après confirmation de l'abonnement.
- Accès de Googlebot vérifié par DNS inverse (nom en googlebot.com) ou par la liste common-crawlers.json, jamais par le seul user-agent.
- Balisage automatique : isAccessibleForFree et hasPart injectés dans les données structurées, avec des sélecteurs de classe alignés sur vos gabarits.
- Compteur mensuel et introduction paramétrables, avec un quota propre aux visiteurs venus de la recherche Google.
- Mesure de l'exposition : la part des visiteurs Google qui rencontrent le paywall, pour rester sous le seuil de Google.
- Parité AMP, si vous en servez : une seule règle d'accès des robots pour les deux versions.

Le premier point se teste en deux minutes sur une page de démonstration : ouvrez le code source dans un navigateur non connecté. Si le texte réservé y figure, le paywall le masque en JavaScript. N'importe qui peut le lire.
Passez ensuite la même page au test des résultats enrichis : le contenu soumis à un paywall doit y apparaître comme élément valide. Quand l'intégration touche au CMS, au CDNContent Delivery Network. Réseau de serveurs distribuant le contenu depuis le serveur le plus proche de l'utilisateur. et aux règles serveur, un accompagnement SEO technique évite de découvrir le problème dans la Search Console.
Vérifier l'indexation et contrôler ce que Google affiche
Après la mise en ligne, deux outils de Google suffisent pour vérifier que le paywall est bien lu. L'outil d'inspection d'URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. de la Search Console montre comment Google explore et affiche une page : le HTML rendu doit contenir le texte complet de l'article.
C'est la version que Googlebot obtient après l'exploration et le rendu, deux étapes détaillées dans le guide du processus de crawling. Le test des résultats enrichis confirme que le balisage est détecté, sans garantir le respect de toutes les consignes : Google prévient dans son guide qu'il peut ne pas identifier un problème qui ne relève pas de la syntaxe.

Reste à décider ce que Google peut montrer du contenu payant. L'attribut data-nosnippet, posé sur un élément span, div ou section, exclut un passage des extraits. La balise meta robots max-snippet limite le nombre de caractères de l'extrait. Ces commandes d'aperçu comptent aussi pour l'IA : les Aperçus IA et le Mode IA y sont soumis, d'après le guide de balisage de Google.

Deux autres réglages ne changent rien au paywall dans la recherche Google. La règle noarchive n'est plus utilisée par la recherche Google, puisque la fonctionnalité de lien en cache n'existe plus. Le jeton Google-Extended, dans le robots.txt, décide si votre contenu sert à entraîner les modèles GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche. et à ancrer leurs réponses : il n'a aucune incidence sur l'inclusion du site dans la recherche Google et ne sert pas de signal de classement.
Le verdict tient en une phrase : déclarez le paywall, servez le texte complet depuis le serveur au Googlebot vérifié, et réglez le compteur sur la part de visiteurs exposés. Commencez lundi par le code source d'un article payant ouvert dans un navigateur non connecté.
Questions fréquentes
Un paywall nuit-il au référencement ?
Pas de sanction s'il est déclaré, si Googlebot reçoit le texte complet et si l'échantillonnage suit les conseils de Google : la page se classe alors sur l'article entier. Le risque vient d'un échantillon trop serré, car Google constate que la satisfaction se dégrade nettement quand les paywalls apparaissent plus de 10 % du temps. Avec un contrôle serveur strict, Googlebot compris, la page se classe seulement sur ce qu'elle montre.
Montrer tout l'article à Googlebot, est-ce du cloaking ?
Google ne l'assimile pas à du cloaking s'il voit tout le contenu derrière le paywall, comme un abonné, et si vous suivez ses conseils sur l'échantillonnage flexible. Déclarez la section payante avec isAccessibleForFree : sans ce balisage, Google prévenait dès 2017 que le paywall pouvait être pris pour du cloaking.
Combien d'articles gratuits laisser avec un paywall à compteur ?
Google propose de démarrer à 10 articles par mois pour les visiteurs venus de sa recherche, et situe la bonne valeur entre 6 et 10 pour la plupart des éditeurs d'actualités quotidiennes. Comptez au mois plutôt qu'au jour, puis ajustez selon la part de visiteurs exposés au paywall.
Faut-il baliser un article payant que Google ne voit pas ?
Non. Le guide de Google sur le balisage des paywalls ne s'applique qu'au contenu qui doit être exploré et indexé. Si Googlebot reçoit seulement l'introduction, comme les visiteurs, la page ne montre rien de plus au robot et le balisage n'a rien à déclarer.
Sources
- Marquage de contenu accessible par abonnement ou soumis à un paywall, Google Search Central
- Règles concernant le spam dans la Recherche sur le Web Google, Google Search Central
- Conseils généraux sur l'échantillonnage flexible, Google Search Central
- Offrir plus de contenu de qualité aux internautes, Google Search Central
- Résoudre les problèmes JavaScript liés à la recherche, Google Search Central
- Valider les requêtes des robots d'exploration et des extracteurs Google, Google Search Central
- Spécifications des balises Meta pour les robots, Google Search Central
- Robots d'exploration communs de Google, Google Search Central
- Gestion du budget d'exploration, Google Search Central