
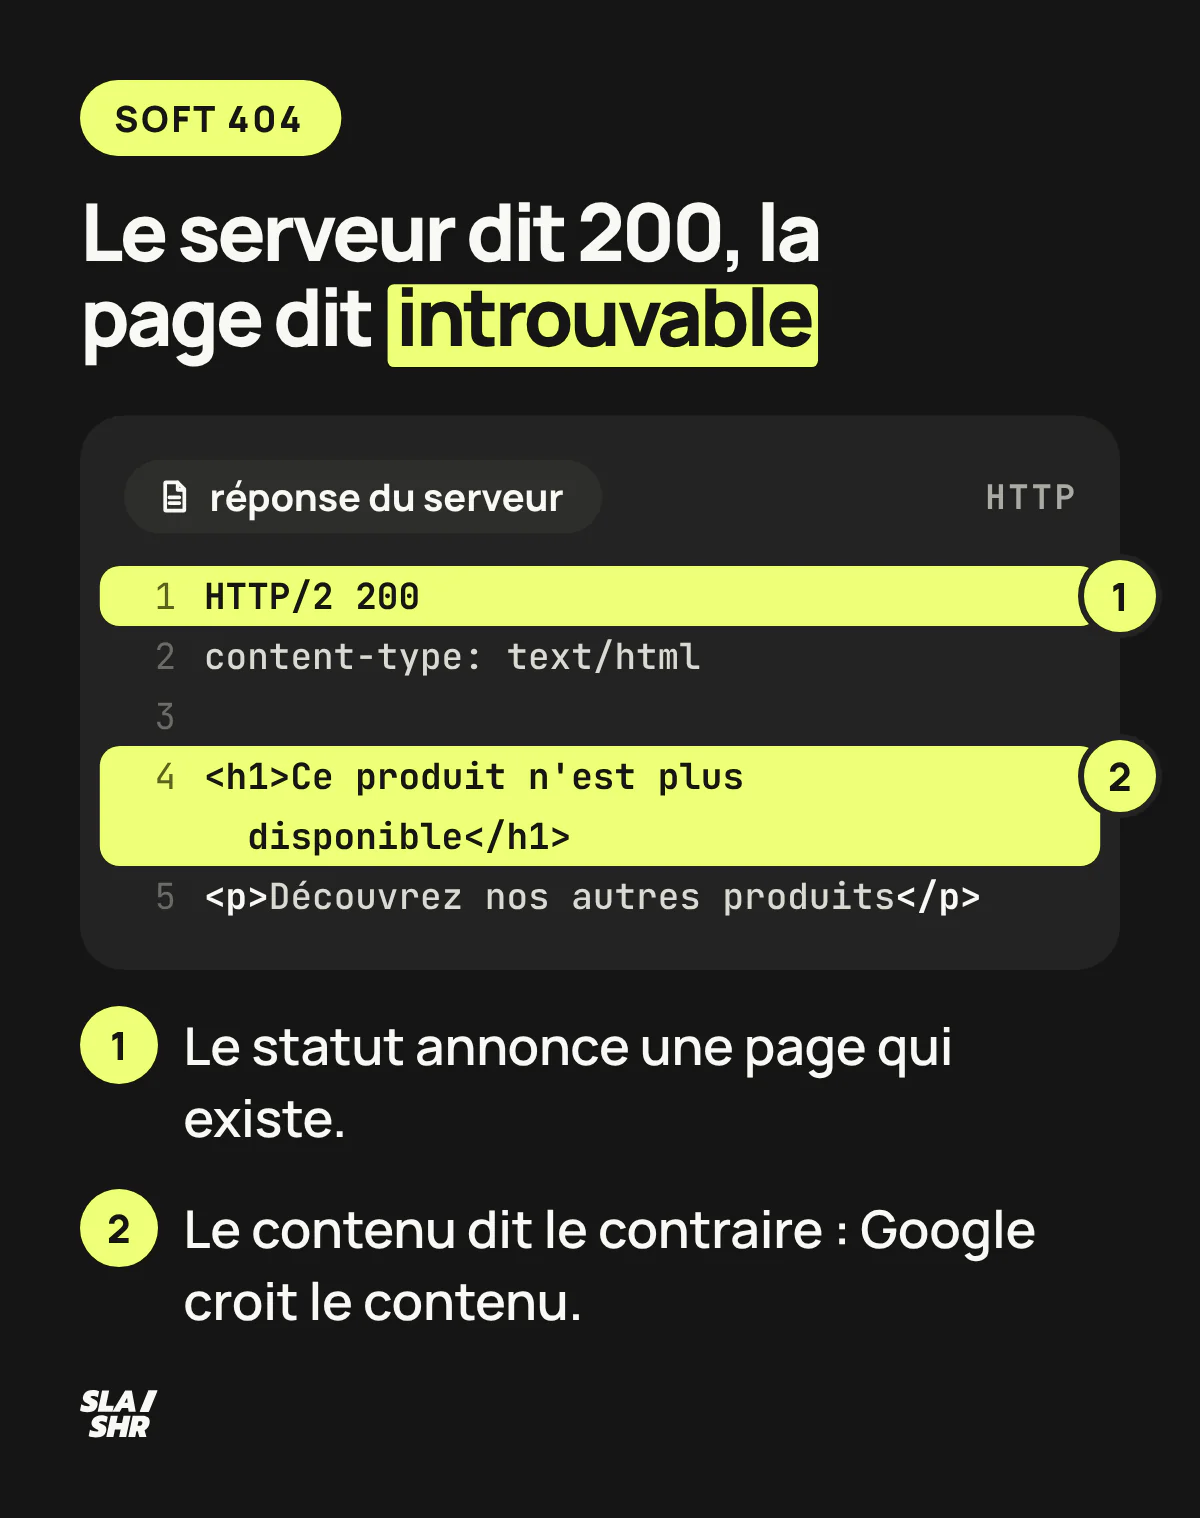
Une soft 404, c'est une URL qui répond 200 OK alors que la page affichée dit, ou laisse penser, qu'il n'y a rien à voir. Google la requalifie en erreur, ne l'indexe pas et la range sous le motif « Erreur "soft 404" » de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche.. Votre serveur affirme que la page existe, le contenu dit le contraire, et GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. croit le contenu.
Pour corriger, vous avez cinq options : rendre la page vraiment utile (200), la rediriger en 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. vers un équivalent, renvoyer une 404 ou une 410, ou la garder en noindexDirective indiquant aux moteurs de ne pas indexer une page.. Une seule convient à chaque cas, et vous tranchez pattern par pattern. Ajouter du texte pour sortir du rapport ne règle rien tant que la règle qui produit ce 200 reste en place.
Soft 404, 404, 410 : ce que dit votre serveur et ce que Google en retient
Google ne s'arrête pas au code de statut. Il compare ce que l'en-tête annonce avec ce que la page affiche une fois rendue, et quand les deux divergent, c'est le rendu qui gagne.
Pour l'internaute, une soft 404 et une vraie 404 peuvent être strictement identiques : même gabarit, même message « page introuvable », mêmes liens vers les catégories. La seule différence se trouve dans la réponse HTTP, que personne ne regarde à part les robots. À l'écran, rien n'a l'air cassé, et c'est pour ça que le problème peut traîner des mois sans que personne ne le remarque.
| Situation | Réponse serveur | Ce que voit l'internaute | Traitement par Google |
|---|---|---|---|
| Vraie 404 | 404 | Page d'erreur, personnalisée ou non | Retirée de l'index, explorée de moins en moins souvent |
| 410 | 410 | Idem | Même traitement que la 404 : Google traite toutes les 4xx pareil, sauf la 429 |
| Soft 404 | 200 | Message d'erreur ou page presque vide | Requalifiée en erreur, non indexée, mais toujours explorée |
| Redirection vers la home | 301 puis 200 | Page d'accueil sans rapport avec l'URL demandée | Peut être traitée comme une soft 404 |
| Noindex | 200 + noindex | Page normale | Explorée, non indexée, sans être une erreur |
Pourquoi Google requalifie votre page
La documentation de Google sur les codes HTTP est explicite : quand le contenu suggère une erreur, une page vide ou un message d'erreur, la Search Console affiche une soft 404. La détection va donc plus loin que les messages explicites. La page d'aide sur les erreurs d'exploration cite quatre causes typiques : un fichier d'inclusion côté serveur manquant, une connexion à la base de données perdue, une page de résultatsSearch Engine Results Page. Page affichée par un moteur de recherche en réponse à une requête utilisateur. de recherche interne vide, un fichier JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. non chargé. Elle peut aussi attraper les listings vides et les fiches réduites à un titre et une image.
Une détection sur le contenu fait des faux positifs. Une page contact très courte ou une fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées. sans description peuvent remonter dans le rapport alors qu'elles doivent exister. Les pages minces peuvent aussi atterrir sous un autre motif, « Explorée, actuellement non indexée », qui se traite lui aussi par famille d'URL. On y revient dans la matrice de décision.

Les mécanismes qui fabriquent des soft 404 en série
Quatre mécanismes produisent l'essentiel des soft 404, et chacun vient d'une règle du site plutôt que d'une page isolée.

La page supprimée dont la route répond toujours
C'est le mécanisme typique de l'e-commerce. Le produit est désactivé dans le back-office, mais le routeur résout toujours l'URL et le gabarit affiche « Ce produit n'est plus disponible » avec un 200. Côté métier, le CMS a fait ce qu'on lui demandait. Personne ne lui a demandé de changer la réponse HTTP.
Le contenu vide ou trop mince
Recherches internes sans résultat, catégories dont tout le stock est épuisé, archives de tags avec un seul article, pages de paginationDivision du contenu en plusieurs pages numérotées. Nécessite une gestion SEO spécifique. au-delà de la dernière page réelle (?page=47 sur un listing qui en compte 12). Le serveur génère une page valide, mais vide. Ce sont les candidates naturelles au motif soft 404.
La redirection de masse vers la page d'accueil
Un plugin ou une règle « catch-all » renvoie toute URL inconnue vers la home. Sur le papier, c'est propre : plus aucune erreur visible. Le guide de Google sur les migrations le déconseille pourtant noir sur blanc : rediriger beaucoup d'anciennes URL vers une destination sans rapport, comme la page d'accueil, peut être traité comme une soft 404. Une redirection 301 garde sa valeur seulement quand la destination répond à la même demande.
Le gabarit qui casse sans changer de statut
Une API produit qui ne répond plus, une base de données injoignable, un include côté serveur introuvable, un script ou une API bloqués par le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., un bloc chargé en JavaScript que le rendu de Google n'exécute pas. Le header, le footer et le menu s'affichent, le contenu principal non. Le serveur renvoie 200 parce que, de son point de vue, il a bien servi du HTML. C'est le cas le plus sournois : la page doit exister, elle est juste cassée.
Détecter une soft 404 : la Search Console pour l'alerte, les logs pour le volume réel
Le rapport Search Console sert d'alerte, les logs mesurent le volume, et le regroupement par pattern transforme des centaines d'URL en quelques décisions. Au-delà de quelques milliers de pages, traiter les URL une par une revient à soigner des symptômes pendant que le template continue d'en produire.
Lire le rapport sans se noyer
Dans la Search Console : IndexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. > Pages, tableau « Pourquoi des pages ne sont pas indexées », ligne « Erreur "soft 404" ». Le rapport d'indexation des pages affiche un échantillon : la liste est limitée à 1 000 lignes et ne montre pas forcément toutes les URL concernées. Exportez, puis regroupez par pattern d'URL avant de prendre la moindre décision. Si d'autres motifs du même rapport remontent en parallèle, notre guide pour faire indexer les pages de votre site indique la conduite à tenir pour chacun.
Sur un site e-commerce, un export regroupé ressemble à ça (exemple illustratif) :
Pattern URLsUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. Exemple
/recherche?q=* 412 /recherche?q=chaussure+rouge+42
/c/*?couleur=*&Accelerated Mobile Pages. Framework Google pour créer des pages mobiles ultra-rapides (moins utilisé aujourd'hui).;taille=* 287 /c/baskets?couleur=vert&taille=48
/p/* (fiches désactivées) 163 /p/sneaker-xyz-2023
/blog/tag/* 58 /blog/tag/promo-noel
redirections legacy vers / 21 /ancien-catalogue/sandales -> /

Cinq lignes, donc cinq décisions au lieu de 941 tickets. Pour chaque pattern, passez ensuite deux ou trois URL dans l'outil d'inspection et lancez « Tester l'URL active ». La capture d'écran et le HTML rendu vous disent tout de suite si Google voit un message d'erreur (problème de statut) ou un gabarit vide (problème de rendu). Les deux se corrigent de façon opposée.
Vérifier une URL à la main en une minute
Trois commandes montrent ce que le serveur répond vraiment et ce que la page dit :
curl -s -o page.html -L -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" \
  -w "%{http_code} %{size_download} %{num_redirects} %{url_effective}\n" \
  "httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.exemple.fr/p/sneaker-xyz-2023"

perl -0pe 's#<(script|style)\b.*?</\1>##gis; s#<[^>]+># #g' page.html \
  | grep -ioE "introuvable|existe plus|aucun (résultat|produit)|ne correspond|indisponible" | sort | uniq -c

grep -ioE '<meta[^>]*name="?robots"?[^>]*>' page.html
La première sort le code final, le poids du HTML, le nombre de redirections et l'URL d'arrivée. La deuxième cherche les formulations d'erreur dans le texte visible. Elle retire d'abord les scripts, parce qu'un message stocké dans un script (« Ce compte n'existe plus », dans les textes d'un formulaire de connexion) donnerait un faux positif. Adaptez la liste aux messages de vos gabarits, et évitez les apostrophes : beaucoup de sites les encodent en '. La troisième affiche la balise meta robots.
Pour lire le résultat :
- Un 200 nettement plus léger que les pages saines du même gabarit, avec un message d'erreur et sans noindex : soft 404 probable.
- Le même 200 avec un
noindex: en principe, Google la range sous « URL marquée "noindex" », hors des erreurs, et le statut n'a rien à corriger. - Un 200 après une redirection vers
/: redirection de masse. Le 13/10/2026, deux grands sites e-commerce français renvoyaient ainsi vers leur page d'accueil une fiche produit inventée. - Un 403 ou une page de défi : le site bloque curl ou les faux Googlebot, et le test ne dit rien de la page. La page de blocage peut même contenir « indisponible ». Relancez sans
-A: certains pare-feu refusent un user-agent Googlebot qui ne vient pas d'une IP de Google, et répondent normalement à une requête sans ce user-agent.
Le user-agent Googlebot est là parce que certains serveurs et CDNContent Delivery Network. Réseau de serveurs distribuant le contenu depuis le serveur le plus proche de l'utilisateur. ne répondent pas pareil aux robots et aux navigateurs.
Croiser avec les logs Googlebot
Le rapport Search Console ne montre qu'un échantillon. Les logs serveurFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots., eux, montrent ce que Googlebot explore chaque jour. Sur un log au format combined, cette commande liste les réponses 200 les plus légères servies à Googlebot, fichiers statiques exclus :
grep "Googlebot" access.log \
  | awk '$9 == 200 && $7 !~ /\.(js|css|png|jpe?g|gif|webp|avif|svg|ico|txt|xml|woff2?)([?&]|$)/ {print $10, $7}' \
  | sort -n | head -200
Le poids loggé est souvent celui de la réponse compressée : comparez des pages du même gabarit entre elles, jamais une fiche à une catégorie. Celle-ci compte les hits par famille d'URL (premier dossier, plus les noms de paramètres avec leurs valeurs masquées), pour mesurer le poids de chaque pattern suspect :
grep "Googlebot" access.log \
  | awk '$9 == 200 && $7 !~ /\.(js|css|png|jpe?g|gif|webp|avif|svg|ico|txt|xml|woff2?)([?&]|$)/ {print $7}' \
  | sed -E 's#^(/[^/?]*/?)[^?]*#\1#; s#=[^&]*#=*#g' \
  | sort | uniq -c | sort -rn | head -30
Raisonnez en part des hits Googlebot : combien de requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. partent sur /recherche, sur les combinaisons de filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. vides, sur les fiches désactivées, face aux fiches produit actives. Avec ce regroupement, une combinaison de filtres sort en /c/?couleur=*&taille=*, à part de la catégorie propre /c/. Deux limites : l'ordre des paramètres peut couper une même famille en deux lignes, et le premier dossier met fiches actives et désactivées dans la même famille /p/, à croiser avec l'export des fiches désactivées du back-office. Règle de priorisation : dès qu'une famille de soft 404 reçoit plus de visites Googlebot qu'une famille de pages qui font du chiffre d'affaires, elle passe en P0.
Deux pièges faussent l'analyse. Le premier, c'est d'analyser les logs de l'origine alors qu'un CDN sert une partie des réponses depuis son cache. Ces hits n'atteignent jamais l'origine et vous sous-estimez le volume, il vous faut les logs du CDN.
Le second, c'est de filtrer sur la chaîne « Googlebot » sans vérifier l'IP, alors qu'une partie du trafic qui se déclare Googlebot n'en est pas. Une résolution DNS inverse élimine les faux : pour Googlebot, host 66.249.66.1 doit renvoyer un nom du type crawl-66-249-66-1.googlebot.com, qui doit lui-même pointer vers la même IP. La méthode de vérification de Googlebot détaille les deux étapes.
Sa deuxième étape accepte aussi googleusercontent.com, pour les extracteurs déclenchés par un utilisateur : pour Googlebot, exigez le motif crawl-…googlebot.com. Un nom en bc.googleusercontent.com passe les deux étapes sans être Googlebot : le 13/10/2026, une IP de ce type s'est prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.ésentée en Googlebot dans les logs de notre site pour y chercher des fichiers .env.
La matrice de décision pour corriger chaque soft 404
Décidez du statut de chaque famille d'URL et inscrivez cette décision dans le code du CMS. Une correction qui ne vit que dans un fichier de redirections maintenu à la main saute au prochain import catalogue.

| Ce que vous observez | Cause probable | Réponse serveur cible | Action dans le code |
|---|---|---|---|
| Fiche désactivée, message « indisponible » | Route active sur produit supprimé | 301 si un équivalent réel existe, sinon 404 ou 410 | Hook de désactivation produit qui change le statut |
| Recherche interne à zéro résultat | Page générée à la volée | 404, ou 200 + noindex | Statut conditionné au nombre de résultats |
| Catégorie vide sur la durée | Gamme arrêtée, stock absent depuis des semaines | 404, ou 200 + noindex | Règle automatique selon la durée sans stock |
| Catégorie en rupture de quelques jours | Stock temporaire | 200 indexable, avec des produits proches | Afficher des alternatives tant que le stock manque |
| Ancienne URL redirigée vers la home | Règle catch-all | 404, ou 301 vers l'équivalent exact | Supprimer la règle, mapper les URL qui ont des backlinksLien provenant d'un site externe pointant vers votre site. Facteur de ranking majeur. |
| Page légitime mais gabarit vide au rendu | API, base de données, include ou JS en échec | 200 après correction | Corriger le rendu, renvoyer un 5xx si la dépendance tombe |
Si la page doit exister, réparez le rendu avant le texte
Un gabarit vide à l'inspection veut dire que le bloc principal ne s'affiche pas pour Google. Trois paragraphes de plus n'y changeront rien si ce sont les données produit qui ne chargent pas. Corrigez la dépendance, puis faites en sorte qu'une panne renvoie un 503 plutôt qu'un 200 vide : Google ralentit alors l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. et garde la page dans l'index le temps de la panne, au lieu de la classer en soft 404. Si la panne dure, la page finit quand même par sortir.
Si la page s'affiche bien mais reste très pauvre (fiche sans description, catégorie avec un seul produit), là, oui, c'est un sujet de contenu. Posez-vous quand même la question honnête avant d'écrire : cette page mérite-t-elle d'être indexée ? Une fiche qui ne répond à aucune recherche et n'apporte rien de plus que sa catégorie peut très bien rester hors de l'index.
Si la page a été déplacée
Une 301 vers un équivalent réel : même produit sous une nouvelle référence, successeur direct, catégorie renommée. Le test : un internaute arrivé par l'ancienne URL trouve-t-il ce qu'il cherchait sur la nouvelle ? Si la réponse est « à peu près », ce n'est pas un équivalent, et Google risque de traiter la redirection comme une soft 404.
Si la page n'existe plus
Une 404 ou une 410, avec une page d'erreur utile pour l'humain : recherche, catégories principales, produits proches. Google le dit dans sa page d'aide sur les erreurs d'exploration : la page 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. personnalisée peut aider l'internaute, à condition de renvoyer le code 404.
Côté Google, la question est tranchée : toutes les erreurs 4xx, sauf la 429, sont traitées de la même façon. La 410 garde un intérêt de lisibilité pour vos équipes, sur des suppressions en masse assumées. Franchement, le débat 404 contre 410 coûte en général plus de temps qu'il ne rapporte.
Si la page doit rester accessible mais non indexée
Une balise meta robots noindex, ou un en-tête X-Robots-Tag: noindex pour les ressources non HTML. L'URL reste explorable, Google lit la directive et la page sort de l'index sans compter comme une erreur. C'est la bonne réponse pour les pages utiles au parcours mais sans valeur de recherche, et pour les catégories vides sur la durée.
Le noindex ne fait en revanche économiser aucune exploration : le guide de Google sur le budget d'exploration rappelle que Google enverra quand même une demande d'exploration. Pour une rupture de quelques jours, gardez plutôt la catégorie en 200 avec des produits proches : au retour du stock, une page passée en noindex ne revient dans l'index qu'après le prochain passage de Googlebot.
Le robots.txt vient après la correction
Bloquer un pattern de soft 404 dans le robots.txt empêche Googlebot de l'explorer, donc de constater que la page est vide. Les URL déjà connues peuvent rester indexées sans contenu, et vous ne pouvez plus transmettre ni 404 ni noindex. Le robots.txt a sa place après coup, pour fermer des espaces d'exploration infinis une fois qu'ils sont proprement désindexés.
Exception : les espaces qui n'ont jamais été indexés et n'ont pas à l'être, facettes ou recherche interne. Vous pouvez les fermer dès le départ, il n'y a rien à désindexer. Pour les facettes, la doc de Google sur la navigation à facettes va plus loin : si vous n'avez pas besoin que ces URL soient indexées, elle conseille d'en empêcher l'exploration dans le robots.txt. Sur des facettes déjà indexées, passez d'abord par la 404 pour les combinaisons vides et par le noindex pour les autres.
Une fois le correctif en ligne, le bouton « Valider la correction » de la Search Console relance une vérification. Google annonce en général deux semaines environ, parfois beaucoup plus. Si de nouvelles URL du même pattern apparaissent entre-temps, la règle qui les génère tourne toujours.
Soft 404 en e-commerce, sur WordPress et en JavaScript
Chaque plateforme a son point faible : la fiche qui se vide en e-commerce, les archives et plugins sur WordPress, la route qui répond 200 à tout en JavaScript.
Produit en rupture ou retiré du catalogue
Une rupture temporaire ne pose pas de problème si la fiche reste complète : gardez le 200, affichez la disponibilité et passez availability à OutOfStock dans les données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets. Product. Une fiche qui se réduit à « produit indisponible », elle, risque d'être classée en soft 404. Pour un retrait définitif, revenez à la matrice : 301 vers le successeur, un équivalent réel ou la catégorie si elle répond à la même demande, sinon 404 ou 410.
Catégories, filtres et recherche interne à zéro résultat
C'est le gros réservoir. Chaque combinaison de filtres crawlable peut produire une page vide, et une navigation à facettes en génère des milliers. La doc de Google sur les facettes, citée plus haut, pose la règle de base : renvoyer une 404 quand une combinaison de filtres ne donne aucun résultat. Ajoutez deux règles de votre côté : ne pas rendre en HTML les liens vers les combinaisons vides, et passer en noindex celles que vous devez garder accessibles.
La recherche interne, elle, n'a presque jamais vocation à être explorée. Si elle n'a jamais été indexée, fermez-la dans le robots.txt. Sinon, passez-la d'abord en noindex (404 à zéro résultat), puis fermez-la une fois les URL sorties de l'index.
WordPress : archives, pièces jointes et plugins de redirection
Sur WordPress, les suspects habituels sont les archives de tags maigres, les archives d'auteur sur les sites mono-auteur et les pages de pièces jointes. Depuis la version 6.4, les nouvelles installations redirigent les pièces jointes vers le fichier, mais les sites mis à jour gardent l'ancien comportement. Les plugins qui « redirigent toutes les 404 vers l'accueil » sont à désinstaller : ils fabriquent exactement la soft 404 décrite plus haut.
Les SPA qui répondent 200 à tout
Une application rendue côté client renvoie le même index.html avec un 200 pour n'importe quelle route, y compris celles qui n'existent pas. La documentation JavaScript SEO de Google propose deux sorties : rediriger en JavaScript vers une URL pour laquelle le serveur renvoie un vrai 404, ou injecter un noindex quand la route ne résout rien. Le même site a souvent d'autres failles, comme des liens sans href ou un noindex retiré par script, recensées dans nos bonnes pratiques JavaScript et SEO.
Les frameworks avec rendu serveur règlent le problème proprement, à condition que les devs appellent la fonction prévue (notFound() sur Next.js, par exemple) au lieu d'afficher un composant d'erreur. Sur Next.js, appelez notFound() avant le début du streaming : dans un bloc déjà en cours d'envoi, la réponse garde son 200 et Next.js ajoute seulement un noindex.

Ce que les soft 404 coûtent vraiment
Le coût le plus concret, c'est l'exploration. Le guide de Google sur le budget d'exploration le dit en toutes lettres : les soft 404 continuent d'être explorées et consomment inutilement une partie de ce budget. Une vraie 404 voit sa fréquence d'exploration baisser avec le temps. Une soft 404, elle, ressemble à une page vivante, donc Googlebot revient.

Le même guide vise trois profils : plus d'un million de pages dont le contenu change chaque semaine, plus de 10 000 pages dont le contenu change chaque jour, ou une proportion importante d'URL classées « Détectée, actuellement non indexée ». Les deux premiers disent que le budget d'exploration concerne surtout les gros sites. Le troisième ne dépend pas de la taille, et c'est souvent celui d'un catalogue moyen dont les facettes ou la recherche interne génèrent des milliers d'URL vides : Googlebot passe son temps sur ces pages pendant que les nouvelles fiches attendent. Sur un blog de 300 pages, quelques soft 404 ne bloquent rien.
Le dernier coût est moins discuté, et c'est celui qui me gêne le plus. La requalification en soft 404 est une décision de Google. Rien ne garantit que les autres robots, crawlers des moteurs IA compris, fassent la même analyse. Une page qui répond 200 avec « produit introuvable » peut très bien être récupérée comme source valide.
Je n'ai pas de chiffres pour mesurer l'ampleur du phénomène, mais une analyse de logs tournée vers les crawlers IA vous dit au moins lesquels passent sur ces URL. Si votre objectif est d'être cité par les moteurs génératifs, un code HTTP honnête protège mieux votre citabilité qu'un rapport Search Console à zéro.
Garder les codes HTTP sous contrôle après la correction
Une soft 404 corrigée revient par les mêmes portes : un import catalogue, une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. de template, un plugin mis à jour. Le contrôle a donc sa place dans le cycle de déploiement. Un audit annuel arrive trop tard.

Le minimum, c'est une liste d'URL témoins par gabarit (fiche active, fiche désactivée, catégorie vide, recherche sans résultat, URL inventée) que vous testez à chaque mise en production avec les commandes vues plus haut, sans l'option -L pour lire le code que renvoie l'URL elle-même. Le pipeline échoue si une URL inventée renvoie autre chose que 404, si une fiche désactivée renvoie 200, ou si une page qui doit rester en noindex perd sa balise. Côté monitoring, suivez chaque semaine la part des hits Googlebot sur les patterns à risque : vous verrez une régression bien avant que la Search Console ne l'affiche.
Les moments où un nouvel audit s'impose sont prévisibles : migration, refonte du listing, changement de moteur de recherche interne, ajout de facettes. Pour une migration, le crawl de toutes les anciennes URL fait partie de la checklist de migration SEO : une redirection vers une page sans rapport s'y repère avant que Google ne la classe en soft 404. Le reste du temps, méfiez-vous d'un rapport soft 404 qui reste stable : la liste n'est qu'un échantillon, et un pattern toujours exploré peut très bien ne pas y figurer.
Questions fréquentes
Une soft 404 peut-elle pénaliser tout le site ?
Il n'y a pas de pénalité au sens manuel. Les pages concernées sortent de l'index, le domaine n'est pas sanctionné. L'effet global passe par l'exploration : Googlebot détourné des pages utiles, nouveautés indexées plus lentement. Sur un petit site, l'impact est négligeable. Sur un catalogue avec des facettes ou une recherche interne crawlable, il se voit dans les logs.
Une page 404 personnalisée avec beaucoup de contenu pose-t-elle un problème ?
Non, tant que le code renvoyé est bien 404. Vous pouvez y mettre un moteur de recherche, des catégories, des produits populaires : Google lit le statut et n'utilise pas le contenu de la page. Le risque est dans l'autre sens. Une page d'erreur très riche servie avec un 200 ressemble à une vraie page, et c'est exactement comme ça qu'on fabrique une soft 404.
Que faire d'une soft 404 qui reçoit des backlinks ?
Si un équivalent réel existe, une 301 vers cet équivalent récupère la valeur des liens et sert l'internaute. Sinon, une 404 propre vaut mieux qu'une redirection vers la home : les liens ne transmettront plus rien, mais vous n'ajoutez pas de signal trompeur. Faites ce tri sur les URL qui ont des référents, inutile de passer tout le rapport. Pour trancher URL par URL entre 301, 404 et maintien en 200, appuyez-vous sur la grille du guide pratique des redirections SEO.
Une page en noindex peut-elle apparaître dans le rapport soft 404 ?
En principe, une page en noindex remonte sous le motif « URL marquée "noindex" ». Si une URL que vous croyez en noindex apparaît en soft 404, c'est en général que la directive n'est pas lue : injectée trop tard en JavaScript, absente de la version servie à Googlebot, ou posée sur une variante de l'URL (paramètre, slash final) mais pas sur celle que Google explore. L'inspection d'URL vous montre ce que Google a vraiment reçu.
Sources
- Effet des codes d'état HTTP sur les robots d'exploration Google, Google Search Central
- Résoudre les problèmes d'exploration de la recherche Google, Google Search Central
- Migrations de sites, Google Search Central
- Rapport sur l'indexation des pages, Aide Google
- Valider les requêtes des robots d'exploration et des extracteurs Google, Google Search Central
- Gérer l'exploration des URL de navigation à facettes, Google Search Central
- Changes to attachment pages, WordPress
- Comprendre les bases du SEO JavaScript, Google Search Central
- Gestion du budget d'exploration, Google Search Central
- Functions: notFound, Next.js
- Outil d'inspection d'URL, Aide Google
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Présentation du fichier robots.txt et guide, Google Search Central
- Comment ajouter des données structurées spécifiques à un extrait produit, Google Search Central