




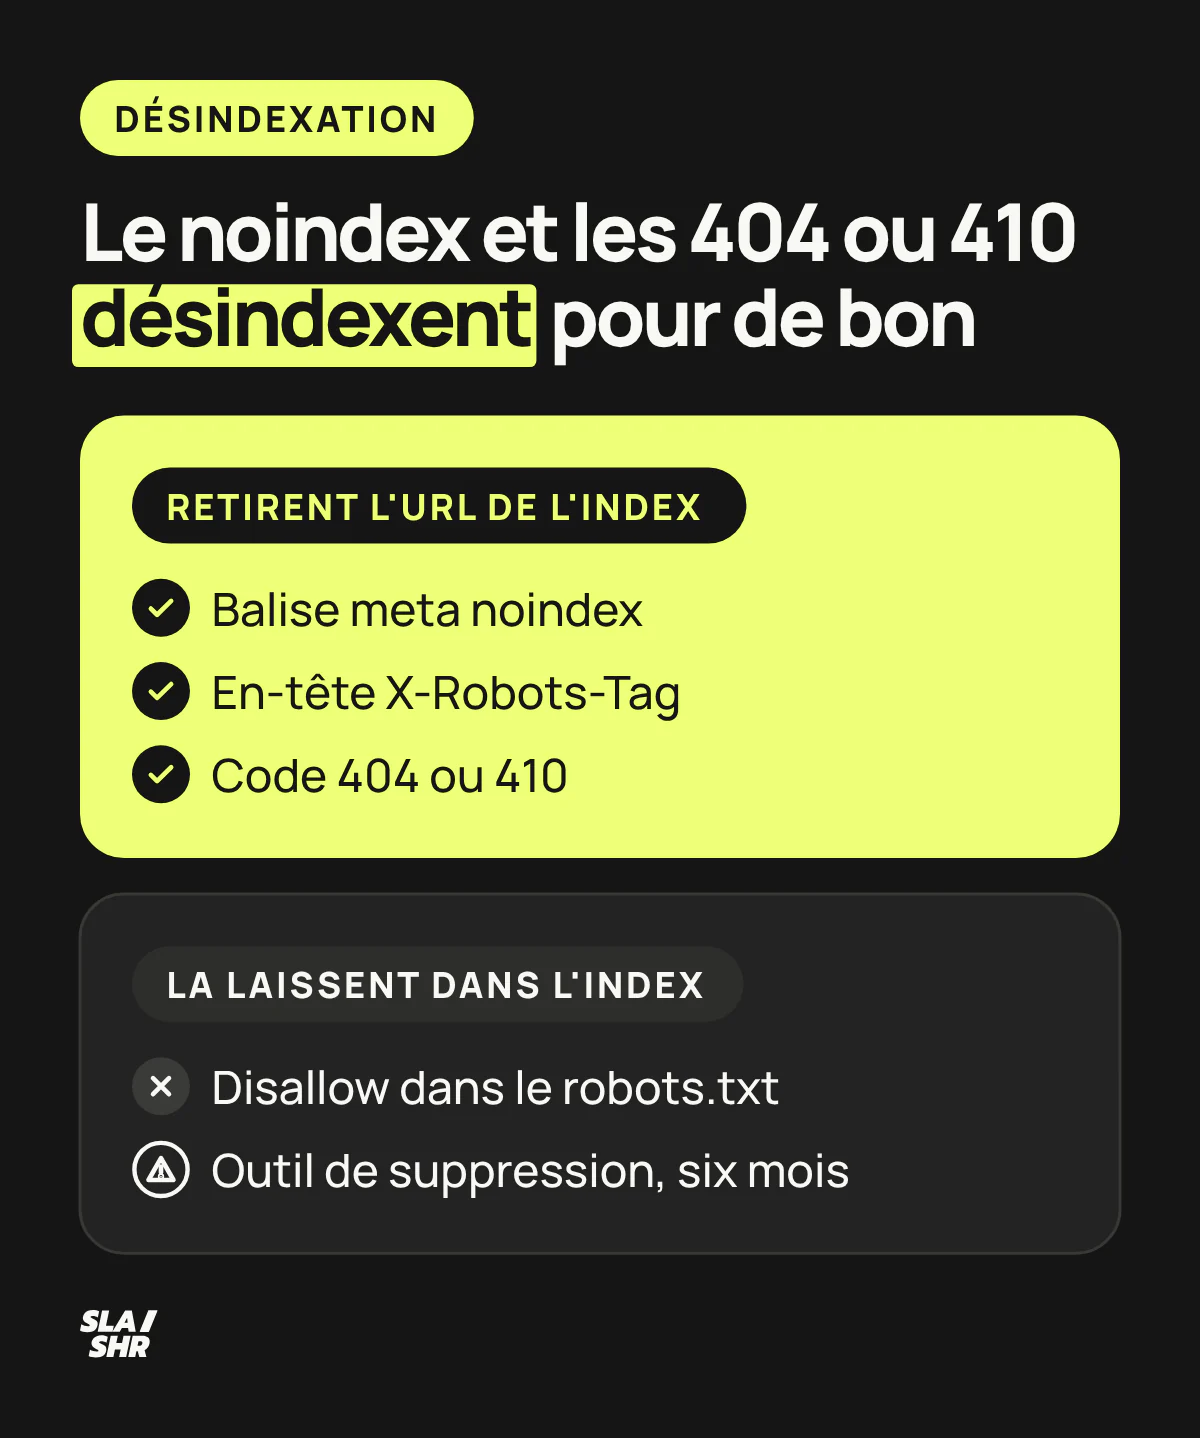
Pour désindexer une URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. de Google, laissez-la accessible à GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. et posez une balise meta robots noindexDirective indiquant aux moteurs de ne pas indexer une page., ou supprimez-la avec un code 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. ou 410. L'outil de suppression de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. la masque vite, mais pour six mois. Un Disallow dans le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. ne la sort pas de l'index.
Quelle méthode pour quelle page ?
La méthode dépend de ce que devient la page : elle reste en ligne, elle disparaît, elle double une autre page, ou elle contient une information qui doit sortir des résultats tout de suite.
| Situation | Méthode | Ce que Google en fait |
|---|---|---|
| Page qui reste accessible aux visiteurs | Balise meta robots noindex | Retire la page de l'index au prochain passage |
| PDF, image, fichier non HTML | En-tête HTTP X-Robots-Tag: noindex | Même effet que la balise, sans toucher au fichier |
| Page supprimée sans équivalent | Code 404 ou 410 | Retire l'URL de l'index une fois le code constaté |
| Page remplacée par une autre | Redirection 301 | La page cible prend la place de l'ancienne |
| Doublon d'une page que vous gardez | Balise canonical | Regroupe les doublons et affiche une seule version |
| Préproduction, espace réservé | Mot de passe | Googlebot n'accède plus au contenu |
| Information confidentielle publiée par erreur | Outil de suppression, puis une méthode durable | Masque l'URL en une journée environ, pour six mois environ |
Une règle tient pour toute la grille : Google doit pouvoir revenir sur l'URL et constater la consigne. Sans visite de Googlebot, rien ne bouge. Une balise noindex qu'il ne lit pas, ou une 404 qu'il ne revoit pas, laisse l'index en l'état.
Pour un contenu sensible, gardez en tête une nuance de l'aide de Google : parmi les méthodes de suppression définitive, la balise noindex est présentée comme la moins sûre de toutes. Google ne détaille pas pourquoi, mais la raison saute aux yeux : la page reste publique pour qui a le lien. Pour un document sensible, c'est un vrai risque. Supprimer la page ou la protéger par un mot de passe règle le problème à la source.

Des centaines d'URL à sortir d'un coup après une refonte ou une migration ? Le tri se fait par gabarit, avant de poser la moindre consigne : c'est l'objet d'un accompagnement SEO de refonte et de migration.
Les pages qu'on sort de l'index
On sort de l'index les pages qui n'apportent rien à quelqu'un qui arrive de Google, et celles qui n'auraient jamais dû être publiques. Quatre familles reviennent, chacune avec sa méthode.
- Les résultats de recherche interne : des pages générées à la volée, sans contenu propre. Une balise noindex sur le gabarit les sort de l'index ; une fois sorties, un Disallow sur leur répertoire évite de faire explorer cet espace d'URL sans fin.
- Les pages dupliquées : plusieurs URL pour un même contenu (paramètres de suivi, versions imprimables). Ici, la canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. fait mieux que le noindex. Pour les URL de tri et de filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. d'un catalogue, le guide des filtres à facettes en SEO donne la consigne type d'URL par type d'URL.
- Les contenus obsolètes : une offre terminée, un événement passé. Redirection 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. vers la page qui a pris le relais, ou 404 s'il n'y en a pas.
- Le contenu confidentiel : un document interne, une page de test, parfois indexés à votre insu. Outil de suppression pour l'urgence, puis suppression ou mot de passe. Si la page est hébergée chez un partenaire, c'est à lui d'agir : il faut être propriétaire du site dans la Search Console pour utiliser cet outil.
Sur les doublons, Google est clair : le contenu en doubleContenu identique ou très similaire accessible via plusieurs URLs. Peut diluer le ranking. sur un site est normal et n'enfreint pas ses règles concernant le spamTechniques manipulatrices visant à tromper les moteurs de recherche.. Aucune sanction à craindre. L'enjeu est de choisir la version qui s'affiche, et Google déconseille le noindex pour ça : la balise canonical reste l'outil prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.évu pour indiquer la page à garder.
Sur un gros site, ces pages prennent aussi une part de l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. de Googlebot au détriment des pages utiles. Le sujet est détaillé dans l'article sur le budget de crawl.

La balise noindex et l'en-tête X-Robots-Tag
Pour une page qui reste en ligne, la balise meta robots noindex dans le head suffit. Un PDF n'a pas de head. La même consigne passe alors par l'en-tête HTTP X-Robots-Tag, que le serveur envoie avec le fichier.
La balise meta robots
Placez la balise dans la section <head> de la page. La première version s'adresse à tous les moteurs, la seconde à Google seulement :
<meta name="robots" content="noindex">

<meta name="googlebot" content="noindex">
La plupart des CMS et des extensions SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. posent cette balise via une case à cocher. Contrôlez le résultat dans le code source, puis dans l'inspection d'URL de la Search Console, qui montre le HTML que Googlebot a réellement reçu. Une balise ajoutée par un script trop tard, ou posée sur une variante de l'URL, passe inaperçue à l'œil.
La documentation de Google prévient aussi que certains moteurs de recherche peuvent interpréter la règle noindex différemment. Si un autre moteur compte dans votre trafic, vérifiez la page dans ses propres outils.

noindex, nofollow, none : ce que fait chaque règle
Chaque règle a un périmètre précis :
noindexdemande de ne pas afficher la page dans les résultats de recherche.nofollowAttribut indiquant aux moteurs de ne pas suivre un lien ou de ne pas transmettre de jus SEO.demande de ne pas suivre les liens de cette page. Googlebot consulte toujours la page elle-même : la règle porte sur ses liens sortants et ne bloque pas l'exploration.noneéquivaut ànoindex, nofollow.
Pour désindexer, le noindex seul suffit dans presque tous les cas. Ajouter nofollow coupe en plus la découverte des pages liées depuis celle-ci, ce qui est rarement le but sur une page de recherche interne ou une ancienne actualité. Retirer les liens vers une page, en les supprimant ou par obfuscation de liens, la laisse dans l'index : Google la connaît déjà, et c'est le noindex qui l'en sort.
L'en-tête X-Robots-Tag pour les PDF et les images
La consigne voyage dans la réponse HTTP du serveur, qui ressemble à ceci quand tout est en place :
HTTP/1.1 200 OK
X-Robots-Tag: noindex
Ce bloc est ce que le serveur renvoie. Le coller tel quel dans le .htaccess est l'erreur classique. Sur Apache, Google donne plutôt cet extrait à ajouter à la racine du fichier .htaccess ou httpd.conf du site, ici pour tous les PDF :
<Files ~ "\.pdf$">
  Header set X-Robots-Tag "noindex, nofollow"
</Files>
Testez ensuite un fichier avec curl -I httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.votremarque.fr/docs/guide.pdf et cherchez la ligne X-Robots-Tag dans la réponse. Faites le même test sur une page HTML ordinaire : un motif trop large dans la règle peut envoyer le noindex sur tout le site.
Pour les images, Google accepte deux voies : une règle robots.txt (User-agent: Googlebot-Image pour Google Images, User-agent: Googlebot pour tous ses services de recherche), ou l'en-tête X-Robots-Tag avec noindex. Ces deux méthodes ont le même effet, précise sa documentation. Pour la vidéo et l'audio, la page de Google sur le robots.txt ouvre la même voie : le fichier peut empêcher les fichiers image, vidéo et audio d'apparaître dans les résultats de recherche. Pour une page HTML, la règle reste le noindex.
Supprimer la page : 404, 410 ou redirection 301
Une page que vous retirez du site sort de l'index quand Google constate un code 404 ou 410 sur son URL. Si une page équivalente existe, une redirection 301 sert mieux l'internaute : il arrive sur la page qui a pris le relais.
Côté Google, les deux codes se valent. Les URL déjà indexées qui renvoient un code 4xx sont supprimées de l'index, et toutes les erreurs 4xx, sauf la 429, sont traitées de la même manière. Le code 410 signifie « Gone » en HTTP : la ressource a disparu pour de bon. L'aide française de la Search Console le traduit par « Déplacé », une traduction qui prête à confusion, puisqu'un contenu déplacé appelle une redirection.
Le piège classique est la page supprimée qui répond encore 200 avec un message « page introuvable ». Google la requalifie en soft 404 mais continue de l'explorer. Vérifiez le code réel avec curl -I sur l'URL, sans suivre les redirections.
Quand la page a des backlinksLien provenant d'un site externe pointant vers votre site. Facteur de ranking majeur. ou du trafic, et qu'une page couvre le même besoin, la redirection 301 est le bon choix : Google la lit comme un signal fort que la cible de la redirection doit devenir canonique, et la cible prend en principe la place de l'ancienne URL dans les résultats. Le choix entre 301, 302Redirection temporaire ne transférant pas le jus SEO. À utiliser avec précaution. et 308, et la façon d'éviter les chaînes, sont détaillés dans le guide pratique des redirections SEO.
Reste le doublon que vous voulez garder en ligne pour les visiteurs. La canonical regroupe les pages en double et Google affiche une seule version dans ses résultats. C'est un signal fort, et Google garde la main : il détermine lui-même les pages en double à partir de la similarité du contenu.

Pourquoi le robots.txt ne désindexe pas ?
Le robots.txt contrôle l'exploration, et Google l'écrit en toutes lettres : il ne sert pas à empêcher qu'une page web figure dans les résultats de recherche Google. Pire, il empêche la désindexation quand il bloque une page qui porte un noindex.
Si une page est exclue de l'exploration par le robots.txt, Googlebot ne lit plus son code, et la balise noindex devient invisible. Résultat : l'URL peut rester dans l'index, souvent sans description. Google peut même indexer une URL bloquée qu'il n'a jamais explorée, si elle est référencée ailleurs sur le web. Le rapport d'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. la signale sous le motif « Indexée malgré le blocage par le fichier robots.txt ». Dernière limite : Googlebot respecte le fichier, d'autres robots peuvent l'ignorer.
Si vous avez bloqué des pages à désindexer, l'ordre de correction compte :
- Retirez le Disallow qui vise ces URL dans le robots.txt.
- Laissez ou posez la balise noindex, ou le code 404 ou 410.
- Demandez une nouvelle exploration dans l'inspection d'URL pour les pages prioritaires.
- Attendez que la Search Console les classe sous « URL marquée "noindex" », « Introuvable (404) » ou un autre motif 4xx pour une 410.
- Ne remettez un Disallow que si l'exploration de ces URL pose un vrai problème de charge, en sachant qu'une URL bloquée et liée ailleurs peut revenir dans l'index sans contenu.
Le rôle exact du fichier, ses directives et ses pièges sont détaillés dans le guide pour gérer le robots.txt en SEO. Pour la différence entre exploration et indexation, voyez comment fonctionne le crawl de Google.

Retirer une URL en urgence avec l'outil de suppression
Pour une urgence, l'outil de suppression fait disparaître une URL de votre site des résultats Google en une journée environ, si la demande est acceptée. Le masquage dure six mois environ. Sans méthode durable derrière, l'URL peut revenir à l'expiration de la demande.
Dans l'outil de suppression, onglet « Suppressions temporaires », cliquez sur « Nouvelle demande ». Deux options s'offrent à vous :
- « Supprimer temporairement l'URL » : la page disparaît des résultats pendant environ six mois. Google continue d'explorer la page pendant ce temps : le blocage ne porte que sur l'affichage.
- « Effacer l'extrait dans la recherche » : la page reste visible, mais son extrait disparaît jusqu'à ce qu'elle soit réindexée. Utile quand le contenu a déjà été corrigé.
Pendant ces six mois, posez la solution définitive : suppression avec 404 ou 410, mot de passe, ou noindex. Six mois passent vite. Une demande faite par erreur s'annule depuis l'historique, via le menu à côté de la demande et l'option « Annuler la demande ».
L'outil a deux autres onglets qui ne servent pas à désindexer vos pages. « Contenu obsolète » liste les demandes faites par des personnes qui ne sont pas propriétaires du site, pour mettre à jour un résultat qui ne correspond plus à la page. « Filtrage SafeSearch » liste les URL signalées par des internautes comme contenu réservé aux adultes : après examen par Google, une URL filtrée n'apparaît plus pour ceux qui ont activé SafeSearch.
Saisir la bonne URL ou le bon préfixe
Une demande vise une adresse exacte, ou toutes les adresses qui commencent par un préfixe. Il faut donc lire l'URL segment par segment. Cette adresse se compose de cinq éléments, sans compter les paramètres éventuels (?tri=prix) :
- le protocole (
https://), la façon dont le navigateur accède à la page ; - le sous-domaine (
www.,blog.,preprod.), un préfixe placé avant le nom de domaine qui peut héberger un site ou une section distincte ; - le nom de domaine avec son extension (
votremarque.fr) ; - le répertoire (
/blog/), la section du site ; - le nom de la page, ou slugPartie de l'URL identifiant une page spécifique, généralement après le nom de domaine. (
desindexer-url), qui décrit son contenu.
L'option « Supprimer toutes les URL avec ce préfixe » couvre les versions www, sans www, http et https. Un autre sous-domaine reste hors du périmètre : bloquer une préproduction indexée ne masque pas le site principal, et inversement. Faites une demande par sous-domaine, puis protégez la préproduction par un mot de passe.

Accélérer puis vérifier la désindexation
Demandez une nouvelle exploration dans l'outil d'inspection d'URL, puis vérifiez le statut dans ce même outil. La commande site: sert d'indice, le verdict vient de l'inspection d'URL.
Pour quelques URL, l'inspection d'URL de la Search Console permet de demander l'exploration. Un quota limite l'envoi d'URL individuelles, et les demandes répétées pour une même URL n'accélèrent pas l'exploration : une demande par page suffit. Pour un grand nombre d'URL, Google conseille d'envoyer un sitemap qui les liste.
Côté délais, Google annonce que l'exploration peut prendre plusieurs jours, voire plusieurs semaines. Pour une page peu importante, Googlebot peut mettre des mois à revenir. Soyez patient. Ou passez par l'outil de suppression quand l'affichage pose un vrai problème.
Pour vérifier, trois contrôles valent mieux qu'un :
- L'inspection d'URL indique si l'URL est dans l'index et affiche le HTML exploré : vous y retrouvez la balise noindex, ou le code 404.
- Le rapport Indexation des pages range l'URL sous « URL marquée "noindex" », « Introuvable (404) » ou un autre motif 4xx pour une 410, une fois la consigne prise en compte.
- La recherche site:votremarque.fr/ma-page sert de contrôle rapide, avec une limite que Google rappelle lui-même : l'opérateur site: ne renvoie pas nécessairement toutes les URL indexées. Une page absente de site: n'est donc pas forcément sortie de l'index.

Site désindexé sans le vouloir : causes et solutions
Quand des pages, ou un site entier, disparaissent de Google sans que vous l'ayez demandé, commencez par la Search Console. Les causes techniques y laissent une trace : rapport Indexation des pages, inspection d'URL, rapport Actions manuelles.
| Cause | Où la repérer | Correction |
|---|---|---|
| Noindex resté après une mise en ligne (préproduction, refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée., case cochée dans le CMS) | « URL marquée "noindex" » | Retirer la balise ou l'en-tête, puis demander l'exploration |
| Disallow trop large dans le robots.txt | « URL bloquée par le fichier robots.txt », « Indexée malgré le blocage » | Corriger la règle, tester les URL clés dans l'inspection d'URL |
| Erreurs serveur répétées | « Erreur serveurCode HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. (5xx) » | Rétablir le serveur : Google supprime de l'index les URL qui renvoient continuellement une erreur de serveur |
| 404 en série après une migration | « Introuvable (404) » | Rediriger chaque ancienne URL vers son équivalent |
| Canonical qui pointe vers une autre page | Inspection d'URL, canonique sélectionnée par Google | Corriger la balise sur le gabarit |
| Demande de suppression oubliée | Historique de l'outil de suppression | Annuler la demande |
| Action manuellePénalité appliquée manuellement par un employé Google pour violation des guidelines. | Rapport Actions manuelles | Corriger le problème signalé, puis demander un réexamen |
Pour les 404 en série, le remède se prépare avant la bascule : un plan de redirection qui associe chaque ancienne URL à sa nouvelle adresse. L'action manuelle est le cas le plus lourd : si un site en fait l'objet, il ne s'affiche pas, en totalité ou en partie, dans les résultats de recherche Google.
Un cas ressemble à une désindexation sans en être une : la page explorée que Google choisit de ne pas indexer, sans aucune consigne de votre part. Le diagnostic est différent, il est détaillé dans l'article sur le statut explorée, actuellement non indexée.
Les deux premières causes du tableau sont les plus faciles à provoquer soi-même. Un oubli suffit. La préproduction était en noindex ou en Disallow pour de bonnes raisons, et la consigne part en ligne avec le reste au moment de la mise en production. Le remède tient en une ligne de recette : vérifier la balise robots et le robots.txt à chaque déploiement.

Questions fréquentes
Combien de temps faut-il pour qu'une page soit désindexée ?
Le temps que Googlebot revienne sur la page et constate le noindex ou le code 404. Google parle de plusieurs jours, voire plusieurs semaines après une demande d'exploration, et de plusieurs mois pour une page peu importante qu'il visite rarement. Pour un affichage qui pose problème tout de suite, l'outil de suppression masque l'URL en une journée environ si la demande est acceptée, pour six mois seulement.
Peut-on désindexer une page sans la supprimer du site ?
Oui, c'est le rôle de la balise meta robots noindex. La page reste accessible aux visiteurs et aux liens internesEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs., elle sort seulement des résultats de recherche. Pour un PDF ou une image, l'en-tête X-Robots-Tag fait la même chose.
Faut-il ajouter nofollow à une page en noindex ?
Rarement. La règle nofollow demande de ne pas suivre les liens de la page. Elle n'ajoute rien à la désindexation, et Googlebot continue de consulter la page. Gardez noindex seul, sauf si les liens de la page mènent vers des URL que vous ne voulez pas faire découvrir.
Comment désindexer un site de préproduction ?
Protégez-le par un mot de passe : Googlebot n'accède plus au contenu, et les visiteurs de passage non plus. Si des pages sont déjà dans Google, ajoutez une demande de suppression par préfixe sur ce sous-domaine, depuis une propriété Search Console qui le couvre. Elle les masque pendant que la protection fait effet. Une demande sur le site principal ne couvre pas la préproduction.
Sources
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Spécifications des balises Meta pour les robots, Google Search Central
- Supprimer les images de votre propre site de la recherche Google, Google Search Central
- Effet des codes d'état HTTP sur les robots d'exploration Google, Google Search Central
- Suppressions et outil de création de rapports SafeSearch, Aide Google
- Spécifier une URL canonique avec rel="canonical" et d'autres méthodes, Google Search Central
- En quoi consiste le choix de l'URL canonique ?, Google Search Central
- Présentation du fichier robots.txt et guide, Google Search Central
- Rapport sur l'indexation des pages, Aide Google
- Removals and SafeSearch reports tool, Aide Google
- Demander à Google d'explorer de nouveau votre site Web, Google Search Central
- Comment utiliser l'opérateur de recherche "site", Google Search Central
- Rapport sur les actions manuelles, Aide Google
- Gestion du budget d'exploration, Google Search Central