




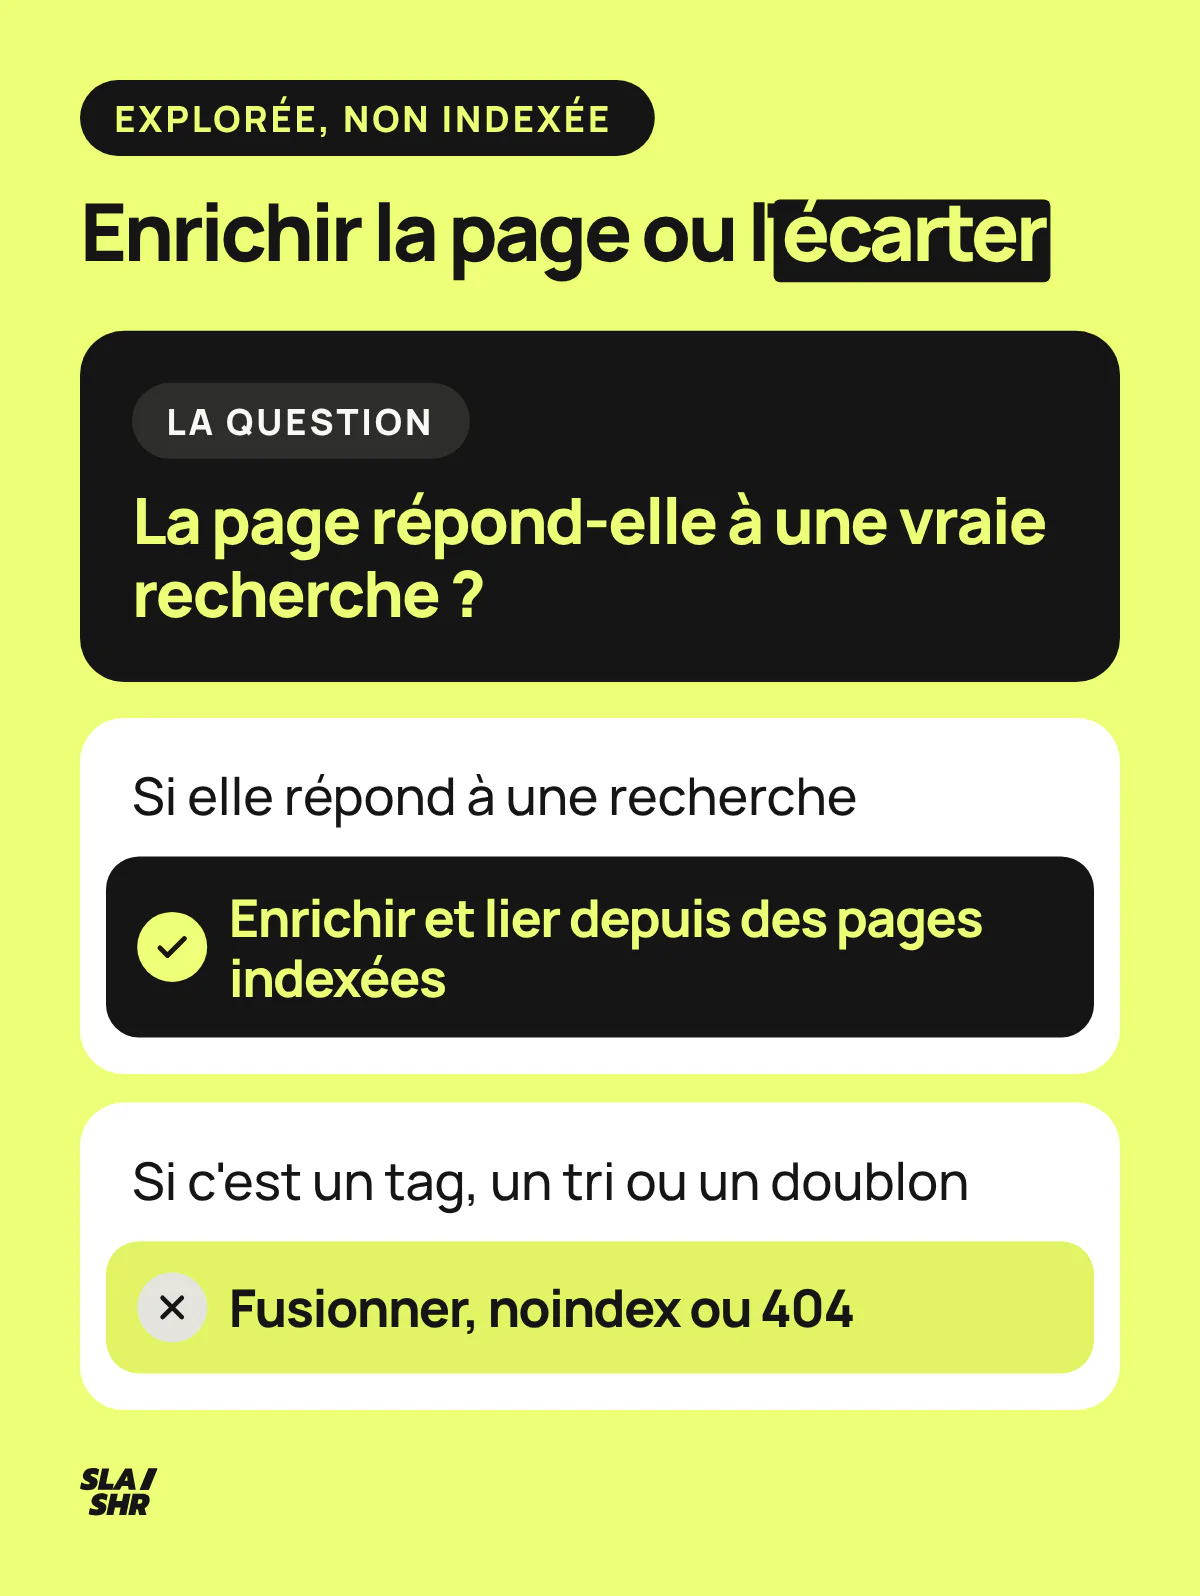
« Explorée, actuellement non indexée » veut dire que GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. a récupéré la page, puis que Google a choisi de ne pas l'indexer, pour l'instant. Rien ne bloque l'accès : c'est un jugement sur la page. Vous la rendez indexable ou vous la sortez proprement.
Ce que Google vous dit avec ce statut
Google a exploré l'URL, il l'a peut-être rendue, et il a décidé de ne pas l'indexer à ce stade. Selon le rapport d'indexation des pages, la page a été explorée mais pas indexée, elle sera peut-être indexée à l'avenir, et il n'est pas nécessaire de renvoyer cette URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. pour l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web..
Trois choses en découlent. D'abord, la page est accessible : une URL bloquée par le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., en noindexDirective indiquant aux moteurs de ne pas indexer une page., en 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. ou en erreur serveurCode HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. remonte sous un autre motif du même rapport. Ensuite, le statut n'a rien de définitif. Une page améliorée peut entrer dans l'index au passage suivant.
Enfin, Google ne promet pas d'indexer tout votre site : la même page d'aide rappelle que certaines URL ne sont pas indexées parce qu'il s'agit de doublons ou parce qu'elles ne contiennent pas d'informations significatives.

Une page non indexée n'est donc pas forcément un problème. Une archive de tag ou une page de tri qui reste hors de l'index, c'est souvent la bonne issue. Le statut devient un problème quand il touche des pages qui devraient ranker : fiches produits, articles, pages de catégories.
Explorée ou détectée : deux statuts, deux problèmes opposés
« Détectée, actuellement non indexée » veut dire que Google connaît l'URL sans l'avoir explorée. En règle générale, il voulait l'explorer, mais l'exploration a été reportée, car le site risquait d'être surchargé : la dernière date d'exploration ne figure donc pas dans le rapport.
La différence se lit dans l'outil d'inspection d'URL, à la ligne « Dernière exploration ». Elle tranche tout de suite. Une date : Google a lu la page, la question porte sur sa valeur. Pas de date : Google ne l'a jamais récupérée, la question porte sur la capacité de votre serveur et sur le volume d'URL que vous lui soumettez.
| Explorée, actuellement non indexée | Détectée, actuellement non indexée | |
|---|---|---|
| Ce que Google a fait | Exploré la page, puis écarté de l'index | Repéré l'URL, exploration reportée |
| Dernière exploration | Une date | Vide |
| Où chercher | Contenu, doublons, liens internesEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs., rendu | Temps de réponse, erreurs serveur, volume d'URL |
| Premier rapport à ouvrir | Inspection d'URL, page explorée | Statistiques sur l'exploration |

C'est sur « Détectée » que la vitesse du serveur et le budget de crawl entrent en jeu. Un serveur lent fait reculer Google.
Dans le guide de Google sur le budget d'exploration, Google décrit deux cas : si le site répond de façon régulière et que ses temps de réponse restent stables ou s'améliorent, la limite augmente ; s'il ralentit ou renvoie des erreurs 5xx, la limite diminue et Google explore moins.
Ce guide vise d'abord les gros sites (en ordre de grandeur, plus d'un million de pages uniques dont le contenu change environ une fois par semaine, ou plus de 10 000 pages dont le contenu change chaque jour) et ceux qui ont une grande partie de leurs URL en « Détectée ».
Pour suivre la santé de l'exploration, le rapport Statistiques sur l'exploration (Paramètres de la propriété) donne le temps de réponse moyen de votre serveur et l'état de l'hôte. Lisez la tendance plutôt qu'un chiffre isolé : un temps de réponse qui grimpe pendant que le nombre de demandes d'exploration baisse, voilà le signal.
Sur un site de quelques centaines de pages, le budget de crawlNombre de pages que Googlebot peut et veut crawler sur un site dans un temps donné. explique rarement un « Explorée » : Google a déjà fait le déplacement.
Les causes d'un « Explorée, actuellement non indexée »
Google a lu la page et ne l'a pas jugée utile à indexer : les causes tiennent donc à ce qu'il a lu, à la façon dont la page est reliée au reste du site, ou à ce qu'il a réellement pu voir.
Un contenu trop mince ou trop générique. Une fiche réduite à un titre et un prix, un article qui redit ce que cent pages disent déjà, une page locale dont seul le nom de ville change. Google a mieux ailleurs, parfois sur votre propre site.
Un quasi-doublon d'une page indexée. Quand deux URL disent la même chose, Google en garde une. Les doublons francs ont souvent leur propre motif dans le rapport (« Page en double sans URL canoniqueBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire. sélectionnée par l'utilisateur », « Page en double : Google a choisi une autre URL canonique que l'utilisateur »). Les pages très proches sans être identiques, comme des déclinaisons de couleur avec le même texte, peuvent finir en « Explorée ». Si les deux pages visent la même requête, le problème relève aussi de la cannibalisation SEO.
Une page sans recherche derrière. Archives de tags, pages de tri, combinaisons de filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO., résultats de recherche interne, paginationDivision du contenu en plusieurs pages numérotées. Nécessite une gestion SEO spécifique. profonde. Elles servent la navigation, aucune requête ne les appelle. Une recherche interne fréquente peut en revanche devenir une vraie page de listing : c'est le principe du searchdexing, à condition de filtrer les requêtes et d'ouvrir les pages par lot.
Une page mal reliée au site. Une URL connue seulement par le sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche., ou liée depuis une page elle-même peu explorée, envoie un signal faible. Le sitemap aide Google à découvrir les URL, sans garantir qu'elles seront explorées et indexées. Les liens internes depuis des pages indexées disent quelles pages comptent ; c'est tout l'enjeu du maillage interne.
Un contenu que Google ne voit pas. Google traite les sites en JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. en trois phases (exploration, rendu, indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats.), et la documentation sur le JavaScript prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.écise qu'une page peut rester quelques secondes dans la file de rendu, ou plus longtemps. Si le contenu principal ne se charge qu'après un clic (récupéré à la demande, et pas simplement replié dans un accordéon déjà présent dans la page), ou si le rendu échoue, Google évalue une coquille vide et la laisse hors de l'index. Même logique sur mobile : Google utilise la version mobile du contenu, explorée avec l'agent pour smartphone, pour l'indexation et le classementPosition d'une page web dans les résultats de recherche pour une requête donnée.. Un texte présent sur ordinateur mais absent de la version mobile n'existe pas pour lui.
Une page très récente. Juste après la publication, le statut peut n'être qu'une étape. Il devient un signal quand il dure et quand d'autres pages publiées en même temps sont, elles, indexées.

Diagnostiquer par famille d'URL plutôt que page par page
Sur un site de plus de quelques centaines de pages, le rapport se lit par famille : un gabarit qui produit des pages faibles en produit des centaines, et une correction de gabarit les règle toutes d'un coup.
1. Exporter et regrouper
Dans la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. : Indexation > Pages, ligne « Explorée, actuellement non indexée », puis export. La liste d'exemples est limitée à 1 000 entrées et ne montre pas forcément toutes les URL concernées : sur un gros site, complétez avec un crawl ou vos sitemaps. Regroupez ensuite par pattern d'URL. Sur un site e-commerce, le résultat ressemble à ça (exemple illustratif) :
Famille                         URL  Exemple
/blog/tag/*                     340  /blog/tag/promo-ete
/c/*?tri=*                      210  /c/baskets?tri=prix-croissant
/p/* (fiches sans description)  125  /p/basket-cuir-blanc-42
/magasins/* (pages magasins)     38  /magasins/lille-centre
/blog/* (articles)               12  /blog/choisir-sa-pointure
Cinq familles, donc cinq décisions. Les 340 tags et les 210 tris ne demandent peut-être aucun effort. Les fiches sans description, les pages magasins et les articles, si.
2. Inspecter deux ou trois URL par famille
Passez chaque URL témoin dans l'outil d'inspection d'URL. Regardez trois choses. La date de dernière exploration confirme que vous êtes bien sur « Explorée ». La canonique déclarée, et celle choisie par Google quand le champ est renseigné, signale un doublon si elle pointe ailleurs. Enfin, « Tester l'URL active » vous donne la capture d'écran et le HTML rendu.
Si le contenu principal manque dans le HTML rendu alors qu'il s'affiche dans votre navigateur, le problème vient du rendu JavaScript, et enrichir le texte n'y changera rien.
3. Comparer avec une URL sœur indexée
C'est l'étape qui tranche. Prenez une page du même gabarit qui, elle, est indexée, et comparez point par point : longueur et singularité du contenu principal, nombre de liens internes reçus, profondeur de clic, présence dans le sitemap, requêtes dans le rapport Performances. Le crawl Screaming Frog donne les liens entrantsLien provenant d'un site externe pointant vers votre site. Facteur de ranking majeur. et la profondeur de chaque URL. L'écart entre les deux pages vous désigne la cause, et souvent la correction.
4. Vérifier qu'une recherche existe
Avant d'investir sur une famille, vérifiez que des internautes cherchent ce qu'elle propose : requêtes dans la Search Console sur les pages sœurs indexées, volume dans votre outil de mots-clésTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO.. Une famille sans demande se traite par la sortie, quelle que soit la qualité de ses pages.

Décider : enrichir, fusionner ou sortir proprement
Chaque famille reçoit une action. Une seule. La règle : une page qui répond à une vraie recherche se rend indexable, une page qui n'y répond pas sort de l'index ou de l'exploration, proprement.
| Situation | Action | À éviter |
|---|---|---|
| Page utile, contenu mincePages avec peu de contenu ou de valeur ajoutée, pénalisées par Google. | Enrichir le contenu principal, ajouter des liens depuis des pages indexées, garder dans le sitemap | Ajouter du texte générique au gabarit |
| Quasi-doublon d'une page indexée | Fusionner et rediriger en 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle., ou poser une canonical vers la page à garder | Garder deux pages qui visent la même requête |
| Utile aux visiteurs, sans recherche (tags, tris) | Retirer du sitemap ; noindex (page laissée explorable) pour la sortir de l'index, ou Disallow pour couper l'exploration de toute la famille | Poser noindex et Disallow en même temps |
| Page sans utilité | 404 ou 410, liens internes et sitemap nettoyés | La rediriger vers l'accueil |
| Page récente | Ajouter des liens internes, attendre quelques semaines | Relancer la demande d'indexation chaque jour |
Pour les doublons, la redirection et la canonical sont des signaux forts selon la documentation de Google sur la canonicalisation, mais Google peut choisir une autre page canonique que la vôtre : le rapport d'indexation a même un motif pour ça. La redirection 301 reste l'option la plus nette quand l'ancienne URL n'a plus de raison d'exister ; le guide de la balise canonical détaille les cas où il faut garder les deux URL.
Pour les pages supprimées, le guide du budget d'exploration recommande un code 404 ou 410 et rappelle qu'un code 404 est un signal fort de ne plus explorer l'URL. Une page vide servie en 200 devient une soft 404, qui continue d'être explorée.
Les deux outils répondent à deux besoins distincts. Et l'inverse vaut aussi, d'après le guide du budget d'exploration : un noindex ne fait pas économiser de crawl, puisque Google demande la page avant de lire la balise.
Si vous voulez à la fois retirer de l'index des pages indexées et arrêter leur exploration, procédez dans l'ordre : noindex d'abord, puis Disallow une fois les pages sorties de l'index. Le détail des méthodes est dans notre guide pour désindexer une URL, et les règles de syntaxe dans celui sur la gestion du robots.txt.

Ce qui ne débloque rien
Trois réflexes reviennent face à ce statut, et aucun ne change le jugement de Google sur la page.
Demander l'indexation en boucle. Côté Google, la page d'aide sur la demande de nouvelle exploration pose trois limites : il existe un quota pour l'envoi d'URL individuelles, demander plusieurs fois l'exploration de la même URL ne l'accélère pas, et la demande ne garantit pas une inclusion dans les résultats. Une demande se justifie une fois, après une vraie modification de la page.
Gonfler le sitemap. Lister toutes les URL du site, tags et filtres compris, n'accélère rien : un sitemap aide à découvrir, il ne garantit ni l'exploration ni l'indexation. Un sitemap propre ne contient que les URL canoniques que vous voulez voir indexées.
Chercher l'outil Paramètres d'URL. Beaucoup de vieux tutoriels conseillent de régler les paramètres d'URL dans la Search Console. Google a retiré cet outil en avril 2022, en expliquant que seulement 1 % environ des configurations étaient utiles à l'exploration. Google apprend seul à traiter les paramètres ; pour garder la main, il reste le robots.txt, la canonical, ou l'absence de liens vers ces variations.

Dans l'ordre, donc : regrouper le rapport par famille, comparer chaque famille avec une page sœur indexée, puis donner une seule action à chaque famille. Commencez par celle qui contient des pages censées faire du trafic, et laissez de côté les tags et les tris tant qu'ils ne pèsent pas sur l'exploration. Sur un catalogue, ce tri touche d'abord les facettes et les fiches produits, le cœur d'un accompagnement SEO e-commerce.
Questions fréquentes
Combien de temps faut-il pour qu'une page explorée non indexée soit indexée ?
Google ne garantit aucun délai d'indexation. Sa documentation indique seulement qu'une nouvelle exploration peut prendre de quelques jours à quelques semaines ; l'indexation dépend ensuite de ce que Google trouve sur la page. Une page modifiée sans changement réel de contenu, de liens ou de rendu a toutes les chances de garder le même statut.
Faut-il demander l'indexation d'une page explorée non indexée ?
Une fois, après une modification réelle, sur les pages qui comptent. La page d'aide du rapport précise qu'il n'est pas nécessaire de renvoyer une URL explorée non indexée pour l'exploration, et les demandes répétées ne l'accélèrent pas. Pour beaucoup de pages, un sitemap à jour fait le même travail.
Une page explorée non indexée est-elle pénalisée ?
Non. Le statut ne correspond à aucune action manuellePénalité appliquée manuellement par un employé Google pour violation des guidelines. : Google a simplement jugé la page moins utile que d'autres à ce stade, et elle peut entrer dans l'index plus tard. Une pénalité manuelle se signale ailleurs, dans le rapport Actions manuelles de la Search Console.
Faut-il valider la correction d'une page explorée non indexée ?
Ce n'est pas obligatoire. Google met à jour le décompte du rapport chaque fois qu'il explore une page concernée, que vous ayez demandé une validation ou non. La validation sert surtout à suivre une correction appliquée à toute une famille d'URL. Pour les familles que vous avez choisi de laisser hors de l'index, elle n'a aucun intérêt.
Sources
- Rapport sur l'indexation des pages, Aide Google
- Gestion du budget d'exploration, Google Search Central
- Qu'est-ce qu'un sitemap ?, Google Search Central
- Comprendre les bases du SEO JavaScript, Google Search Central
- Indexation orientée mobile : bonnes pratiques, Google Search Central
- Outil d'inspection d'URL, Aide Google
- Spécifier une URL canonique avec rel="canonical" et d'autres méthodes, Google Search Central
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Demander à Google d'explorer de nouveau votre site Web, Google Search Central
- Nettoyage de printemps : outil Paramètres d'URL, Google Search Central
- Rapport "Statistiques sur l'exploration", Aide Google
- Rapport sur les actions manuelles, Aide Google
- Résoudre les problèmes JavaScript liés à la recherche, Google Search Central