
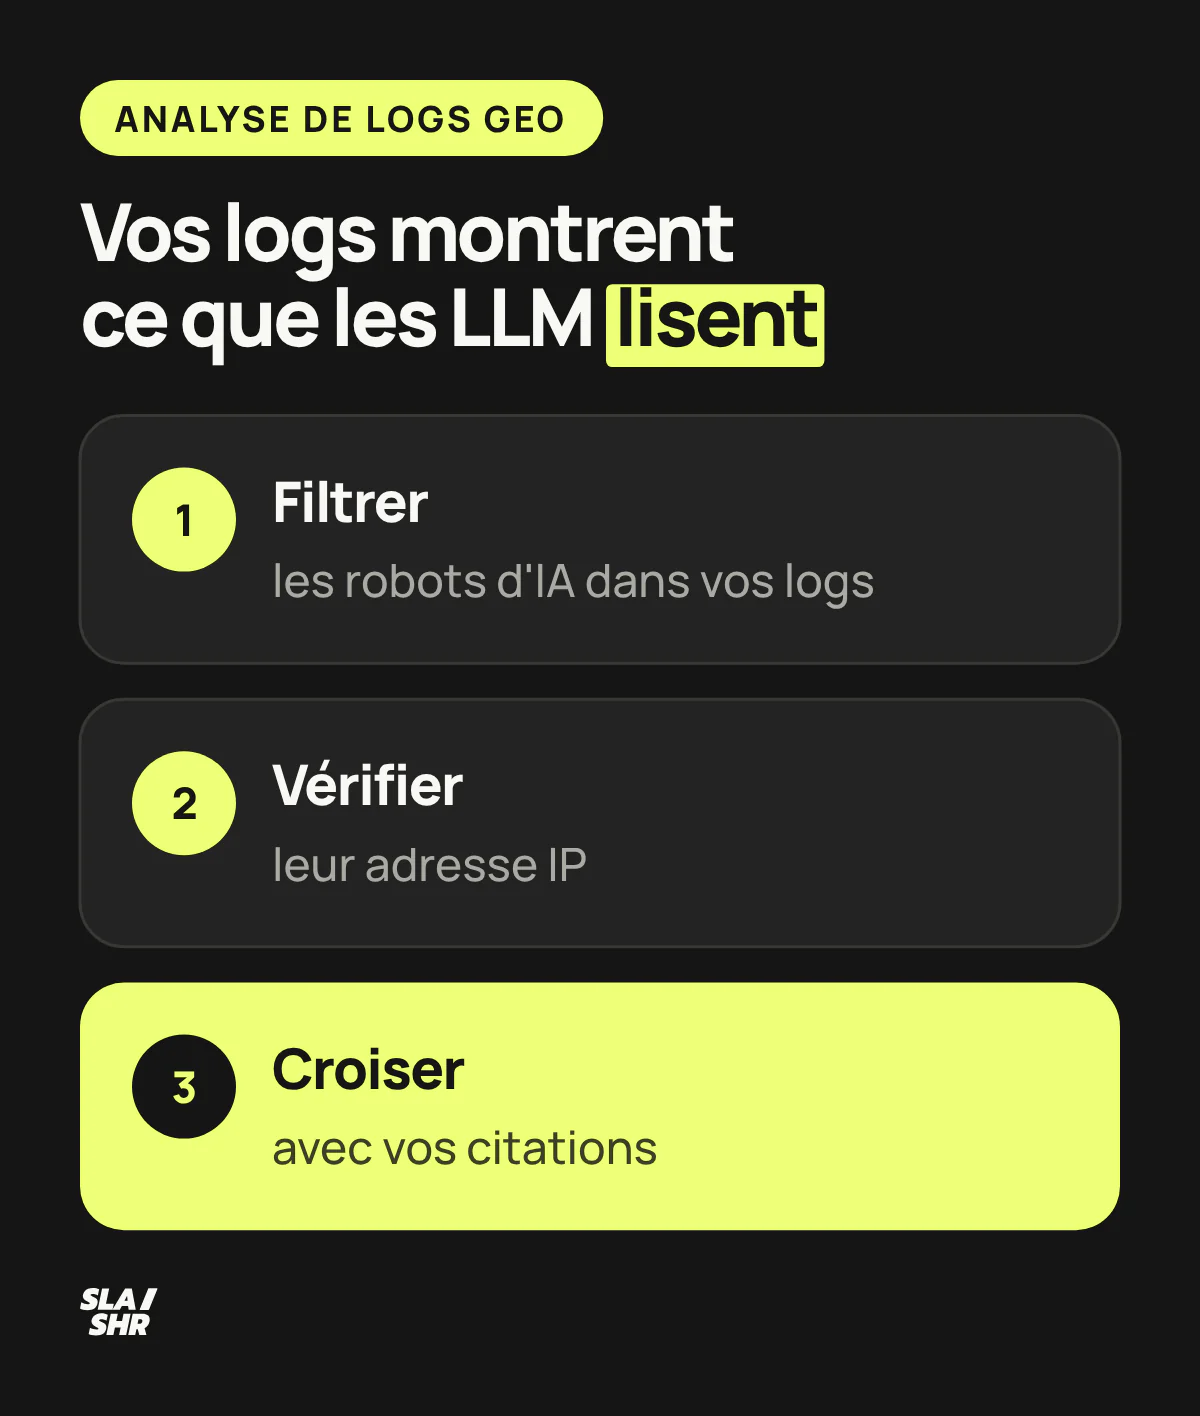
L'analyse de logs GEOGenerative Engine Optimization. Optimisation pour apparaître dans les réponses des IA génératives. filtre les journaux d'accès de votre serveur sur les robots d'IA (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot), vérifie qu'ils sont authentiques, puis croise leur passage avec vos citations. Pour ChatGPTAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses., Claude et PerplexityMoteur de recherche conversationnel basé sur l'IA, concurrent émergent de Google., c'est la seule trace de ce qu'ils lisent chez vous : aucun ne publie de rapport pour les sites.
Google et Bing donnent désormais des chiffres sur leurs réponses IA, sans dire quels robots d'IA sont passés sur quelles pages. Ce guide donne les commandes, testées sur des journaux réels au format combined, pour compter, vérifier et croiser.
Ce que les logs montrent et que les consoles ne montrent pas
Vos journaux d'accès sont la seule donnée de première main sur ce que les robots d'IA lisent chez vous : chaque requête y laisse l'URL demandée, le code de réponse et le user-agent du robot. Les consoles des moteurs, quand elles existent, mesurent surtout l'affichage dans les réponses. Vos logs voient tout ce qui arrive jusqu'au serveur.
Côté Google, depuis le 31 août 2026, la Search Console donne à tous les sites un rapport sur les performances dans l'IA générative : les impressions de vos pages dans les Aperçus IA et le Mode IA, par page, pays, appareil et date. Il compte combien de fois un lien vers votre site a été vu. Le fonctionnement et la mesure sont détaillés dans notre guide des Aperçus IA de Google.
Côté Microsoft, Bing Webmaster ToolsOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. a ouvert le 10 février 2026, en prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.éversion publique, un rapport AI Performance : le nombre de citations de vos pages dans Copilot, dans les résumés IA de Bing et chez certains partenaires, avec un échantillon des requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. qui ont servi à retrouver vos contenus.
OpenAI, Anthropic et Perplexity ne proposent rien d'équivalent. Rien non plus sur le crawl de leurs robots, quand la Search Console a son rapport Statistiques sur l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. pour GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages.. Pour savoir si ChatGPT, Claude ou Perplexity lisent vos pages, il vous reste vos logs.
Et même chez Google, une impression dans un Aperçu IA ne dit pas quand Googlebot est repassé sur la page ni ce qu'il a reçu : une erreur 5xx ou un 429 ne contient pas votre texte.

Les robots d'IA à suivre en 2026
Un robot d'IA se déclare dans le user-agent de chaque requête, et les grands opérateurs en font tourner plusieurs, un par usage. Leur documentation permet de les ranger en trois familles : l'entraînement des modèles, l'index de recherche de l'assistant et la récupération d'une page à la demande d'un utilisateur. Confondre deux familles fausse tout le reste de l'analyse.
La table à intégrer dans votre filtre :
| User-agent | Opérateur | Famille ou usage |
|---|---|---|
| GPTBot | OpenAI | Entraînement |
| OAI-SearchBot | OpenAI | Index de recherche de ChatGPT |
| ChatGPT-User | OpenAI | Récupération à la demande |
| ClaudeBot | Anthropic | Entraînement |
| Claude-SearchBot | Anthropic | Index de recherche de Claude |
| Claude-User | Anthropic | Récupération à la demande |
| PerplexityBot | Perplexity | Index de recherche, sans entraînement selon Perplexity |
| Perplexity-User | Perplexity | Récupération à la demande |
| Googlebot | Index de Google, sur lequel s'appuient les Aperçus IA et le Mode IA | |
| Bingbot | Microsoft | Robot principal de Bing |
| Applebot | Apple | Recherche (Spotlight, Siri, Safari), peut aussi entraîner les modèles d'Apple |
| Amazonbot | Amazon | Peut entraîner les modèles d'Amazon (Amzn-SearchBot et Amzn-User servent la recherche et les demandes) |
| meta-externalagent | Meta | Entraînement et indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. |
| Bytespider | ByteDance | Robot d'IA de ByteDance |
Entraînement, index, récupération : trois lectures
Un passage de GPTBot ou de ClaudeBot dit que votre contenu est collecté pour entraîner des modèles. Selon OpenAI, GPTBot explore du contenu qui peut servir à l'entraînement de ses modèles de fondation. Chez OpenAI, ce passage peut aussi servir la recherche : quand un site autorise GPTBot et OAI-SearchBot, OpenAI peut n'utiliser qu'une seule exploration pour les deux usages.
Un passage d'OAI-SearchBot, de Claude-SearchBot ou de PerplexityBot dit que la page entre dans l'index de recherche de l'assistant. C'est la famille à surveiller de près : selon OpenAI, un site qui bloque OAI-SearchBot n'apparaît plus dans les réponses de recherche de ChatGPT, hors liens de navigation.
Un passage de ChatGPT-User, de Claude-User ou de Perplexity-User dit qu'une personne a posé une question qui a mené à votre page. OpenAI précise que les règles du robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. peuvent ne pas s'appliquer à ChatGPT-User, et Perplexity que Perplexity-User les ignore en général. Anthropic indique au contraire que désactiver Claude-User empêche de récupérer votre contenu en réponse à une question. Notre guide du référencement sur Perplexity détaille les réglages, robots.txt et WAF compris.

Avant de conclure qu'un robot ne vient pas, regardez votre CDNContent Delivery Network. Réseau de serveurs distribuant le contenu depuis le serveur le plus proche de l'utilisateur.. Cloudflare a déprécié le 15 septembre 2026 son interrupteur « Block AI bots » au profit de trois catégories, Search, Agent et Training, et régler Training sur Block arrête aussi Googlebot, Bingbot et Applebot. Une requête bloquée au CDN n'atteint jamais vos logs d'origine. Notre grille d'audit technique GEO dit quoi corriger ensuite, du réglage du CDN au contenu absent du HTML initial.
Google-Extended et Applebot-Extended manquent volontairement à la table. Ce sont des jetons du robots.txt : Google-Extended décide si le contenu exploré par Google peut entraîner les futurs modèles GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche. et ancrer les réponses des applications Gemini, Applebot-Extended si les données d'Applebot peuvent entraîner ceux d'Apple. Ils ne crawlent rien, et vous ne les verrez jamais dans un fichier d'accès.
Compter les passages par robot en une commande
Pour un premier comptage, une ligne suffit sur un journal au format combined, celui que nginx utilise quand aucun format n'est précisé :
awk -F'"' '{print $6}' access.log \
  | grep -oE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Amazonbot|Applebot|Bytespider|[Mm]eta-[Ee]xternal[Aa]gent" \
  | tr 'A-Z' 'a-z' | sort | uniq -c | sort -rn
Vous obtenez le nombre de requêtes par robot, trié. La commande awk isole le user-agent, sixième champ quand on découpe la ligne sur les guillemets : un nom de robot présent dans une URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. ou un referer ne compte pas. La recherche reste sensible à la casse, parce que plusieurs robots répètent leur nom en minuscules dans leur user-agent (GPTBot/1.4; +httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://openai.com/gptbot) et seraient comptés deux fois avec grep -i. Pour inclure les fichiers archivés, remplacez awk -F'"' '{print $6}' access.log par zcat -f access.log* | awk -F'"' '{print $6}' en gardant la suite. Ce premier comptage inclut les imposteurs : la section suivante apprend à les repérer, et le chargement dans DuckDB les retire.
La répartition entre robots bouge vite. Sur le réseau de Cloudflare, Bytespider est passé de 42 % à environ 7 % du trafic des robots d'IA entre mai 2024 et mai 2025, pendant que GPTBot montait de 5 % à 30 %. Une répartition relevée il y a un an ne dit rien de la vôtre aujourd'hui. Le même journal dit aussi si quelqu'un demande votre fichier llms.txt : filtrez les requêtes sur ce chemin avant de compter par robot. Les études publiées en 2026 montrent qu'il est très peu demandé, comme le détaille notre article sur le fichier llms.txt et ce que mesurent les journaux.
Vérifier qu'un robot est bien celui qu'il prétend être
N'importe quel script peut se présenter comme GPTBot. Le user-agent est une ligne de texte que le client choisit. Avant d'analyser, vérifiez l'adresse IP, avec l'une des deux méthodes que publient les opérateurs.
Le DNS inverse pour Googlebot et Applebot
Google décrit la méthode en trois temps : une résolution DNS inverse de l'adresse IP relevée dans vos logs, un contrôle du domaine obtenu (googlebot.com, google.com ou googleusercontent.com), puis une résolution directe de ce nom, qui doit redonner la même adresse.
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com
Pour Googlebot, Google précise que le nom suit le masque crawl-***-***-***-***.googlebot.com ou geo-crawl-***-***-***-***.geo.googlebot.com. La première commande doit donc renvoyer un nom en googlebot.com, la seconde l'adresse de départ. Un nom en googleusercontent.com ne suffit pas à valider un user-agent Googlebot : la liste common-crawlers.json de Google sert de référence. Apple identifie Applebot de la même façon, par un nom en applebot.apple.com.

Les plages d'IP publiées pour OpenAI, Anthropic et Perplexity
OpenAI publie un fichier JSON par robot, Anthropic un fichier commun à ses robots, Perplexity un par robot. Les trois suivent le même format, une liste de préfixes (le format prévoit l'IPv6, les fichiers ne publiaient que de l'IPv4 en octobre 2026), ce qui permet un seul script. Ici pour GPTBot, avec les imposteurs ajoutés au fichier faux.txt :
zcat -f access.log* | awk -F'"' '$6 ~ /GPTBot/ {split($1, f, " "); print f[1]}' | sort -u > ips.txt
curl -sL https://openai.com/gptbot.json | python3 -c '
import sys, json, ipaddress
nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in json.load(sys.stdin)["prefixes"]]
for ip in open("ips.txt").read().split():
    print(ip, "ok" if any(ipaddress.ip_address(ip) in n for n in nets) else "hors-plages")
' | tee verif.txt
awk '$2 == "hors-plages" {print $1}' verif.txt >> faux.txt
Pour les autres robots, changez le nom dans la première ligne et l'adresse du fichier : https://openai.com/searchbot.json, https://openai.com/chatgpt-user.json, https://claude.com/crawling/bots.json, https://www.perplexity.com/perplexitybot.json ou https://www.perplexity.com/perplexity-user.json. L'option -L de curl suit la redirection des fichiers de Perplexity. Le même script vérifie Googlebot avec la liste de Google (https://developers.google.com/static/crawling/ipranges/common-crawlers.json) et Bingbot avec celle de Microsoft (https://www.bing.com/toolbox/bingbot.json, nom bingbot en minuscules). Amazon publie aussi ses listes, une page par robot.
Une adresse hors plages qui se présente comme GPTBot est un imposteur : faux.txt sert à sortir ses lignes de l'analyse (étape suivante, dans DuckDB), et vous pouvez la bloquer au pare-feu si elle insiste. Les faux Googlebot et Bingbot sont courants aussi : passez-les au même script avant de compter. Bing propose aussi un outil de vérification de Bingbot.
Récupérer et préparer vos logs
Le format et l'endroit dépendent de votre infrastructure. Une collecte incomplète biaise chaque chiffre qui suit.
Les sources selon votre stack
Sur une installation Debian ou Ubuntu standard, nginx écrit dans /var/log/nginx/access.log et Apache dans /var/log/apache2/access.log. Les anciens fichiers sont archivés par la rotation (access.log.1, puis access.log.2.gz et suivants).
Derrière un CDN, les requêtes servies depuis le cache ou bloquées par le pare-feu n'atteignent jamais l'origine. Vos logs serveurFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots. sous-estiment alors le passage des robots.
C'est le journal du CDN qu'il faut lire : Logpush chez Cloudflare, qui pousse les journaux de requêtes vers votre stockage, les journaux standard de CloudFront, déposés dans un bucket S3, ou ceux du load balancer dans Cloud Logging chez Google Cloud, où la journalisation s'active service de backend par service de backend (case Enable logging). Une fois activée, son taux d'échantillonnage vaut 1.0 par défaut, soit toutes les requêtes : vérifiez qu'elle est active et que le taux n'a pas été baissé. Le piège classique : conclure que « les robots ne viennent pas » à partir des seuls logs d'origine. Un journal de CDN a son propre format : les commandes de ce guide, écrites pour le format combined, demandent alors d'adapter l'extraction des champs.

Rétention et RGPD
Gardez assez d'historique pour comparer un mois à l'autre : trois mois sont un bon départ pour voir les robots revenir sur vos pages clés.
Les logs contiennent des adresses IP. La Cour de justice de l'Union européenne a jugé le 19 octobre 2016 (arrêt Breyer) qu'une adresse IP dynamique est une donnée personnelle pour le site qui dispose de moyens légaux de faire identifier la personne. Pour l'analyse des robots, l'IP des visiteurs humains ne sert à rien : tronquez-la à l'ingestion. Gardez en clair celle des lignes de robots, dont la vérification a besoin, et documentez votre durée de conservation.
Les outils de log qui valent vraiment le coup
Le bon outil dépend du volume et de l'usage. Pour un premier audit, grep et DuckDB suffisent.
Screaming FrogLogiciel de crawl permettant d'auditer techniquement un site web. Log File Analyser donne une interface : il analyse le crawl des moteurs et des robots d'IA, et vérifie automatiquement les robots des moteurs comme Googlebot. La version gratuite s'arrête à 1 000 lignes de log ; la licence coûte 99 £ par an.
Notre tutoriel Screaming Frog couvre l'outil de crawl de la même maison, utile pour croiser logs et structure du site. Oncrawl, plateforme sur abonnement, suit dans les logs Googlebot, Bingbot et les robots d'IA d'OpenAI, de Perplexity, de Claude, de Gemini ou de Mistral.
Sans licence, chargez vos logs dans DuckDB. C'est une base SQL qui tourne dans votre terminal, sans serveur à installer, et qui lit les fichiers directement, compressés ou non. La requête suivante crée une table logs avec une ligne par passage des robots d'OpenAI, d'Anthropic et de Perplexity, de Googlebot et de Bingbot, fichiers statiques, robots.txt et sitemaps exclus, puis retire les imposteurs de faux.txt. Ajoutez à la liste les autres robots que vous suivez (Amazonbot, Applebot, meta-externalagent) :
CREATE TABLE logs AS
SELECT ip, ts, url, status,
       regexp_extract(ua, 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Googlebot|bingbot', 0) AS bot
FROM (
  SELECT
    regexp_extract(line, '^(\S+)', 1) AS ip,
    strptime(regexp_extract(line, '\[([^\]]+)\]', 1), '%d/%b/%Y:%H:%M:%S %z') AS ts,
    regexp_extract(line, '"[A-Z]+ ([^ ?"]+)', 1) AS url,
    CAST(regexp_extract(line, '" (\d{3}) ', 1) AS INTEGER) AS status,
    regexp_extract(line, '"([^"]*)"$', 1) AS ua
  FROM read_csv('access.log*', columns = {'line': 'VARCHAR'},
                delim = '\t', quote = '', escape = '', header = false)
)
WHERE bot <> ''
  AND NOT regexp_matches(url, '\.(jsLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche.|css|png|jpe?g|gif|webp|avif|svg|ico|woff2?|xml)$')
  AND url <> '/robots.txt';

DELETE FROM logs
WHERE ip IN (SELECT ip FROM read_csv('faux.txt', columns = {'ip': 'VARCHAR'}, header = false));
Lancez-la avec duckdb logs.duckdb depuis le dossier des logs, faux.txt à côté : elle lit tous les fichiers access.log*, archives .gz comprises, et coupe les paramètres d'URL. Sans ce nettoyage, un scanner déguisé en ClaudeBot gonfle les passages et les refus, et ses tentatives sur /.env comptent parmi les URL visitées. Pour un suivi partagé ou de très gros volumes, la même logique se porte dans ClickHouse ou BigQuery.

Les KPI GEO que vous sortez de vos logs
Trois requêtes suffisent. Elles disent qui revient et avec quel accueil, ce que le passage des robots donne en citations, et quelles pages clés aucun robot d'OpenAI n'a reçues. Elles tournent sur la table logs créée plus haut.
La fréquence de passage et les refus par robot
SELECT bot,
       count(*) AS hits,
       count(DISTINCT url) AS urls,
       round(count(*) / count(DISTINCT url), 1) AS hits_par_url,
       count(*) FILTER (WHERE status IN (403, 429)) AS refus
FROM logs
GROUP BY bot
ORDER BY hits DESC;
hits_par_url distingue un robot qui explore large (proche de 1) d'un robot qui revient sur les mêmes pages. Les notions de découverte, de fréquence et de profondeur viennent du SEO classique, posées dans notre article sur le crawling des moteurs de recherche. La colonne refus, la première à regarder, compte les 403 et les 429 : un robot d'index de recherche qui en reçoit est arrêté par votre serveur ou votre pare-feu applicatif, et ne lit pas ces pages.
Un blocage au CDN, lui, ne se voit que dans le journal du CDN.
Le crawl face aux citations
Exportez de votre outil de suivi un fichier citations.csv à deux colonnes : url, le chemin écrit comme dans les logs, et citations, le nombre de réponses de ChatGPT qui citent la page sur la période. La requête met face à face le passage des robots d'OpenAI et les citations, pages citées sans visite comprises. GPTBot y figure, puisque OpenAI peut ne faire qu'une exploration pour la recherche et l'entraînement quand votre robots.txt autorise les deux robots :
CREATE TABLE citations AS SELECT * FROM read_csv('citations.csv');

WITH crawl AS (
  SELECT url, count(*) AS hits
  FROM logs
  WHERE bot IN ('OAI-SearchBot', 'ChatGPT-User', 'GPTBot')
    AND status IN (200, 304)
  GROUP BY url
)
SELECT coalesce(crawl.url, c.url) AS url,
       coalesce(crawl.hits, 0) AS hits,
       coalesce(c.citations, 0) AS citations
FROM crawl
FULL JOIN citations c ON c.url = crawl.url
ORDER BY citations DESC, hits DESC;
Seules les réponses 200 et 304 comptent comme lecture : un 200 livre votre texte, un 304 confirme que le robot a déjà la version à jour, alors qu'un 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle., un 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. ou un 403 ne livre rien. Le tableau sort en entier, trié par citations : une page citée sans visite reste visible même sur un gros site. Écrivez les URL sous la même forme des deux côtés : /page et /page/ ne se rejoignent pas. Les quatre cas qui sortent du tableau se lisent plus bas, dans « Croiser logs et citations, le maillon manquant ».
Les pages clés qu'aucun robot d'OpenAI n'a reçues
La dernière métrique est une absence. Chargez votre sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. et cherchez les URL qu'aucun des trois robots d'OpenAI n'a reçues (réponse 200 ou 304) :
CREATE TABLE sitemap AS
SELECT coalesce(nullif(u, ''), '/') AS url
FROM (SELECT unnest(regexp_extract_all(content, '<loc>https?://[^/<]+(/[^<]*)?</loc>', 1)) AS u
      FROM read_text('sitemap.xml'));

SELECT s.url
FROM sitemap s
LEFT JOIN logs l ON l.url = s.url AND l.bot IN ('OAI-SearchBot', 'GPTBot', 'ChatGPT-User')
                AND l.status IN (200, 304)
WHERE l.url IS NULL;
Une page qui ressort ici n'a reçu aucune visite réussie (200 ou 304) de ces trois robots sur la période. Le piège /page contre /page/ vaut aussi entre sitemap et logs. Regardez d'abord ce que ces robots ont reçu sur cette URL : SELECT bot, status, count(*) AS hits FROM logs WHERE url = '/la-page' AND bot IN ('OAI-SearchBot', 'GPTBot', 'ChatGPT-User') GROUP BY ALL;. Un 301, 302Redirection temporaire ne transférant pas le jus SEO. À utiliser avec précaution., 307 ou 308 signale une URL redirigée à corriger dans le sitemap, un 404 ou un 410 une URL morte, un 401, 403, 429 ou 5xx un blocage ou une panne du serveur.
Sans aucune ligne, vérifiez dans l'ordre le robots.txt et le CDN, puis le maillage interneEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. qui doit l'exposer, puis sa date de mise en ligne.
Pour tester l'index de recherche seul, retirez ChatGPT-User et gardez OAI-SearchBot et GPTBot : selon OpenAI, ChatGPT-User ne sert pas à décider si une page peut apparaître dans la recherche. Changez les robots dans la requête pour faire le même contrôle sur Claude-SearchBot ou PerplexityBot. Un sitemap découpé en index se charge fichier par fichier, et une liste de vos URL à fort enjeu peut remplacer le sitemap. Si vos fichiers sont déjà découpés par famille de pages pour mesurer l'indexation, lancez la requête segment par segment : vous voyez quelle famille les robots d'OpenAI laissent de côté.

Croiser logs et citations, le maillon manquant
Les logs disent qui vous lit. Les citations disent qui vous reprend. Il faut les deux pour décider.
Pour ChatGPT, Perplexity et Gemini, les citations se relèvent avec un panel de prompts rejoué à intervalle fixe : c'est ce que fait Janus, notre outil de suivi. Le diagnostic vaut ce que vaut la liste suivie : la méthode pour choisir les prompts à monitorer part de vos données et couvre tout le funnelParcours utilisateur de la découverte à la conversion, chaque étape nécessitant un contenu adapté.. Pour Google et Bing, les consoles donnent l'autre moitié : les impressionsNombre de fois qu'une page apparaît dans les résultats de recherche, qu'elle soit cliquée ou non. par page du rapport IA générative et les citations par page d'AI Performance, à croiser avec le passage de Googlebot et de Bingbot.
Le tableau de la deuxième requête se lit alors en quatre cas.
Lue et citée. Une source vivante. Protégez-la : pas de refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. ni de redirection sans vérifier que les robots la retrouvent.
Lue, jamais citée. La page est explorée puis écartée. Le chantier est éditorial : retravaillez le passage qui doit répondre, pour qu'il tienne seul et donne la réponse dès sa première phrase.
Citée sans visite. Vos logs ne montrent aucune visite réussie des robots d'OpenAI sur la page. OpenAI indique que la recherche de ChatGPT utilise aussi des fournisseurs de recherche tiers, auxquels elle envoie des requêtes réécrites. Vérifiez que la page est ouverte à OAI-SearchBot : si l'information citée a changé, c'est le moyen le plus direct de faire lire la nouvelle version.
Ni lue ni citée. Un angle mort. Reprenez la liste de la troisième requête et ses vérifications : code reçu, robots.txt et CDN, maillage, date de mise en ligne.

Ce que vous faites de ces données
Un audit GEO qui ne débouche sur aucune décision reste un rapport pour étagère. Les logs en rendent trois possibles.
Le robots.txt et le CDN, famille par famille. Un Disallow pour GPTBot et ClaudeBot refuse l'entraînement et laisse passer OAI-SearchBot, Claude-SearchBot et PerplexityBot, donc la recherche. Le choix dépend de votre modèle économique : un éditeur qui négocie des licences de contenu bloque l'entraînement, un e-commerce qui cherche la présence ouvre tout. Au CDN, chez Cloudflare, refusez l'entraînement avec Disallow AI Training : Block sur la catégorie Training arrête aussi Googlebot, Bingbot et Applebot. Pour Google, Disallow AI Training passe par Google-Extended, et coupe donc aussi l'ancrage des réponses de Gemini. Bing ne lit pas encore ce refus dans le robots.txt : Microsoft vise début 2027, selon Cloudflare. La syntaxe des blocs User-agent est détaillée dans notre guide du robots.txt en SEO.
Le maillage. Une page à fort enjeu peu visitée se renforce par des liens internes depuis les pages que les robots visitent le plus, que vous donne SELECT url, count(*) AS hits FROM logs WHERE status IN (200, 304) GROUP BY url ORDER BY hits DESC LIMIT 20; (écartez à la lecture les URL techniques, API ou images). Le mécanisme côté Google est détaillé dans notre article sur le budget de crawl.
Les robots gloutons. Un robot qui charge votre serveur sans rien rapporter en citations se limite au pare-feu (limitation de débit) ou se refuse dans le robots.txt. Deux limites à connaître : les robots de récupération à la demande peuvent ignorer le robots.txt (Claude-User le respecte, selon Anthropic), et Amazon indique que ses robots ne lisent pas la directive crawl-delay. Pour une vraie barrière, passez par le pare-feu ou le CDN.

Brancher logs et citations dans la durée fait partie d'un accompagnement d'agence GEO. Pour commencer, lancez la commande de comptage et la vérification des adresses IP sur un mois de logs : vous saurez qui vous lit vraiment avant de toucher au robots.txt.
Questions fréquentes
Comment voir dans les logs si ChatGPT explore mon site ?
Cherchez dans vos logs trois user-agents : OAI-SearchBot (index de recherche de ChatGPT), ChatGPT-User (pages demandées par un utilisateur) et GPTBot (entraînement). Vérifiez ensuite que les adresses IP appartiennent aux plages publiées par OpenAI dans ses fichiers JSON. Si aucun de ces robots n'apparaît sur un mois, regardez d'abord le robots.txt et le réglage de votre CDN.
Les robots d'IA respectent-ils le robots.txt ?
Les opérateurs documentent un réglage par robots.txt pour leurs robots d'entraînement et d'index. Pour la récupération à la demande, ils préviennent eux-mêmes : OpenAI écrit que les règles peuvent ne pas s'appliquer à ChatGPT-User, Perplexity que Perplexity-User les ignore en général, Meta que Meta-ExternalFetcher peut les contourner. Anthropic fait exception : désactiver Claude-User empêche la récupération. Cloudflare a aussi accusé Perplexity, le 4 août 2025, d'utiliser des robots non déclarés pour passer outre les interdictions, ce que Perplexity conteste. Pour bloquer vraiment, agissez au pare-feu ou au CDN.
Comment lire une ligne de log serveur ?
Une ligne au format combined contient l'adresse IP, l'horodatage, la requête (méthode et URL), le code de réponse HTTP, la taille de la réponse, le referer et le user-agent. Pour le GEO, trois champs comptent : l'URL dit quelle page a été lue, le user-agent par quel robot, le code de réponse ce que le robot a reçu. L'adresse IP sert à vérifier que le robot est authentique.
La Search Console montre-t-elle la visibilité dans les IA ?
Pour Google, oui. Depuis le 31 août 2026, le rapport sur les performances dans l'IA générative donne à tous les sites les impressions de leurs pages dans les Aperçus IA et le Mode IA, par page, pays, appareil et date. Pour Copilot et les résumés IA de Bing, c'est le rapport AI Performance de Bing Webmaster Tools. ChatGPT, Claude et Perplexity n'offrent pas de rapport : vos logs et un suivi de prompts restent votre mesure.
Sources
- gptbot.json, OpenAI, openai.com
- bingbot.json, Microsoft Bing
- Rapport sur les performances dans l'IA générative, Aide Search Console, Aide Google
- Introducing AI Performance in Bing Webmaster Tools Public Preview, Bing Webmaster Blog
- Rapport Statistiques sur l'exploration, Aide Search Console, Aide Google
- Overview of OpenAI Crawlers, developers.openai.com
- Perplexity Crawlers, docs.perplexity.ai
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, support.claude.com
- Les fonctionnalités d'IA et votre site Web, Google Search Central
- About Applebot, support.apple.com
- Amazonbot, Amazon Developer : developer.amazon.com/amazonbot
- Meta Web Crawlers : developers.facebook.com/docs/sharing/webmasters/web-crawlers/
- Have it both ways: stay discoverable in search while disallowing AI training, Cloudflare : blog.cloudflare.com/accountable-mixed-use-ai-crawlers/
- Robots d'exploration courants de Google, Google Search Central
- Module ngx_http_log_module, nginx : nginx.org/en/docs/http/ngx_http_log_module.html
- From Googlebot to GPTBot: who's crawling your site in 2025, Cloudflare (1er juillet 2025) : blog.cloudflare.com/from-googlebot-to-gptbot-whos-crawling-your-site-in-2025/
- Vérifier les requêtes de Googlebot et des autres robots d'exploration Google, Google Search Central
- Cloudflare Logs, Cloudflare Docs : developers.cloudflare.com/logs/
- Access logs (standard logs), Amazon CloudFront Developer Guide : docs.aws.amazon.com/AmazonCloudFront/latest/DeveloperGuide/AccessLogs.html
- Arrêt de la Cour (deuxième chambre) du 19 octobre 2016, Breyer, C-582/14, EUR-Lex, eur-lex.europa.eu
- Log File Analyser, Screaming Frog, screamingfrog.co.uk
- Why DuckDB : duckdb.org/why_duckdb
- CSV Import, DuckDB documentation : duckdb.org/docs/current/data/csv/overview.html
- Introducing ChatGPT search, OpenAI (31 octobre 2024), openai.com
- Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives, Cloudflare (4 août 2025) : blog.cloudflare.com/perplexity-is-using-stealth-undeclared-crawlers-to-evade-website-no-crawl-directives/
- Agents or Bots? Making Sense of AI on the Open Web, Perplexity, perplexity.ai
- Which crawlers does Bing use?, Bing Webmaster Tools
- Global external Application Load Balancer logging and monitoring, Google Cloud, docs.cloud.google.com
- SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. log file analyzer for search and AI bots, Oncrawl : oncrawl.com/platform/log-analyzer/
- ChatGPT search, OpenAI Help Center, help.openai.com
- Block AI bots, Cloudflare Docs : developers.cloudflare.com/bots/additional-configurations/block-ai-bots/