
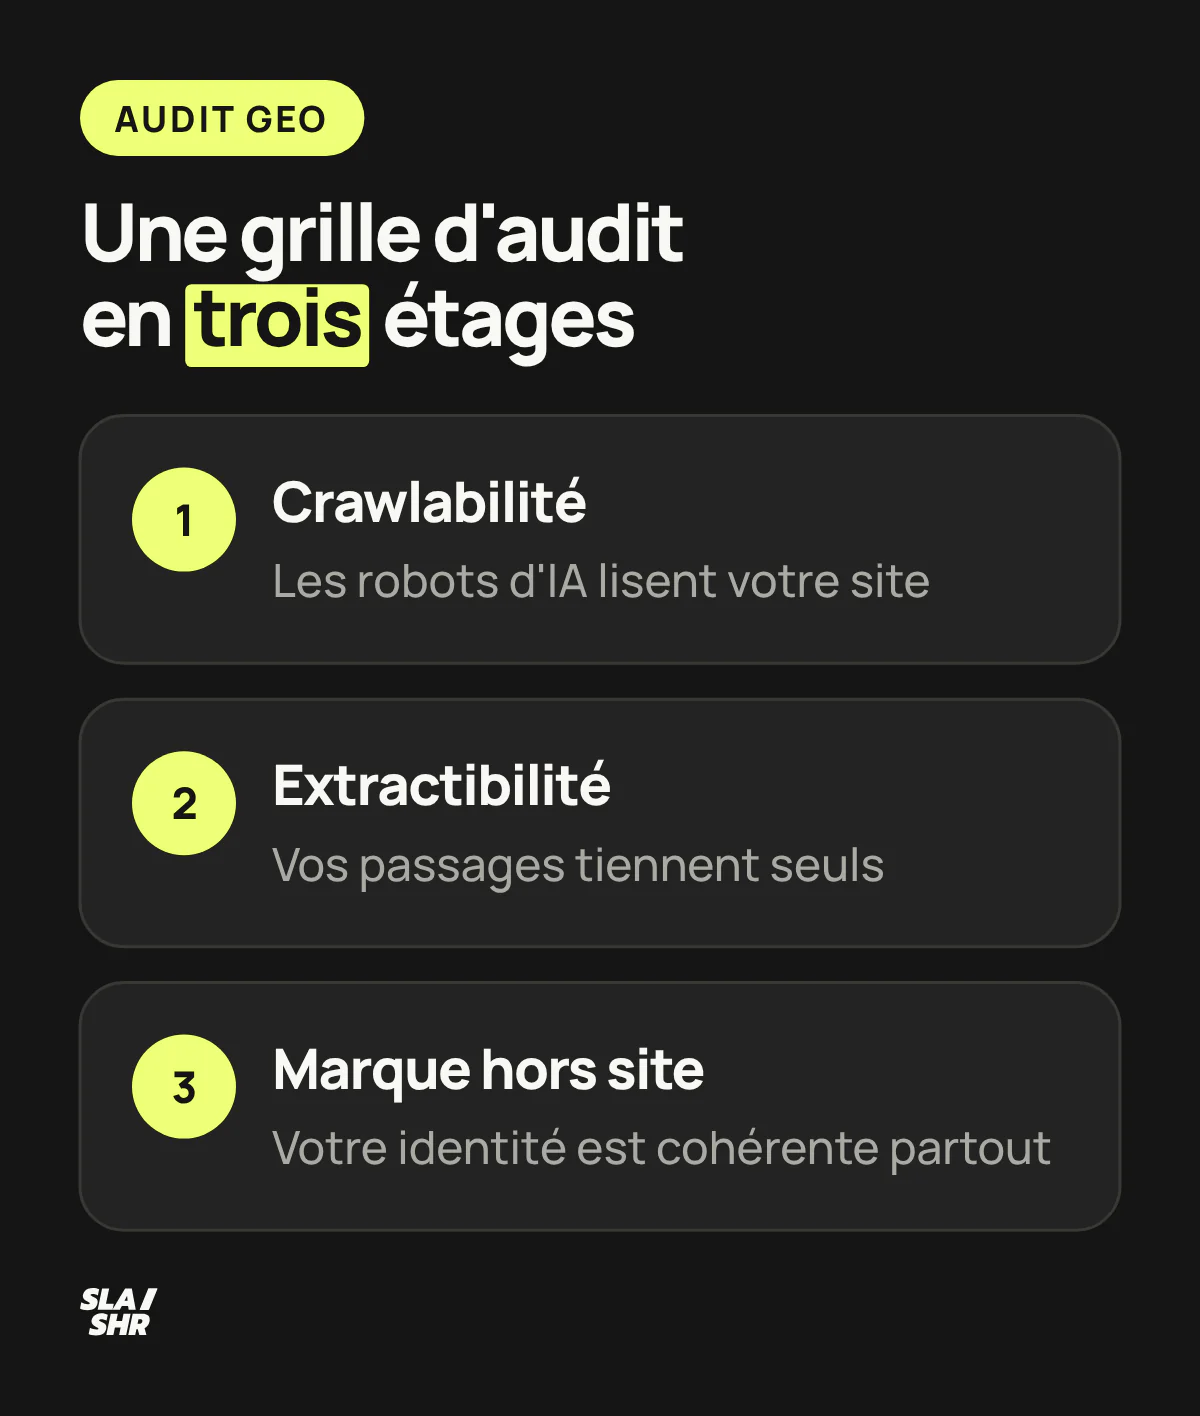
Un audit technique GEOGenerative Engine Optimization. Optimisation pour apparaître dans les réponses des IA génératives. vérifie trois choses qu'un audit SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche.Analyse complète d'un site identifiant les problèmes techniques, contenus et netlinking. ne couvre pas : quels robots d'IA ont le droit de lire votre site, si vos passages se citent tels quels, et si votre marque est décrite de la même façon hors de votre domaine. Le socle SEO (indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats., performance, structure) reste commun aux deux.
Chaque point de la grille porte deux notes, l'impact sur votre citabilité et la difficulté de correction, et l'ensemble se range en plan d'action à 30, 60 et 90 jours. Le diagnostic technique se fait avec des outils gratuits ; seule la mesure des citations demande un outil de suivi.
Ce qu'un audit GEO ajoute à l'audit SEO
Un audit technique SEO vérifie que Googlebot peut explorer, rendre et indexer vos pages. Un audit technique GEO part du même socle et ajoute une question : un modèle de langage peut-il lire votre contenu, en extraire un passage et le citer, et a-t-il assez d'éléments sur votre marque pour lui faire confiance ?
Les signaux changent. Vous pouvez être indexé, rapide et propre côté SEO, et rester absent des réponses de ChatGPT ou de Perplexity parce que votre robots.txt bloque les bons robots, que votre contenu n'existe qu'après exécution du JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche., ou que votre marque n'est décrite nulle part en dehors de votre domaine.

L'audit GEO regarde donc ces trois choses en plus, les robots d'IA autorisés et vus dans vos logs, des passages qui tiennent seuls et une identité de marque cohérente hors site, et y ajoute une mesure : la liste des pages déjà citées face à celles qui devraient l'être.
Pour les Aperçus IA de Google, la documentation est claire : aucune exigence supplémentaire ni optimisation spéciale n'est requise. Les bonnes pratiques SEO suffisent. La couche GEO compte surtout pour les autres assistants, qui ont leurs propres robots.
Vérifier qui vous crawle côté robots d'IA
C'est le point à plus fort impact de la grille. Et le plus rapide à corriger. Un robot qui n'a pas accès à vos pages ne peut ni les indexer ni les citer : avant toute optimisation, lisez votre robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., le réglage de votre CDNContent Delivery Network. Réseau de serveurs distribuant le contenu depuis le serveur le plus proche de l'utilisateur. et vos logs serveurFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots..
Trois familles de robots, trois décisions
Les robots d'IA ne font pas tous le même métier. Leur documentation permet de les ranger en trois familles, et chaque famille appelle une décision différente.
Les robots d'entraînement collectent du contenu pour entraîner les modèles. Selon OpenAI, GPTBot sert à explorer du contenu qui peut servir à l'entraînement de ses modèles de fondation ; ClaudeBot joue le même rôle chez Anthropic. Deux jetons s'y ajoutent, qui ne crawlent rien eux-mêmes.
Google-Extended décide si le contenu exploré par Google peut entraîner les futurs modèles GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche. et ancrer les réponses des applications Gemini et de Vertex AI ; il n'a aucune incidence sur l'inclusion dans la recherche Google. Applebot-Extended ne crawle pas les pages : Apple s'en sert seulement pour décider de l'usage des données d'Applebot dans l'entraînement de ses modèles.
Les robots d'index de recherche alimentent le moteur de l'assistant. OAI-SearchBot fait apparaître les sites dans la recherche de ChatGPTAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses., et un site qui le bloque n'est plus montré dans ses réponses de recherche. Claude-SearchBot indexe les contenus pour la recherche de Claude. PerplexityBot sert à faire apparaître et lier des sites dans les résultats de PerplexityMoteur de recherche conversationnel basé sur l'IA, concurrent émergent de Google., sans collecte pour entraîner des modèles de fondation.
Les robots de récupération à la demande vont chercher une page quand un utilisateur pose une question : ChatGPT-User, Claude-User et Perplexity-User. OpenAI prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.écise que les règles du robots.txt peuvent ne pas s'appliquer à ChatGPT-User, et Perplexity que Perplexity-User les ignore en général. Anthropic indique au contraire que désactiver Claude-User empêche de récupérer votre contenu en réponse à une question.

Lire votre robots.txt comme un robot d'IA
La vérification tient en une ligne :
curl -s httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://votre-site.fr/robots.txt
Repérez les blocs User-agent et vérifiez, pour chacun des robots ci-dessus, s'il tombe sur un Disallow: /. Un éditeur qui veut sortir de l'entraînement et de l'ancrage de Gemini sans toucher à sa présence dans la recherche Google écrit simplement :
User-agent: Google-Extended
Disallow: /
Le piège classique est un User-agent: * permissif, doublé d'un plugin de sécurité ou d'une règle de pare-feu qui bloque les user-agents inconnus avant même le robots.txt. Testez alors la réponse réelle :
curl -s -o /dev/null -w "%{http_code}" -A "OAI-SearchBot" https://votre-site.fr/page-importante
Un 200, l'accès est ouvert. Un 403, un 429 ou un challenge de CDN, et ce robot ne vous lit pas. Ce test montre ce que votre serveur renvoie à ce user-agent ; il ne reproduit pas le contrôle d'adresse IP que font certains pare-feu.
La preuve qui compte reste le passage du robot dans vos logs : la méthode est détaillée dans notre guide de l'analyse de logs GEO. Une fois le robots.txt corrigé, comptez environ 24 heures pour la recherche de ChatGPT selon OpenAI, et jusqu'à 24 heures selon Perplexity.
Le CDN passe avant le robots.txt
Un site qui bloque la catégorie Agent coupe la récupération à la demande, même avec un robots.txt grand ouvert. Le robots.txt ne voit rien passer.
Notez dans la grille le réglage de chaque catégorie, et vérifiez où tombent les robots que vous voulez garder. La même vérification vaut pour les autres CDN et pare-feu applicatifs. Perplexity conseille d'ailleurs de mettre ses robots en liste blanche dans le WAF à partir de ses plages d'IP publiées, comme le détaille notre guide du référencement sur Perplexity.
Bloquer l'entraînement, garder la recherche
L'arbitrage dépend de votre modèle économique.
Un média ou un éditeur qui peut négocier une licence de contenu bloque l'entraînement (GPTBot, ClaudeBot, Google-Extended, Applebot-Extended) et laisse passer les robots d'index de recherche. Il reste citable par les moteurs des assistants sans nourrir les modèles gratuitement. Un point à trancher en connaissance de cause : bloquer Google-Extended coupe aussi l'ancrage des réponses de Gemini, donc une surface de citationMention du NAP d'une entreprise sur des annuaires ou sites tiers..
Un e-commerce, un SaaS ou un site de génération de leads qui cherche le maximum de présence ouvre tout, fiches produits comprises. L'entraînement nourrit ce que le modèle sait de votre marque, l'index des assistants alimente les citations avec lien : autant garder les deux.
Au CDN, ces choix passent par le bon réglage. Chez Cloudflare, un site qui refuse l'entraînement choisit Disallow AI Training pour la catégorie Training : Block couperait aussi GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages., Bingbot et Applebot, donc sa présence dans Google et Bing. Un site qui ouvre tout laisse Training sur Allow.
Disallow AI Training s'écrit dans le robots.txt, et le curl du fichier montre ce que le CDN y a publié. Pour Google et Apple, Cloudflare rappelle que le refus d'entraînement passe par Google-Extended et Applebot-Extended : le réglage coupe donc aussi l'ancrage de Gemini. Bing ne lit pas encore ce refus dans le robots.txt : Microsoft vise début 2027, selon Cloudflare.
Regardez aussi la catégorie Agent. Le préréglage proposé aux nouveaux domaines monétisés par la publicité la bloque sur les pages avec publicité, et les sites existants qui avaient activé l'ancien « Block AI bots » ont migré vers le même réglage. Pour rester récupérable à la demande, repassez Agent sur Allow.
Côté Google, la présence dans les Aperçus IA se règle dans la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche., sous Paramètres, puis IA générative dans la Recherche. Google-Extended, lui, règle l'entraînement des modèles, ceux des fonctionnalités d'IA de la Recherche compris, et l'ancrage dans Gemini, sans effet sur votre présence dans les Aperçus IA. Le détail est dans notre guide des Aperçus IA de Google.
Le JavaScript et le temps de réponse, ce que le robot reçoit vraiment
Un robot d'IA cite ce qu'il trouve dans la réponse de votre serveur. Si le contenu clé n'y est pas, ou si le serveur répond mal, le reste de la grille ne sert à rien.
Le contenu doit être dans le HTML initial
Dans l'étude publiée par Vercel et MERJ en décembre 2024, aucun des grands robots d'IA mesurés n'exécutait le JavaScript : GPTBot, OAI-SearchBot et ChatGPT-User d'OpenAI, ClaudeBot d'Anthropic, PerplexityBot. Seuls Gemini, adossé à l'infrastructure de Googlebot, et AppleBot le rendaient. Claude-SearchBot et Claude-User ne figuraient pas dans l'étude, et le comportement d'un robot peut changer : vos logs et un test sur vos propres pages restent la référence.
Pour l'audit, tout contenu critique injecté par le JavaScript côté client est donc absent pour ces robots. Une application en rendu client qui sert une div vide peut ranker sur Google, qui exécute le JavaScript dans un second temps, et rester invisible pour ChatGPT ou Perplexity.
Le test : curl -s https://votre-site.fr/page | grep "fragment de votre phrase", en choisissant un fragment sans apostrophe ni accent, que le HTML encode parfois. Si votre paragraphe principal n'apparaît pas dans la sortie, il n'est pas dans le HTML initial. Pour mesurer l'écart page par page, un crawlProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. en rendu JavaScript compare le HTML brut et le HTML rendu : notre tutoriel Screaming Frog montre où lire la différence de texte.

La correction passe par le rendu côté serveur ou la génération statique sur les pages stratégiques. C'est le point le plus coûteux de la grille, parce qu'il touche l'architecture ; notre guide du SEO sur React détaille les options framework par framework. Le rendu dynamique (servir du HTML pré-rendu aux seuls robots) dépanne pendant une transition, mais Google le présente comme une solution de contournement, déconseillée. Si vous refondez, visez le SSRTechnique générant le HTML sur le serveur, facilitant l'indexation du contenu JavaScript..
Le serveur doit répondre vite et sans erreur
Les Core Web VitalsMétriques de Google mesurant l'expérience utilisateur : LCP (chargement), INP (interactivité), CLS (stabilité visuelle). mesurent l'expérience dans le navigateur. Un robot qui lit le HTML est sensible à autre chose : le temps de réponse du serveur et ses codes d'erreur. Google l'écrit pour Googlebot : quand la latence augmente ou que le serveur renvoie des erreurs 5xx ou des signaux de limitation comme le code 429, la limite de capacité baisse et Google explore moins.
Les éditeurs d'assistants ne documentent pas de règle équivalente. Et une erreur 5xx ou 429 ne contient pas votre texte.

Dans la grille, l'impact est moyen : notez le temps de réponse des pages stratégiques et les erreurs vues dans les logs, sans refaire votre infrastructure tant que l'accès des robots n'est pas réglé. Le mécanisme côté Google est détaillé dans notre article sur le budget de crawl.
Rendre vos passages extractibles
Un modèle cite un passage plus qu'une page. Perplexity l'a documenté : son moteur découpe les documents en segments autonomes, récupérés et classés un par un, et note les résultats au niveau de la page et au niveau de ses passages. L'audit vérifie donc que vos paragraphes tiennent debout une fois sortis de leur contexte.
Le paragraphe qui se comprend seul
Chaque réponse importante doit tenir dans un paragraphe de deux à quatre phrases qui se comprend sans le reste de la page. Le test est simple : lisez-le seul. Un paragraphe qui commence par « Cela permet aussi de… » ou « Comme vu plus haut… » perd son sens une fois extrait : le modèle ne sait pas à quoi « cela » renvoie. Réécrivez en répétant le sujet en tête de paragraphe. Ça paraît lourd à l'œil, c'est exactement ce qui rend un passage citable.

Des intertitres calés sur les questions réelles
Vos H2Balises HTML structurant le contenu en hiérarchie (H1 à H6). Essentielles pour l'accessibilité et le SEO. et H3 doivent reprendre les questions que se posent vos lecteurs, et la première phrase en dessous y répondre avant de développer. Un intertitre décoratif type « Une approche différente » ne dit rien du passage qui suit. La liste des questions à couvrir sort de vos requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. Search Console et des prompts que vous suivez en GEO.
Listes, tableaux et FAQ dans le HTML
Perplexity indique adapter son extraction aux pages riches en listes et en tableaux bien structurés. L'audit vérifie que vos listes sont de vraies listes HTML, vos tableaux de vrais tableaux, et que vos FAQ sont servies dans le HTML initial, sans attendre un clic sur un accordéon chargé en JavaScript.
Des pages qui citent leurs sources
L'étude fondatrice du GEO, publiée à la conférence KDD 2024, a testé neuf réécritures de contenu sur un moteur génératif. Ajouter des sources citées, des citations et des statistiques faisait partie des trois meilleures méthodes, avec un gain relatif de 30 à 40 % sur sa mesure principale de visibilité. L'effet dépend de votre position : citer ses sources gagnait 115,1 % pour un site classé cinquième dans les résultats de recherche, et perdait 30,3 % pour le premier.

L'audit relève donc les pages stratégiques dont les chiffres n'ont pas d'origine, et celles dont les liens sortants pointent vers des pages mortes ou des sources secondaires.
Données structurées et identité de marque
Les données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets. lèvent l'ambiguïté : elles disent au modèle ce qu'est la page et qui la publie. L'identité de marque se joue surtout hors de votre site, là où vous contrôlez le moins.
Le schema, socle minimal
Google le dit pour ses fonctionnalités d'IA : aucun fichier spécial ni aucun balisage schema.orgVocabulaire standardisé de balisage structuré reconnu par Google, Bing et Yahoo. particulier n'est nécessaire pour y apparaître, et vos données structurées doivent correspondre au texte visible de la page. Le socle tient en trois types : Organization complet, avec sameAs vers vos profils officiels, sur la page d'accueil ou la page À propos (Google précise qu'il n'est pas nécessaire sur chaque page) ; Article ou BlogPosting avec un auteur identifiable sur l'éditorial ; Product sur les fiches.
Côté FAQ, Google a d'abord réservé les résultats enrichis FAQ aux sites gouvernementaux et de santé, puis les a retirés de la recherche le 7 mai 2026 : un balisage FAQPage n'apporte plus d'affichage dans Google, la FAQ lisible en HTML compte davantage.

Testez la validité au Schema Markup Validator, puis la cohérence : un Organization qui annonce un nom de marque différent de votre <title> ou de votre page À propos crée du bruit.
La marque hors de votre domaine
Un modèle décide de vous citer en partie sur ce qu'il sait de votre marque, et cette connaissance vient en grande partie d'autres sites que le vôtre. Commencez par ce que vous contrôlez : une page À propos qui dit qui vous êtes, depuis quand et sur quoi vous faites autorité, avec le schema Organization qui va avec.
Vient ensuite la partie hors site, plus lente à bouger : votre entité Wikidata, une page Wikipédia si votre notoriété le justifie, votre panneau de connaissances Google, et la cohérence de vos informations entre toutes ces sources. Un nom, une adresse ou un fondateur qui divergent entre votre site, votre LinkedIn et Wikidata donnent au modèle deux versions à départager.
Pour un réseau de points de vente, la liste s'allonge : Google demande, pour ses fonctionnalités d'IA, de tenir à jour les informations Merchant CenterPlateforme Google pour gérer les flux produits et apparaître dans Google Shopping. et la fiche d'établissement, ce qui veut dire tout le parc de fiches.

La partie hors site est le poste le plus long. Google rappelle que les panneaux de connaissances sont générés automatiquement ; une fois le vôtre apparu, revendiquez-le depuis le panneau lui-même si Google le permet. Consolider ce que vous maîtrisez (À propos, schema, profils officiels, fiches) va vite et se fait dès le premier mois. La question à poser en fin d'audit : si on demandait à un modèle « qui est [votre marque] », sa réponse serait-elle juste ?
Repérer les pages déjà citées et celles qui devraient l'être
Avant de corriger, mesurez. Le diagnostic consiste à savoir, prompt par prompt, quelles pages et quels concurrents sont cités aujourd'hui. On construit un panel de prompts représentatif de vos intentions de recherche, on le rejoue sur plusieurs assistants à intervalle fixe, et on relève pages, domaines et concurrents cités. Pour le Colisée de Roubaix, Janus, notre outil de suivi, pose ainsi depuis août 2026 68 questions de spectateurs à ChatGPT, Perplexity et Gemini toutes les deux semaines.
De là sortent deux listes. Les pages déjà citées : protégez-les, vérifiez qu'aucun point de la grille ne les fragilise. Les pages qui devraient être citées et ne le sont pas : c'est votre analyse d'écart (gap analysis), et c'est là que l'audit rapporte.

Pour chaque page absente, remontez la cause avec la grille en main. Les robots d'index et de récupération y ont-ils accès ? Le contenu est-il dans le HTML initial ? Le passage répond-il vraiment au prompt visé ? La marque a-t-elle assez de présence hors site sur ce sujet ? Croisez ensuite avec vos pages qui génèrent du chiffre d'affaires : vous obtenez l'ordre de passage.
La grille d'audit et le plan d'action à 30, 60, 90 jours
La sortie d'audit tient en un tableau : chaque point, son impact sur la citabilité, sa difficulté de correction. Commencez par les lignes à impact haut et correction facile. Elles tiennent en un mois. Une partie des contrôles d'accès s'automatise : dans le plugin Claude SEO, la commande /seo agentic vérifie l'accès des agents IA à une URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé..
| Point à vérifier | Impact | Correction |
|---|---|---|
| robots.txt ouvert aux robots d'index de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot) | Haut | Facile |
| Réglage CDN et WAF : Search et Agent autorisés, Training selon votre arbitrage (Allow ou Disallow AI Training, jamais Block) | Haut | Facile |
| Arbitrage entraînement contre recherche décidé et écrit | Moyen | Facile |
| Contenu critique dans le HTML initial (SSR ou génération statique) | Haut | Difficile |
| Temps de réponse serveur et erreurs vues dans les logs | Moyen | Moyen |
| Paragraphes qui se comprennent seuls | Haut | Moyen |
| Intertitres calés sur les questions, réponse directe dessous | Moyen | Facile |
| Listes, tableaux et FAQ servis dans le HTML | Moyen | Facile |
| Chiffres attribués à des sources, liens sortants vivants | Moyen | Facile |
| Schema Organization complet et cohérent | Haut | Facile |
| Article avec auteur, Product selon le type de page | Moyen | Moyen |
| Page À propos claire, profils officiels à jour | Haut | Facile |
| Informations cohérentes sur les sites tiers | Haut | Moyen |
| Panneau de connaissances revendiqué, s'il existe | Moyen | Facile |
| Merchant Center et fiches d'établissement à jour (réseaux de points de vente) | Moyen | Moyen |
| Entité Wikidata | Haut | Difficile |
| Pages citées identifiées, analyse d'écart posée | Haut | Moyen |
Le plan d'action range ces lignes par difficulté de correction. Les 30 premiers jours couvrent tous les points faciles : robots.txt, réglage du CDN, arbitrage écrit entre entraînement et recherche, schema Organization, intertitres, FAQ et tableaux remontés dans le HTML, sources des chiffres, page À propos et profils officiels, revendication du panneau de connaissances s'il existe. Le premier relevé du panel de prompts part aussi ce mois-là : c'est votre point de départ.
De 30 à 60 jours viennent les points moyens : réécriture des passages des pages stratégiques, Article et Product sur les gabarits, temps de réponse du serveur, cohérence des informations sur les sites tiers, Merchant Center et fiches d'établissement pour un réseau de magasins, analyse d'écart. De 60 à 90 jours se lancent les chantiers lourds, le rendu serveur des gabarits qui en ont besoin et l'entité Wikidata, pendant que les relevés suivants montrent ce que les premières corrections ont changé.

Combien coûte un audit GEO, et en combien de temps ?
Fait en interne, le diagnostic technique ne coûte que du temps : robots.txt, logs serveur, curl, validateur de schema et Search Console sont gratuits. Ce qui coûte, c'est la mesure des citations sur des dizaines de prompts et plusieurs assistants, relevé après relevé.
En prestation, notre audit GEO se facture de 1 500Code HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. à 2 500 € HT en version standard (30 à 50 requêtes cibles, 6 modèles IA, benchmarkAnalyse comparative des performances SEO par rapport aux concurrents. sur 5 à 10 concurrents). La version étendue, avec un audit technique approfondi, se facture de 2 500 à 5 000 € HT.
Comptez 2 à 3 semaines entre le cadrage et la livraison du rapport. L'audit donne la photo de départ ; les corrections et le suivi des citations dans la durée relèvent d'un accompagnement d'agence GEO.

Séparez bien deux délais. L'audit prend quelques semaines, et une correction du robots.txt est prise en compte en environ 24 heures selon OpenAI, jusqu'à 24 heures selon Perplexity. L'effet sur vos citations, lui, se lit dans les relevés successifs du panel de prompts : le temps que les robots repassent sur les pages corrigées et que les réponses changent. Prévoyez au moins le trimestre du plan d'action avant de juger.
Questions fréquentes
À quelle fréquence refaire un audit technique GEO ?
Un audit complet une à deux fois par an suffit pour la plupart des sites. Entre deux, surveillez en continu le suivi des citations et le passage des robots dans vos logs. Refaites un audit plus tôt après une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée., un changement de CMS, une migration ou un changement de réglage du CDN, qui peuvent couper l'accès des robots d'IA sans bruit.
Faut-il bloquer GPTBot pour protéger son contenu ?
Tout dépend de votre modèle. Si vous monétisez une licence de contenu, bloquer GPTBot et les autres robots d'entraînement a du sens, à condition de laisser ouverts OAI-SearchBot et les autres robots d'index de recherche pour rester citable. Si votre objectif est la visibilité, bloquer GPTBot vous ferme une porte d'entrée dans les modèles sans contrepartie.
Peut-on faire un audit GEO sans outil payant ?
Le diagnostic technique, oui : robots.txt, logs serveur, curl, validateurs de schema, tout est gratuit. La mesure des citations devient laborieuse à la main : quelques prompts testés donnent une intuition ; la cartographie par assistant et par concurrent demande un outil de suivi, qui fait gagner du temps et de la fiabilité.
L'audit GEO remplace-t-il l'audit SEO ?
Il s'y ajoute. Les deux partagent un socle technique (indexation, performance, structure), et l'audit GEO regarde en plus les robots d'IA, l'extractibilité des passages et l'identité hors site. Avec un budget serré, commencez par l'audit SEO, qui sert aussi le GEO, puis ajoutez la couche GEO sur les pages qui comptent pour votre chiffre d'affaires. Si vous confiez cet audit à un prestataire, notre classement des agences GEO et les questions pour les tester vous aident à vérifier qu'il mesure vraiment les réponses des IA. Ce que cette couche reprend du SEO et ce qu'elle ajoute est posé dans notre définition du GEO.
Sources
- AI features and your website, Google Search Central
- Overview of OpenAI Crawlers, developers.openai.com
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, support.claude.com
- Robots d'exploration courants de Google, Google Search Central
- About Applebot, support.apple.com
- Perplexity Crawlers, docs.perplexity.ai
- Have it both ways: stay discoverable in search while disallowing AI training : blog.cloudflare.com/accountable-mixed-use-ai-crawlers/
- Contrôle de l'IA générative dans la Recherche, Aide Google
- The rise of the AI crawler, vercel.com
- Affichage dynamique : solution de contournement, Google Search Central
- Crawl budget management, Google Search Central
- Architecting and Evaluating an AI-First Search API, perplexity.ai
- GEO: Generative Engine Optimization, arxiv.org
- Changes to HowTo and FAQ rich results, Google Search Central
- Latest Google Search Documentation Updates, Google Search Central
- About knowledge panels, Aide Google
- Valider votre identité sur Google, Aide Google
- claude-seo (README), github.com