




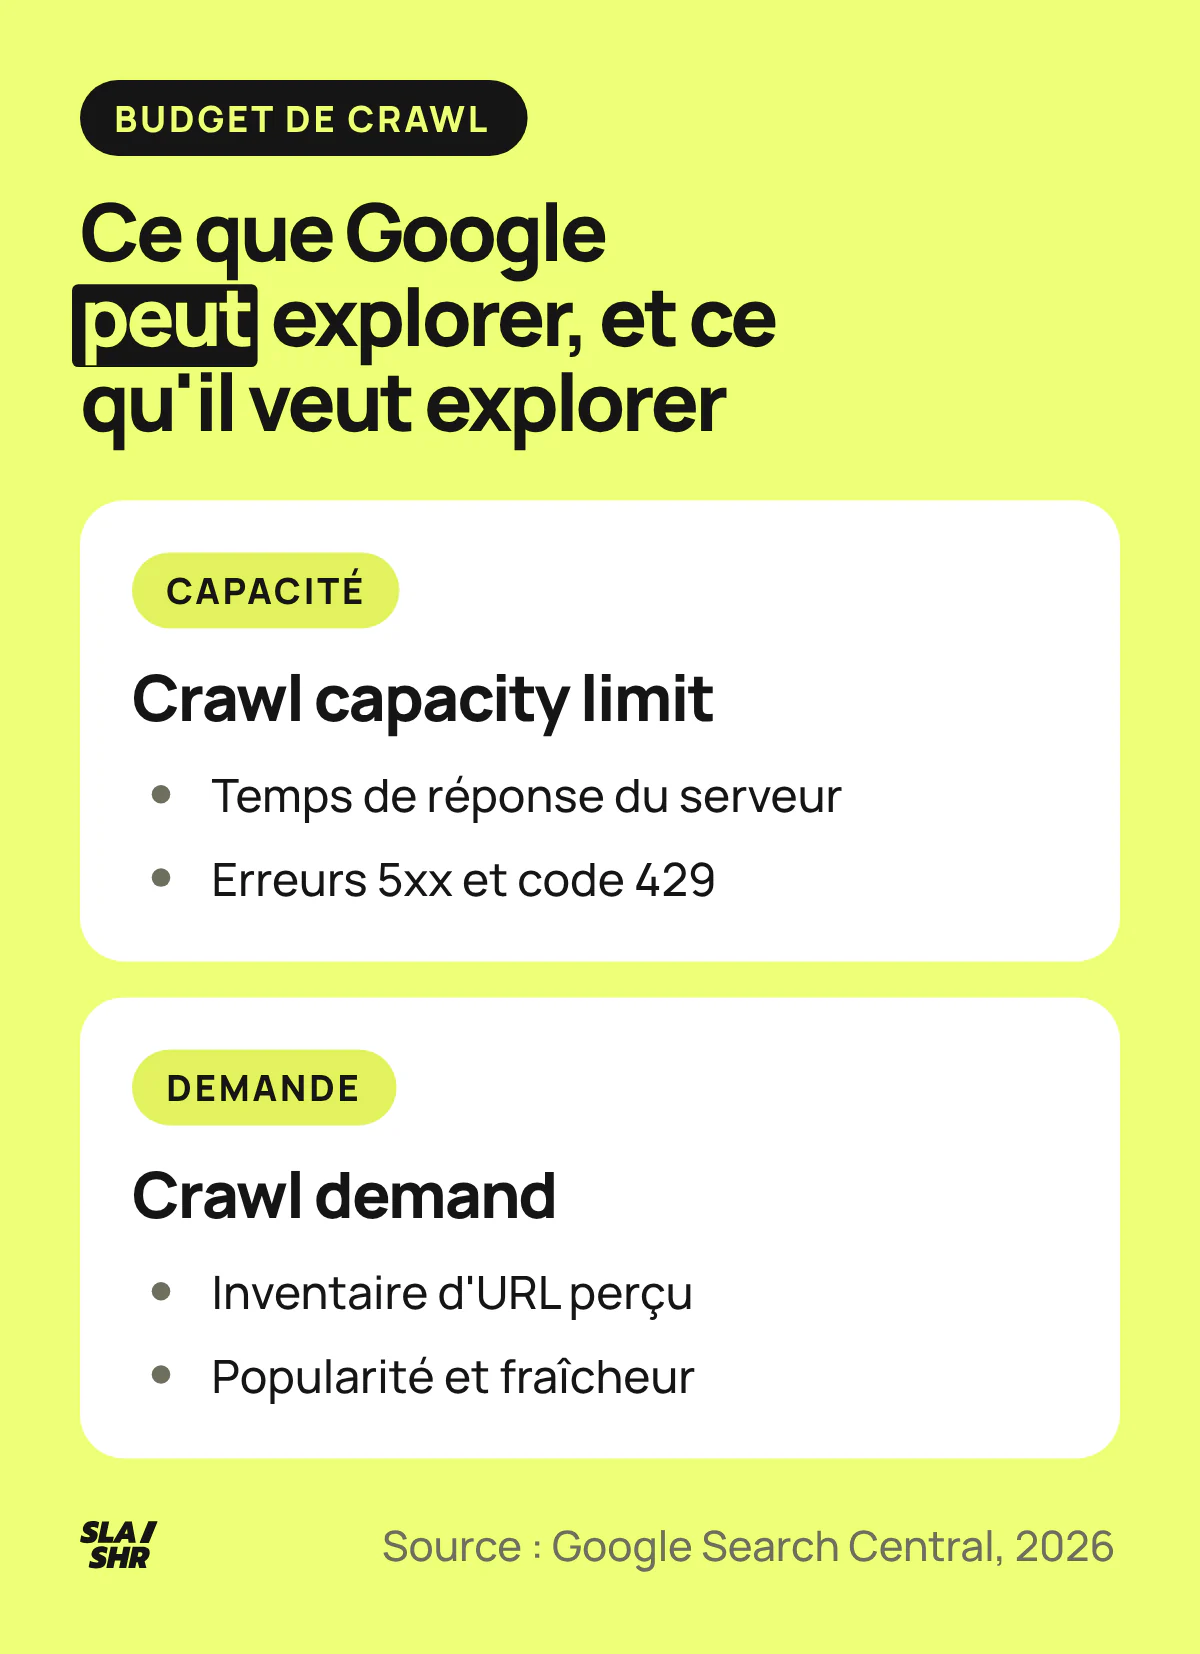
Le crawl budget, ou budget d'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web., est l'ensemble des URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. que Google peut et veut explorer sur votre site. Il croise la capacité de votre serveur et la demande de Google. Il ne freine qu'une minorité de sites : très gros sites, sites de plus de 10 000 pages qui changent chaque jour, sites qui génèrent bien plus d'URL que de pages.
Le budget de crawl : une capacité et une demande
Google fixe le budget de crawl de chaque site en croisant deux limites : ce que votre serveur supporte et ce que Google a envie d'explorer. Sa documentation parle de limite de la capacité d'exploration (crawl capacity limit, aussi appelée charge de l'hôte) et de besoin d'exploration (crawl demand).
La capacité mesure la durée totale pendant laquelle votre serveur garde des connexions ouvertes pour Google, en comptant le nombre de connexions parallèles et leur durée. Chaque site démarre avec la même limite prudente, que Google relève avec le temps si la demande existe et que le site reste en bonne santé. Dans le billet de 2017 où Google a défini le terme, elle s'appelait crawl rate limit. Le principe n'a pas bougé.
La demande dépend, pour Googlebot, de la taille du site, de sa fréquence de mise à jour, de la qualité des pages et de leur pertinence face aux autres sites. Trois facteurs sont entre vos mains : l'inventaire perçu (les URL que Google connaît et tente d'explorer), la popularité des URL sur le web et leur obsolescence, c'est-à-dire le besoin de repasser pour capter les changements.
L'inventaire est celui que vous contrôlez le plus. Une migration peut aussi faire grimper la demande, le temps de traiter le contenu sous ses nouvelles URL.
Trois précisions changent la lecture du sujet :
- Le budget se calcule par nom d'hôte :
www.exemple.fretblog.exemple.front chacun le leur. - La capacité est commune à tous les robots de Google. Une forte demande d'AdsBot sur des annonces dynamiques, ou de Google Shopping sur un flux marchand, peut réduire ce qui reste pour les autres.
- Toute URL explorée compte : les versions hreflang ou AMP, mais aussi les fichiers CSS, le JavaScript et les appels XHR.
Même si la capacité n'est pas atteinte, une demande faible suffit pour que Google explore peu.
L'exploration ne garantit rien : après le crawl, chaque page est évaluée et consolidée avant d'entrer, ou non, dans l'index. Sans indexation, aucun positionnement dans les moteurs de recherche. Explorer plus ne fait pas mieux classer pour autant : Google rappelle que l'exploration est nécessaire pour figurer dans les résultats, mais qu'elle ne fait pas partie des signaux de classementPosition d'une page web dans les résultats de recherche pour une requête donnée..

Le détail de chaque étape, de la découverte des URL au rendu, est dans l'article sur le processus de crawling des moteurs de recherche.
Votre site est-il concerné ? Les trois profils de Google
Google le dit dès les premières lignes de son guide : si vos pages sont explorées le jour de leur publication, ou si votre site n'a pas beaucoup de pages qui changent vite, vous n'avez pas besoin de vous en occuper. Un sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. à jour et un coup d'œil régulier au rapport IndexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. des pages suffisent.
Le guide vise surtout trois profils :
- les sites de plus d'un million de pages uniques dont le contenu change assez souvent, environ une fois par semaine ;
- les sites de plus de 10 000 pages uniques dont le contenu change très vite, chaque jour ;
- les sites dont une grande part des URL est classée « Détectée, actuellement non indexée » dans la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche..
Google prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.ésente ces chiffres comme une approximation pour vous aider à situer votre site. Même ton dans l'aide du rapport Statistiques sur l'exploration : sous 1 000 pages, il ne vous sera probablement d'aucune utilité. Et la taille ne décide pas de tout : un site qui propose du contenu intéressant et qui change souvent est exploré souvent, quelle que soit sa taille.

Le troisième profil est celui qui surprend. Un site de taille moyenne peut y tomber parce que Google connaît bien plus d'URL que le site n'a de pages.
Prenons un exemple fictif : un catalogue de 3 000 produits rangés dans 60 catégories, avec quatre filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. de cinq valeurs chacun, combinables deux à deux. Chaque catégorie produit 20 URL à un filtre et 150 URL à deux filtres (6 paires de filtres, 25 combinaisons de valeurs par paire), soit 170 URL filtrées. Sur 60 catégories, cela fait 10 200 URL. Plus de trois fois le nombre de fiches produits, avant même les tris et la paginationDivision du contenu en plusieurs pages numérotées. Nécessite une gestion SEO spécifique.. Les filtres à facettes sont la première source de ce gonflement.
Si vos pages stratégiques restent en « Détectée » pendant des semaines, le sujet vous concerne. Si elles sont en « Explorée », Google les a vues et la question devient celle de leur valeur : la méthode pour traiter une page explorée, actuellement non indexée aide à trier les deux cas.
Vérifier votre budget de crawl dans la Search Console et les logs
Le budget de crawlNombre de pages que Googlebot peut et veut crawler sur un site dans un temps donné. se vérifie en deux temps : le rapport Statistiques sur l'exploration de la Search Console pour la tendance, puis les logs serveurFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots. pour savoir où part chaque passage de GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages..
Le rapport se trouve dans Paramètres, puis Statistiques sur l'exploration. Il n'existe que pour les propriétés au niveau racine (propriété de domaine, ou préfixe d'URL à la racine du site). Quatre lectures suffisent :
- Demandes d'exploration et temps de réponse moyen, sur le même graphique. Un temps de réponse qui grimpe pendant que les demandes baissent, c'est la capacité qui se resserre.
- État de l'hôte : les problèmes de disponibilité des 90 derniers jours, côté robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer., DNS et connectivité du serveur. Google trace une ligne rouge par catégorie, par exemple plus de 5 % d'échecs de résolution DNS sur une journée.
- Réponses par type : la part des 200, des redirections, des 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. et des 5xx dans les demandes de Googlebot.
- Objectif : la découverte (une URL jamais explorée) face à l'actualisation (une page connue explorée de nouveau). Après l'ajout de beaucoup de contenu ou l'envoi d'un sitemap, la découverte doit monter.
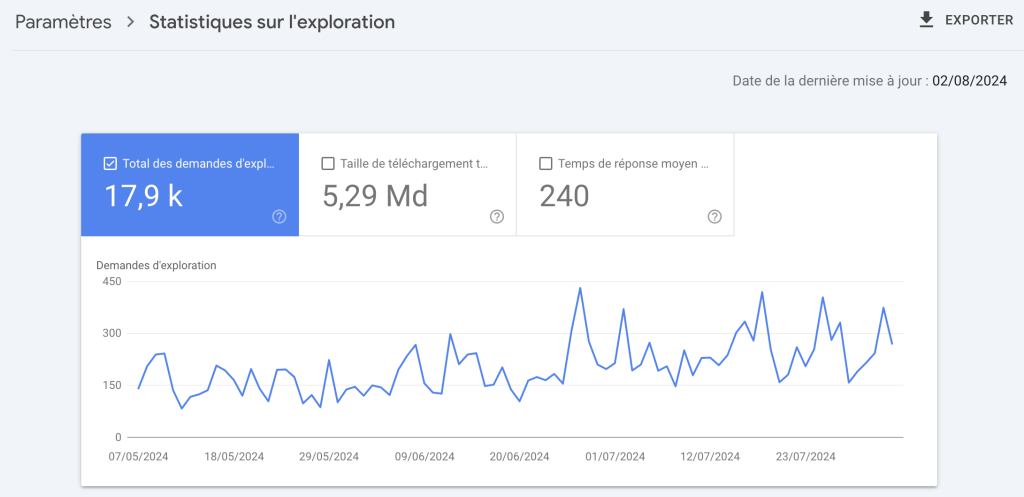
Si le total du rapport dépasse nettement celui de vos logs, regardez la disponibilité du robots.txt : quand le fichier ne répond pas, Google compte les explorations qu'il aurait faites sans les effectuer.
Le rapport donne des totaux. Il ne dit pas quelle famille d'URL consomme le crawl. Pour ça, il faut les logs serveur, lus avec un analyseur comme Botify, Oncrawl, JetOctopus ou Seolyzer : chaque hit de Googlebot, avec l'URL, la date et le code de réponse. Les robots d'IA laissent leur trace dans les mêmes fichiers, et se lisent avec la méthode de l'analyse de logs GEO.
Le premier indicateur à sortir est la part des hits par famille d'URL (fiches produits, catégories, filtres, paramètres de tri, recherche interne, pages éditoriales). Si les URL à paramètres ou à facettes prennent une grosse part des hits pendant que vos fiches attendent, vous tenez votre diagnostic. Sur une marketplace, ajoutez une famille à la liste : les offres de vendeurs publiées sous leur propre URL pour un produit qui a déjà sa fiche, un cas traité dans le guide d'optimisation SEO d'une marketplace.

Croisez ensuite avec un crawl du site, fait avec Screaming Frog ou Sitebulb, et avec le rapport Indexation des pages. Les URL que vous voulez voir explorées et que Googlebot ne visite jamais : voilà le vrai coût du budget gaspillé.
Ce qui gaspille le crawl : l'inventaire d'URL d'abord
Le gaspillage vient d'URL que Google connaît et qui ne méritent pas son temps. Google présente l'inventaire comme le facteur que vous contrôlez le plus : sans consigne, il tente d'explorer la totalité ou la plupart des URL qu'il connaît, et chaque doublon ou URL sans importance lui prend du temps. S'il passe trop de temps sur ces URL, ses robots peuvent renoncer au reste du site, ou ne pas augmenter votre budget. Le reste du site attend.
Les familles qui reviennent :
- Facettes et filtres combinés, qui multiplient les URL par catégorie, comme dans l'exemple plus haut.
- Tris et paramètres :
?tri=prix, identifiants de session, paramètres de suivi. Google sait explorer les paramètres ; le problème vient du nombre de variantes d'une même page. - Recherche interne dont les pages de résultats sont liées, donc explorables.
- Doublons : versions avec et sans slash final, déclinaisons d'un même produit sur des URL distinctes.
- Pages vides servies en 200, les soft 404, que Google continue d'explorer.
- Défilement infini et pagination qui reprennent les mêmes produits sous d'autres URL.
- Chaînes de redirections : Googlebot suit jusqu'à 10 sauts, mais les longues chaînes pèsent sur l'exploration. Google recommande de rediriger directement vers la destination finale, sinon idéalement 3 sauts au plus, et moins de 5 au pire. Une redirection gardée au moins un an lui laisse le temps de transférer tous les signaux vers la nouvelle URL.
Les pages en 404, elles, ne gaspillent pas votre budget. Google range l'inverse parmi ses idées reçues sur l'exploration : les codes 4xx, sauf le 429, ne gaspillent rien, puisque Google reçoit un code et aucun contenu. La fréquence d'exploration d'une 404 baisse même peu à peu. La soft 404 ressemble à une page vivante, et Google continue de l'explorer.
Le cas Skroutz : 25 millions d'URL indexées, puis 7,6 millions
Skroutz, comparateur de prix grec, a publié en 2019 le détail de son chantier. Au départ, la Search Console affichait près de 25 millions d'URL indexées. Avec un budget moyen d'environ un million d'explorations par jour, Googlebot ne pouvait passer que sur 4 % des pages chaque jour, et plus de la moitié de ce budget quotidien partait dans les pages de recherche interne, la plupart sans aucun trafic.
L'équipe a passé en revue 2,7 millions de mots-clésTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. de recherche interne : 2,2 millions sont passés en noindexDirective indiquant aux moteurs de ne pas indexer une page., 300 000 ont été redirigés vers un filtre ou une catégorie, 200 000 ont été gardés. À la publication de l'étude, l'index était descendu de 25 à 7,6 millions d'URL, et une nouvelle URL s'indexait et se positionnait en quelques jours au lieu de 2 à 3 mois. Le cas montre aussi la lenteur du noindex : seules 38,28 % des URL de recherche interne passées en noindex n'avaient reçu aucune visite de Googlebot depuis au moins six mois. Les autres continuaient d'être explorées.

Optimiser le crawl famille par famille : robots.txt, 404, 301, canonical ou noindex
Chaque famille d'URL a sa consigne, et le mauvais choix coûte des mois. La règle de départ : le robots.txt pour ce que Google ne doit jamais explorer, un code HTTP pour ce qui n'existe plus, la redirection ou la canonique pour les doublons, le noindex pour ce qui doit sortir de l'index.
| Famille d'URL | Consigne | Effet sur le crawl | Piège |
|---|---|---|---|
| Tris, filtres sans demande, recherche interne jamais indexée | Disallow dans le robots.txt |
Google n'explore plus ces URL | Une URL bloquée peut rester indexée si des liens pointent vers elle |
| Page supprimée, combinaison de filtres sans résultat | 404 ou 410 | Signal fort de ne plus explorer, fréquence en baisse progressive | Une page vide servie en 200 continue d'être explorée |
| Doublon avec un équivalent exact | Redirection 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. directe | Une URL de moins à explorer à terme | Les chaînes de redirections pèsent sur l'exploration |
| Variante filtrée à garder accessible | Canonique vers la version principale | Peut réduire à terme l'exploration des variantes | Moins efficace sur la durée que le robots.txt |
| Page indexée à sortir de Google | noindex, puis Disallow une fois la page sortie | Aucun gain immédiat : Google explore pour lire le noindex | Bloquée trop tôt, la page garde un noindex que Google ne voit pas |
Le robots.txt coupe l'exploration. Google le recommande pour les pages utiles aux visiteurs mais sans intérêt dans la recherche, comme les versions triées d'une même page ou le défilement infini qui reprend des pages déjà liées, quand vous ne pouvez pas les consolider. Deux limites : une URL bloquée reste dans la file d'exploration bien plus longtemps qu'une 404, et Google la réexplore dès que le blocage est levé. Le blocage ne sert pas non plus à réallouer le budget pour quelques semaines : Google ne reporte le budget libéré sur d'autres pages que si votre site est déjà près de sa limite de capacité. La syntaxe et les lignes à poser sont dans le guide pour gérer le robots.txt en SEO.
Le noindex sert à sortir une page de l'index. Il ne fait pas économiser de crawl sur le moment : Google demande la page, lit la consigne, puis l'abandonne. À long terme, il peut libérer un peu d'exploration, puisque les URL sorties de l'index laissent Google se concentrer sur les autres. Pour une page déjà indexée, l'ordre compte : noindex d'abord, blocage dans le robots.txt seulement une fois la page sortie de l'index. Bloquée avant, la page n'est plus explorée et Google ne lit jamais la consigne. Le guide pour désindexer une URL détaille cet ordre.

La 404 ou la 410 pour ce qui n'existe plus, y compris une combinaison de filtres qui ne renvoie aucun produit. Google demande dans ce cas un vrai code 404 sous l'URL concernée, plutôt qu'une redirection vers une page d'erreur commune.
La canonique et le nofollowAttribut indiquant aux moteurs de ne pas suivre un lien ou de ne pas transmettre de jus SEO. marchent moins bien. Google indique qu'une canonique vers la version non filtrée peut, à terme, réduire l'exploration des variantes, et juge ces deux méthodes moins efficaces sur la durée que le robots.txt. Le nofollow ne protège une URL que si aucun autre lien, sur votre site ou ailleurs, ne pointe vers elle sans nofollow. Pour des filtres très nombreux, l'obfuscation de liens remplace le lien HTML par un élément que Googlebot ne suit pas ; Google propose de son côté les fragments d'URL (#couleur=bleu), que sa recherche n'explore pas en règle générale.
Avant de trancher, croisez trois données par famille d'URL : les hits de Googlebot dans les logs, le trafic organiqueVisites provenant des résultats de recherche naturels (non payants) des moteurs de recherche. et l'état d'indexation. Skroutz a procédé ainsi : noindex pour les pages de recherche interne sans session organique sur les deux derniers mois, ou presque sans session et avec trois explorations au plus sur six mois. Garder une partie des requêtes internes indexées, comme les 200 000 que Skroutz a conservées, relève du searchdexing, qui transforme des recherches internes en pages indexées, avec ses propres règles de filtrage.
Serveur et rendu : la capacité d'exploration
La capacité suit la santé de votre serveur. Un serveur lent fait reculer Google. Si le site répond de façon régulière et que ses temps de réponse, latence et Time to First ByteTime To First Byte. Temps entre la requête et la réception du premier octet de réponse du serveur. compris, restent stables ou s'améliorent, la limite monte. S'il ralentit, renvoie des erreurs 5xx ou des signaux de limitation comme le code 429, elle baisse et Google explore moins. Les URL déjà indexées restent dans l'index pendant ces erreurs, puis finissent par en sortir si elles persistent.
Côté chiffres, Botify a publié des données de terrain.
D'après les données de ses clients publiées en 2019, les pages chargées en moins de 500Code HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. ms reçoivent environ 50 % de crawl en plus que celles entre 500 et 1 000 ms, et environ 130 % de plus que celles au-delà de 1 000 ms. C'est une corrélation, observée sur des sites clients de l'outil. Elle donne un ordre de grandeur, avec une nuance : Botify mesure le chargement des pages, alors que le temps de réponse moyen de la Search Console porte sur toutes les ressources récupérées.

Autre nuance, signée Google : il peut consacrer plus de temps à un site plus lent dont les informations sont plus importantes, et il juge plus utile d'accélérer un site pour ses visiteurs que pour la couverture d'exploration. Trois actions jouent directement sur la capacité :
- Le cache HTTP : répondre 304 (Not Modified) quand une page n'a pas changé depuis le dernier passage. Google réutilise sa copie, et votre serveur économise de la bande passante.
- Le rendu : le temps passé à afficher une page compte autant que le temps passé à la demander. Une page qui n'existe qu'après exécution du JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. coûte plus cher et attend son tour dans une file de rendu. Avec le rendu côté serveur (SSR), le contenu des pages stratégiques est déjà dans le HTML de la réponse, et les erreurs JavaScript qui pénalisent le SEO en donnent les cas courants.
- Les ressources serveur : si l'outil d'inspection d'URL affiche « Charge de l'hôte dépassée », Google conseille d'ajouter des ressources serveur, si c'est rentable pour votre activité.
En cas de surcharge, Google propose de bloquer le robot en cause dans le robots.txt ou de renvoyer des codes 503 ou 429, et de lever le blocage deux ou trois jours plus tard. La règle crawl-delay du robots.txt n'est pas lue par ses robots.
Faire monter la demande : popularité, maillage et fraîcheur réelle
La demande traduit l'envie de Google de revenir. La popularité passe en premier : les URL les plus populaires sur le web ont tendance à être explorées plus souvent, pour rester à jour dans ses systèmes. Les liens externes vers vos pages profondes et le maillage interneEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. qui leur transmet de la popularité sont vos deux leviers. Pour le second, choisir les pages à pousser et leurs ancres avec la Search Console évite de mailler au hasard.
La distance à la page d'accueil joue aussi. Les pages liées directement depuis la home peuvent être jugées plus importantes et explorées plus souvent ; Google précise que cela ne les fait pas mieux classer. Un mega menu crawlable, lui, place tout le catalogue à un clic de chaque page : notre simulation de PageRank sur un mega menu montre comment l'autorité s'y répartit à plat. Une fiche reléguée en page 5 d'une catégorie gagne donc à recevoir un lien depuis une page forte du site.
Une page orphelinePage sans aucun lien interne pointant vers elle, difficilement accessible pour les moteurs., absente du maillage comme du sitemap, n'a plus que les liens externes pour être découverte : Google n'a pas de registre central des pages et les trouve en suivant des liens ou en lisant des sitemaps.

La fraîcheur compte quand elle est réelle. Google veut repasser assez souvent pour capter les changements, et il lit régulièrement votre sitemap : gardez-le à jour, avec la balise <lastmod> pour le contenu modifié.
Les retouches cosmétiques et les dates changées sans raison n'apportent rien, car pour la recherche Google le contenu est évalué sur sa qualité, quel que soit son âge. Même logique pour les URL versionnées : changer l'URL pour forcer un passage marche probablement, mais gaspille des ressources si le contenu n'a pas vraiment changé.
Enfin, pour la recherche, Google tient compte de la popularité, de la valeur globale pour l'utilisateur et de l'originalité du contenu quand il répartit ses ressources d'exploration. Un site rempli de pages fines et de doublons se pénalise deux fois : il gonfle l'inventaire et il fait baisser la demande.
L'ordre de travail tient donc en quatre étapes : vérifier si votre site entre dans un des trois profils, ouvrir le rapport Statistiques sur l'exploration, sortir des logs la part des hits de Googlebot par famille d'URL, puis poser la consigne du tableau famille par famille. La vitesse du serveur et la demande viennent ensuite, une fois l'inventaire assaini.
Questions fréquentes
Comment connaître le budget de crawl de son site ?
La Search Console n'affiche pas de « budget » en tant que tel. Le rapport Statistiques sur l'exploration (dans Paramètres) donne le nombre de demandes d'exploration par jour, le temps de réponse moyen et l'état de l'hôte ; vos logs serveur disent quelles URL Googlebot visite. Attention au total : il compte aussi les ressources des pages (CSS, JavaScript, images) et chaque demande en double. Pour estimer ce que Google explore de vos pages, filtrez le tableau par type de fichier sur la ligne HTML, puis rapportez ce volume aux URL que vous voulez voir explorées.
Le crawl budget est-il un facteur de classement ?
Non. Google l'écrit : l'exploration est nécessaire pour qu'une page figure dans les résultats, mais elle ne fait pas partie des signaux de classement, et explorer plus ne garantit aucune meilleure position. Le budget compte parce qu'une page que Google n'explore pas ne peut être ni indexée avec son contenu, ni mise à jour.
Le noindex permet-il d'économiser du budget de crawl ?
Pas sur le moment. Google doit explorer la page pour lire le noindex, puis il l'abandonne. Le gain vient plus tard et indirectement, une fois les URL sorties de l'index. Pour qu'une URL ne soit plus explorée du tout, il faut le robots.txt, une fois la page sortie de l'index.
Un petit site doit-il s'occuper du crawl budget ?
Rarement. Si vos pages sont explorées le jour de leur publication, Google estime que vous n'avez pas besoin de son guide : un sitemap à jour et le rapport Indexation des pages suffisent. L'exception concerne les sites qui génèrent beaucoup plus d'URL que de pages, avec des filtres, des tris ou une recherche interne explorable.
Les erreurs 404 consomment-elles du budget de crawl ?
Non. Les codes 4xx, sauf le 429, ne gaspillent pas de budget : Google reçoit un code et aucun contenu, et la fréquence d'exploration de l'URL baisse peu à peu. Les soft 404, des pages vides servies en 200, continuent en revanche d'être explorées.
Sources
- Gestion du budget d'exploration, Google Search Central
- What Crawl Budget Means for Googlebot, Google Search Central
- Idées reçues et faits avérés concernant l'exploration, Google Search Central
- Rapport "Statistiques sur l'exploration", Aide Google
- Effet des codes d'état HTTP sur les robots d'exploration Google, Google Search Central
- [Case Study] How we optimized our Crawl Budget : engineering.skroutz.gr/blog/SEO-Crawl-Budget-Optimization-2019/
- Présentation du fichier robots.txt et guide, Google Search Central
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Gérer l'exploration des URL de navigation à facettes, Google Search Central
- Crawl Budget Optimization For Classified Websites : botify.com/blog/crawl-budget-optimization-for-classified-websites
- Comprendre les bases du SEO JavaScript, Google Search Central
- Guide détaillé de la recherche Google, Google Search Central
- Migrations de sites, Google Search Central