




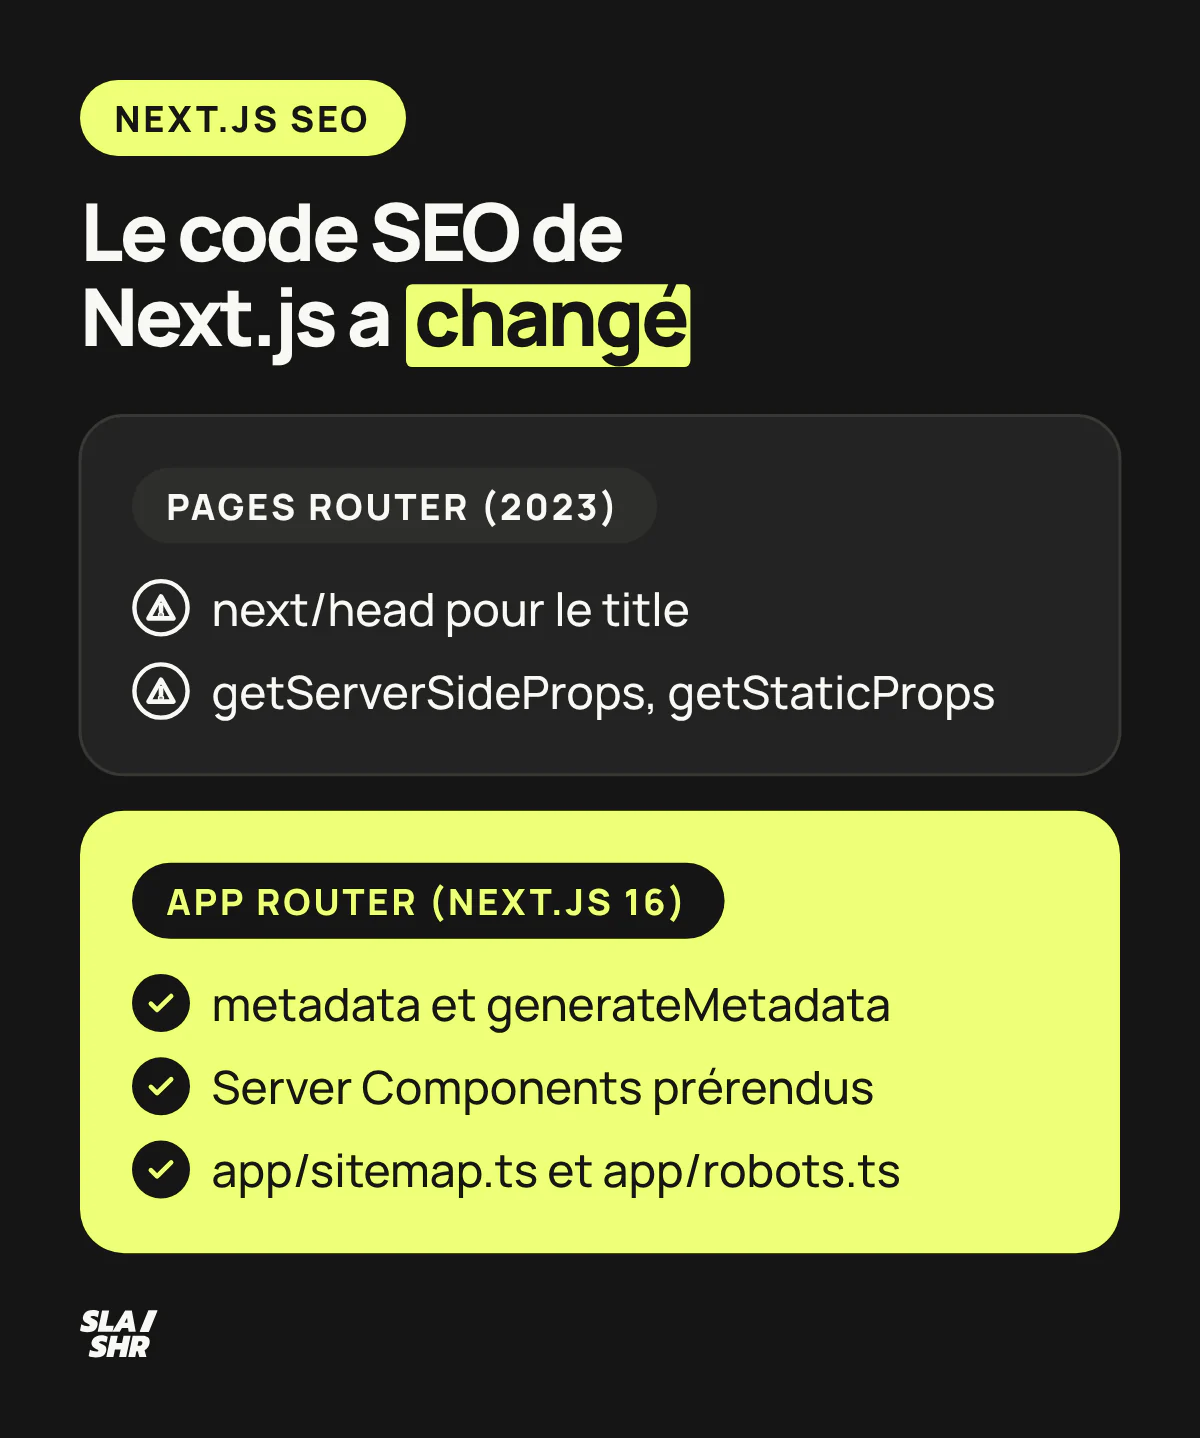
Next.js se référence bien parce qu'il envoie au robot une page déjà rendue en HTML, à condition de laisser le contenu côté serveur. Avec l'App Router de Next.js 16, le SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. se règle à quatre endroits : le rendu de chaque page, l'API Metadata, les fichiers sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche..ts et robots.ts, puis le JSON-LDFormat recommandé par Google pour implémenter les données structurées dans le code source..
Ce que Next.js envoie vraiment aux robots
Avec l'App Router, une page arrive chez le robot déjà rendue en HTML, Client Components compris. Les layouts et les pages sont des Server Components par défaut, rendus sur le serveur. Les composants marqués 'use client' passent eux aussi par le serveur : la documentation de Next.js précise que les Client Components servent à prérendre le HTML, que le navigateur hydrate ensuite.
Un composant interactif marqué 'use client' reste donc indexable. Le contenu disparaît du HTML dans trois cas.
Le premier, c'est l'import dynamique avec ssr: false, qui désactive le prérendu du composant. Réservez-le à une carte des magasins ou à un graphique : un bloc de texte qui doit ranker reste prérendu. L'option ne fonctionne d'ailleurs que dans un Client Component.
'use client'
import dynamic from 'next/dynamic'

// Carte interactive : rien à indexer, chargée seulement dans le navigateur
const StoreMap = dynamic(() => import('./StoreMap'), { ssr: false })

type Store = { id: string; city: string }

export default function StoreLocator({ stores }: { stores: Store[] }) {
  return (
    <section>
      <h2>Nos magasins</h2>
      <ul>{stores.map((s) => <li key={s.id}>{s.city}</li>)}</ul>
      <StoreMap stores={stores} />
    </section>
  )
}
Le second, ce sont les données chargées dans un useEffect, côté navigateur. Le serveur rend le squelette, le texte arrive après l'exécution du JavaScript. Googlebot finit par le voir au rendu, les robots qui n'exécutent pas le JavaScript ne le voient jamais.
Le troisième est plus discret. Sur une route prérendue, un Client Component qui appelle useSearchParams fait passer en rendu client tout l'arbre jusqu'à la frontière <Suspense> la plus proche. Sans aucune frontière, next build échoue, ce qui évite le pire. Le piège est la frontière posée trop haut, un loading.tsx de segment par exemple : tout ce qu'elle enveloppe sort du HTML initial. Enveloppez ce composant dans sa propre <Suspense>, au plus près.
Le streaming garde le contenu dans la réponse. Le texte d'une frontière <Suspense> arrive dans la même réponse HTML, et la documentation de Next.js l'écrit en toutes lettres : le streaming étant rendu côté serveur, il n'a pas d'impact sur le SEO. Son effet se voit sur le code HTTP : une fois le flux lancé, une page introuvable reste en 200 avec un noindex.
Ce piège de notFound(), le rendu différé de Googlebot et les robots d'IA qui n'exécutent pas le JavaScript sont détaillés dans le guide React SEO, qui vaut pour tout site React, Next.js compris.

Le contrôle se fait en une commande, sans navigateur :
curl -s httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.example.com/blog/mon-article | grep -iE "<title|<h1Balise HTML du titre principal d'une page. Il ne doit y en avoir qu'un seul par page.|canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire.|<a "
Si le title, le H1 ou les liens manquent, le contenu dépend du navigateur. Faites-le sur chaque gabarit qui doit ranker : accueil, catégorie, fiche, article.
Quel rendu choisir pour chaque page avec l'App Router ?
Le rendu se choisit page par page : prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.érendu pour ce qui est stable, régénération pour ce qui change à intervalle, rendu à la requête pour ce qui dépend du visiteur. Les quatre modes classiques gardent leur nom : SSG, ISR, SSRTechnique générant le HTML sur le serveur, facilitant l'indexation du contenu JavaScript. et CSR. Seule change la façon de les déclarer.
Dans l'App Router, getStaticProps et getServerSideProps sont remplacés par des Server Components asynchrones qui chargent leurs données avec fetch ou n'importe quelle fonction serveur, et le mode de rendu découle de ce que fait la page. Next.js 16 fait cohabiter deux façons de l'écrire. Les nouvelles applications créées avec les réglages recommandés de create-next-app activent Cache Components. Un projet existant passé en version 16 garde le modèle précédent tant qu'il n'active pas l'option cacheComponents.
| Mode | Pages concernées | Avec Cache Components (nouveaux projets) | Modèle précédent |
|---|---|---|---|
| SSG, génération statique | Accueil, articles, landing, documentation | Données mises en cache avec 'use cache', generateStaticParams pour les routes dynamiques |
Server Component sans donnée liée à la requête, generateStaticParams |
| ISR, régénération incrémentale | Fiches produit, catégories, articles mis à jour | 'use cache' et cacheLife('hours') |
export const revalidate = 3600 |
| SSR, rendu à la requête | Recherche interne, pages personnalisées | Donnée non mise en cache ou cookies(), sous <Suspense> |
cookies(), headers(), ou fetch avec cache: 'no-store' |
| CSR, rendu client | Espace client, tableau de bord | Client Component qui charge ses données dans le navigateur, hors indexProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. | Idem |
Avec Cache Components, Next.js considère toute donnée asynchrone comme lue à chaque requête, sauf si vous la mettez en cache avec 'use cache'. La page est prérendue en « static shell » : ce qui est en cache y entre, le reste arrive en streaming dans la même réponse, sous une frontière <Suspense>.
Lire cookies() ne fait plus basculer toute la route en rendu dynamique, seulement la frontière concernée. Les options revalidate et dynamic disparaissent dès que le modèle est activé, et Next.js annonce qu'il sera activé partout à la prochaine version majeure.
Pour un blog ou un catalogue, le schéma qui prérend tout tient en deux gestes : les fonctions de données mises en cache, et la liste des URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. fournie par generateStaticParams.
// lib/posts.ts (Cache Components activé : cacheComponents: true)
import { cacheLife } from 'next/cache'

export type Post = {
  slugPartie de l'URL identifiant une page spécifique, généralement après le nom de domaine.: string
  title: string
  excerpt: string
  author: string
  date: string
  updatedAt: string
}

export async function getPost(slug: string): Promise<Post | null> {
  'use cache'
  cacheLife('hours')
  const res = await fetch(`https://cms.example.com/posts/${slug}`)
  if (!res.ok) return null
  return res.json()
}

export async function getPosts(): Promise<Post[]> {
  'use cache'
  cacheLife('hours')
  const res = await fetch('https://cms.example.com/posts')
  return res.json()
}
Avec cacheLife('hours'), le contenu se régénère à l'heure : c'est l'ISR de ce modèle. 'use cache' n'existe qu'avec Cache Components. Dans le modèle précédent, retirez 'use cache' et cacheLife : le même résultat passe par generateStaticParams, qui prérend au build les URL d'une route dynamique, et export const revalidate = 3600, qui régénère la page en arrière-plan au plus une fois par heure. Appeler cookies() y fait basculer la route entière en rendu dynamique. Utile pour un panier. Coûteux sur une page qui pourrait sortir du cache.

Pour le SEO, la règle ne bouge pas d'un modèle à l'autre. Le contenu qui doit ranker est dans le HTML envoyé par le serveur, prérendu ou rendu à la requête. Le navigateur n'y ajoute rien qui doive ranker. Les compromis du rendu côté serveur et SEO, temps de réponse et cache en tête, se règlent avant de basculer une page en rendu dynamique.
Title, meta et canonical : l'API Metadata
Dans l'App Router, les balises du <head> passent par l'objet metadata ou par la fonction generateMetadata, exportés depuis un layout ou une page. next/head appartient au Pages Router : dans le dossier app, cette API le remplace.
Le layout racine porte ce qui vaut pour tout le site : l'URL de base et le modèle de title.
// app/layout.tsx
import type { Metadata } from 'next'

export const metadata: Metadata = {
  metadataBase: new URL('https://www.example.com'),
  title: {
    template: '%s | Ma Marque',
    default: 'Ma Marque',
  },
}

export default function RootLayout({ children }: { children: React.ReactNode }) {
  return (
    <html lang="fr">
      <body>{children}</body>
    </html>
  )
}
metadataBase transforme les chemins relatifs (canonical, images Open Graph) en URL absolues. Sans lui, un chemin relatif dans un champ d'URL provoque une erreur de build. Le modèle %s | Ma Marque s'applique aux segments enfants, pas au segment qui le définit, et il exige une valeur default.
Chaque page dynamique calcule ensuite ses propres balises :
// app/blog/[slug]/page.tsx
import type { Metadata } from 'next'
import { notFound } from 'next/navigation'
import { getPost, getPosts } from '@/lib/posts'

type Props = { params: Promise<{ slug: string }> }

export async function generateStaticParams() {
  const posts = await getPosts()
  return posts.map((post) => ({ slug: post.slug }))
}

export async function generateMetadata({ params }: Props): Promise<Metadata> {
  const { slug } = await params
  const post = await getPost(slug)
  if (!post) notFound()
  return {
    title: post.title,
    description: post.excerpt,
    alternates: { canonical: `/blog/${slug}` },
    openGraph: { type: 'article', publishedTime: post.date },
  }
}

export default async function Page({ params }: Props) {
  const { slug } = await params
  const post = await getPost(slug)
  if (!post) notFound()
  return <h1>{post.title}</h1>
}
Les params sont une promesse qu'on attend avec await, et ces exports ne fonctionnent que dans des Server Components. C'est voulu : les métadonnées sont résolues sur le serveur avant le rendu de la page, ce qui les place dans la réponse HTML initiale.
Avec generateStaticParams et des données en cache, Next.js accepte un await params direct, sans <Suspense>, et prérend chaque article au build, métadonnées comprises. Gardez notFound() avant toute frontière <Suspense> ou loading.tsx : appelé avant le début du streaming, il renvoie un vrai 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget.. getPost est appelé deux fois, et le second appel lit le cache de 'use cache'. Dans le modèle précédent, seules les requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. fetch identiques sont mémorisées automatiquement : une fonction qui interroge une base de données s'enveloppe dans cache de React.
La canonical relative /blog/${slug} devient une URL absolue grâce à metadataBase. Écrivez-la sans slash final : par défaut, Next.js redirige /about/ vers /about. Le reste des règles est dans le guide de la balise canonical. Une page à garder hors de l'index reçoit robots: { index: false } dans le même objet.

Reste le cas des pages rendues à la requête. Next.js y diffuse les métadonnées en streaming : la page part sans les attendre, et les balises sont ajoutées à la fin du <body> quand generateMetadata a répondu. Next.js dit avoir vérifié que les robots qui exécutent le JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche., GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. en tête, les lisent correctement.
Les robots qui n'exécutent pas le JavaScript reçoivent les balises dans le <head>, repérés à leur user agent. La liste par défaut couvre les robots de Google suffixés -Google, Bingbot, Applebot, Twitterbot ou LinkedInBot. GPTBot, ClaudeBot et PerplexityBot n'y figurent pas. Sur une page rendue à la requête, ils trouvent title, description et canonical en fin de <body>.
Le curl du début ne voit pas la différence, il trouve les balises où qu'elles soient. Pour savoir ce que reçoit un robot d'IA, isolez le <head> :
curl -s -A "GPTBot" https://www.example.com/blog/mon-article | awk -v RS='</head>' 'NR==1' | grep -i "<title"
Le plus sûr, pour une page qui doit être citée, reste le prérendu : ses métadonnées sont résolues au build, sans streaming. Sinon, l'option htmlLimitedBots de next.config.ts règle la liste, et la valeur /.*/ coupe le streaming des métadonnées pour tout le monde, au prix d'un temps de réponse plus long. Une liste personnalisée remplace celle de Next.js : reprenez la liste par défaut avant d'y ajouter des robots.
Sur un site éditorial, Next.js sert souvent de front à un CMS headless. Le choix de ce CMS, comparé dans le panorama des CMS, décide de ce que les rédacteurs pourront régler eux-mêmes : title, description, slug, canonical.
Sitemap, robots.txt et JSON-LD sans paquet tiers
L'App Router génère le sitemap.xml et le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. à partir de fichiers TypeScript placés dans app, et les données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets. se rendent comme une balise <script> dans la page.
// app/sitemap.ts
import type { MetadataRoute } from 'next'
import { getPosts } from '@/lib/posts'

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getPosts()
  return posts.map((post) => ({
    url: `https://www.example.com/blog/${post.slug}`,
    lastModified: post.updatedAt,
  }))
}
Avec Cache Components, le fichier est prérendu tant que ses données passent par 'use cache', comme getPosts ici. Dans le modèle précédent, il est mis en cache par défaut, sauf s'il utilise une API liée à la requête.
Les champs changeFrequency et priority de la documentation Next.js sont facultatifs, et Google ignore ces deux valeurs : gardez l'URL et une vraie date de modification. Au-delà de 50 000 URL, la limite de Google pour un sitemap, generateSitemaps découpe le fichier en plusieurs sitemaps. Le reste des règles se trouve dans le guide du sitemap SEO.
// app/robots.ts
import type { MetadataRoute } from 'next'

export default function robots(): MetadataRoute.Robots {
  return {
    rules: { userAgent: '*', allow: '/', disallow: ['/compte/', '/panier/'] },
    sitemap: 'https://www.example.com/sitemap.xml',
  }
}
Ne bloquez jamais /_next/ : Next.js y sert le JavaScript et le CSS de chaque page, et Google n'exécute pas le JavaScript des fichiers bloqués par le robots.txt. Une règle posée pour « alléger le crawlProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. » peut vider la page rendue. Le robots.txt en SEO se revérifie après chaque changement de structure.
Pour le JSON-LD, Next.js recommande de rendre une balise <script> dans le layout ou la page. Voici la page de l'article complétée, qui remplace la version précédente :
// app/blog/[slug]/page.tsx : composant Page complété
export default async function Page({ params }: Props) {
  const { slug } = await params
  const post = await getPost(slug)
  if (!post) notFound()

  const jsonLd = {
    '@context': 'https://schema.orgVocabulaire standardisé de balisage structuré reconnu par Google, Bing et Yahoo.',
    '@type': 'BlogPosting',
    headline: post.title,
    datePublished: post.date,
    author: { '@type': 'Person', name: post.author },
  }

  return (
    <article>
      <script
        type="application/ld+json"
        dangerouslySetInnerHTML={{
          __html: JSON.stringify(jsonLd).replace(/</g, '\\u003c'),
        }}
      />
      <h1>{post.title}</h1>
    </article>
  )
}
Le replace protège la page. JSON.stringify ne filtre pas les chaînes malveillantes : un titre qui contiendrait </script> ouvrirait une faille XSS, d'où le remplacement de < par son équivalent unicode. Validez le résultat avec le test des résultats enrichis de Google. Le choix des types de schéma est traité dans le guide des données structurées.

Et le paquet next-seo ? Depuis sa version 7, sortie le 17 octobre 2025, il s'est recentré sur des composants JSON-LD typés ; la dernière version, la 7.3.0, date du 29 juillet 2026. Son README renvoie vers generateMetadata pour les balises title et meta, et garde les anciens composants pour le Pages Router sous next-seo/pages. Il reste pratique si vous posez beaucoup de schémas différents, et superflu pour le reste.
Images, liens et redirections
next/image et next/link font le travail si on les règle bien : dimensions déclarées et image principale chargée tout de suite, liens rendus en <a href>, redirections permanentes déclarées dans la configuration.
import Image from 'next/image'

export default function Hero() {
  return (
    <Image
      src="/images/atelier.jpg"
      alt="Atelier de fabrication des chaises en chêne"
      width={1200}
      height={630}
      loading="eager"
    />
  )
}
width et height donnent au navigateur le ratio de l'image pour réserver sa place : pas de décalage de mise en page au chargement, ce qui protège le CLSCumulative Layout Shift. Mesure la stabilité visuelle de la page. Idéalement < 0,1., que Google veut sous 0,1.
Par défaut, next/image charge les images en différé. Bien pour le bas de page, mauvais pour le visuel du haut. Pour l'image qui forme le LCPLargest Contentful Paint. Mesure le temps de chargement du plus grand élément visible. Idéalement < 2,5 secondes., la documentation conseille loading="eager" ou fetchPriority="high". L'ancienne propriété priority est dépréciée depuis Next.js 16 au profit de preload, que la documentation réserve aux cas particuliers.
Le composant Link étend l'élément <a> : il produit un vrai lien avec son href, le seul que Google explore de manière fiable.
Une navigation déclenchée par router.push dans un onClick fonctionne pour le visiteur, mais Google ne peut pas en extraire l'URL de manière fiable. Gardez Link pour toute la navigation entre pages, puis organisez ces liens par thème avec le siloing SEO. Les liens que vous choisissez de ne pas exposer au robot, comme certaines combinaisons de filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO., relèvent d'une autre technique : l'obfuscation SEO.
Les redirections se déclarent dans next.config.ts :
// next.config.ts
import type { NextConfig } from 'next'

const nextConfig: NextConfig = {
  async redirects() {
    return [
      { source: '/ancien-blog/:slug', destination: '/blog/:slug', permanent: true },
    ]
  },
}

export default nextConfig
Avec permanent: true, Next.js renvoie un 308, et un 307 avec false. Les audits qui attendent un 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. n'ont pas à s'inquiéter : Google traite le 308 comme un 301, et le 307 comme un 302Redirection temporaire ne transférant pas le jus SEO. À utiliser avec précaution.. Choisissez une seule forme d'URL, avec ou sans slash final, et gardez-la partout : liens, canonical, sitemap. Pour un changement d'URL en masse, le guide des redirections SEO détaille le plan de redirection.

Migrer un site du Pages Router : la table de correspondance
Les deux routeurs cohabitent dans le même projet, ce qui permet de migrer gabarit par gabarit. Chaque gabarit migré doit ressortir avec le même HTML SEO : title, description, canonical, contenu, liens et codes HTTP.
| Pages Router | App Router | Vigilance SEO |
|---|---|---|
next/head |
metadata, generateMetadata |
Modèle de title et metadataBase dans le layout racine |
getStaticProps |
Server Component asynchrone, prérendu | Vérifier que la page reste statique au build |
getStaticPaths |
generateStaticParams |
Toutes les URL du sitemap prérendues ou rendues à la demande |
getStaticProps avec revalidate |
export const revalidate (modèle précédent), 'use cache' et cacheLife (Cache Components) |
Même fraîcheur qu'avant sur les prix et les stocks |
getServerSideProps |
Server Component avec données non mises en cache | Temps de réponse serveur à surveiller |
next-seo (<NextSeo />) |
API Metadata, composants JSON-LD de next-seo | Aucune balise perdue, aucune en double |
| Sitemap généré par script | app/sitemap.ts |
Mêmes URL, mêmes dates |
pages/api |
Route Handlers, app/api/.../route.ts |
Aucun effet SEO direct |
Un renommage de Next.js 16 s'ajoute, quel que soit le routeur : le fichier middleware.ts devient proxy.ts. C'est là que se vérifient les redirections et les 404 avant le rendu.
Entre une page servie par le Pages Router et une page servie par l'App Router, la navigation recharge la page entière, et next/link ne précharge pas d'un routeur à l'autre. Googlebot charge chaque URL séparément, ce détail joue donc sur l'expérience des visiteurs pendant la transition : migrez d'abord des ensembles cohérents, le blog entier plutôt qu'un article sur deux.
La recette tient en cinq gestes, à répéter pour chaque gabarit :
- Avant la migration, enregistrez le HTML brut de trois URL par gabarit avec
curl. - Après, comparez title, description, canonical, H1, liens internesEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. et JSON-LD.
- Testez les codes HTTP : une URL supprimée en 404, une URL déplacée en 308 vers sa cible.
- Contrôlez que chaque URL du nouveau sitemap répond en 200 sans redirection.
- Lancez l'inspection d'URL de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. sur un échantillon et lisez le HTML rendu.

Une migration de routeur change le HTML de toutes les pages en même temps : c'est une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. au sens SEO, avec son plan de recette. Slashr intervient en SEO aux côtés de l'agence ou de l'équipe qui développe le site Next.js, dans le cadre d'un accompagnement SEO de refonte et de migration. Pour un site Next.js déjà en ligne, l'audit du HTML rendu, des balises et des codes HTTP fait partie de notre accompagnement SEO.
Questions fréquentes
next-seo est-il encore utile avec l'App Router ?
Pour les balises title et meta, non : la documentation de next-seo renvoie elle-même vers generateMetadata. Sa version 7 propose surtout des composants JSON-LD typés, utiles si vous posez beaucoup de schémas. Sur un projet resté en Pages Router, ses anciens composants restent disponibles via next-seo/pages.
Next.js est-il bon pour le SEO ?
Oui, parce qu'il rend les pages en HTML sur le serveur par défaut, Client Components compris. Les problèmes viennent de choix précis : ssr: false sur du contenu, données chargées dans un useEffect, pages introuvables servies en 200 après le début du streaming. Un curl sur chaque gabarit repère les deux premiers. Pour le troisième, appelez une URL qui n'existe pas et lisez le code HTTP, qui doit être 404.
SSR ou SSG : lequel choisir pour le SEO avec Next.js ?
Les deux livrent un HTML complet au robot. La génération statique est plus rapide et convient aux contenus stables, le rendu à la requête aux pages qui dépendent du visiteur. Entre les deux, la régénération (cacheLife avec Cache Components, revalidate dans le modèle précédent) garde la vitesse du statique pour les fiches produit ou les articles qui changent de temps en temps.
Faut-il migrer vers l'App Router pour mieux ranker ?
Pas pour le seul SEO : un Pages Router bien rendu, avec getStaticProps et next/head, envoie déjà un HTML complet. L'App Router simplifie les métadonnées, le sitemap et le JSON-LD, et les nouveautés récentes, comme Cache Components, sont documentées pour l'App Router. Migrez quand le projet s'y prête, gabarit par gabarit, avec une recette SEO à chaque étape.
Sources
- Blog de Next.js, notes de version
- Getting Started: Server and Client Components, Next.js
- Guides: Lazy Loading, Next.js
- File-system conventions: loading.js, Next.js
- File-system conventions: not-found.js, Next.js
- How to migrate from Pages to the App Router, Next.js
- Functions: generateStaticParams, Next.js
- Guides: ISR, Next.js
- Functions: cookies, Next.js
- Getting Started: Caching, Next.js
- Getting Started: Metadata and OG images, Next.js
- Components: Head, Next.js
- Functions: generateMetadata, Next.js
- next.config.js: trailingSlash, Next.js
- Next.js, html-bots.ts (dépôt GitHub), github.com
- next.config.js: htmlLimitedBots, Next.js
- Metadata Files: sitemap.xml, Next.js
- Créer et envoyer un sitemap, Google Search Central
- Metadata Files: robots.txt, Next.js
- next.config.js: assetPrefix, Next.js
- Comprendre les bases du SEO JavaScript, Google Search Central
- Guides: JSON-LD, Next.js
- next-seo 7.3.0, notes de version, github.com
- next-seo, README, github.com
- Components: Image, Next.js
- Comprendre les signaux Web essentiels et les résultats de recherche Google, Google Search Central
- Components: Link, Next.js
- Bonnes pratiques de SEO concernant les liens pour Google, Google Search Central
- next.config.js: redirects, Next.js
- Codes d'état HTTP, erreurs réseau et DNS, Google Search Central
- next-seo 7.0.0, notes de version, github.com
- Message d'erreur : blocking-route, Next.js
- Route Segment Config, Next.js
- Functions: useSearchParams, Next.js
- Getting Started: Route Handlers, Next.js
- File-system conventions: proxy.js, Next.js
- Directives: use cache, Next.js