
Une paginationDivision du contenu en plusieurs pages numérotées. Nécessite une gestion SEO spécifique. SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. repose d'abord sur trois règles de Google : une URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. par page (?page=2), une canonique vers la page elle-même et un lien <a href> vers la suivante. Le modèle de liens dépend de votre liste : pages voisines si seuls les premiers éléments comptent, logarithmique si tous se valent.
Ce que la pagination change pour le SEO
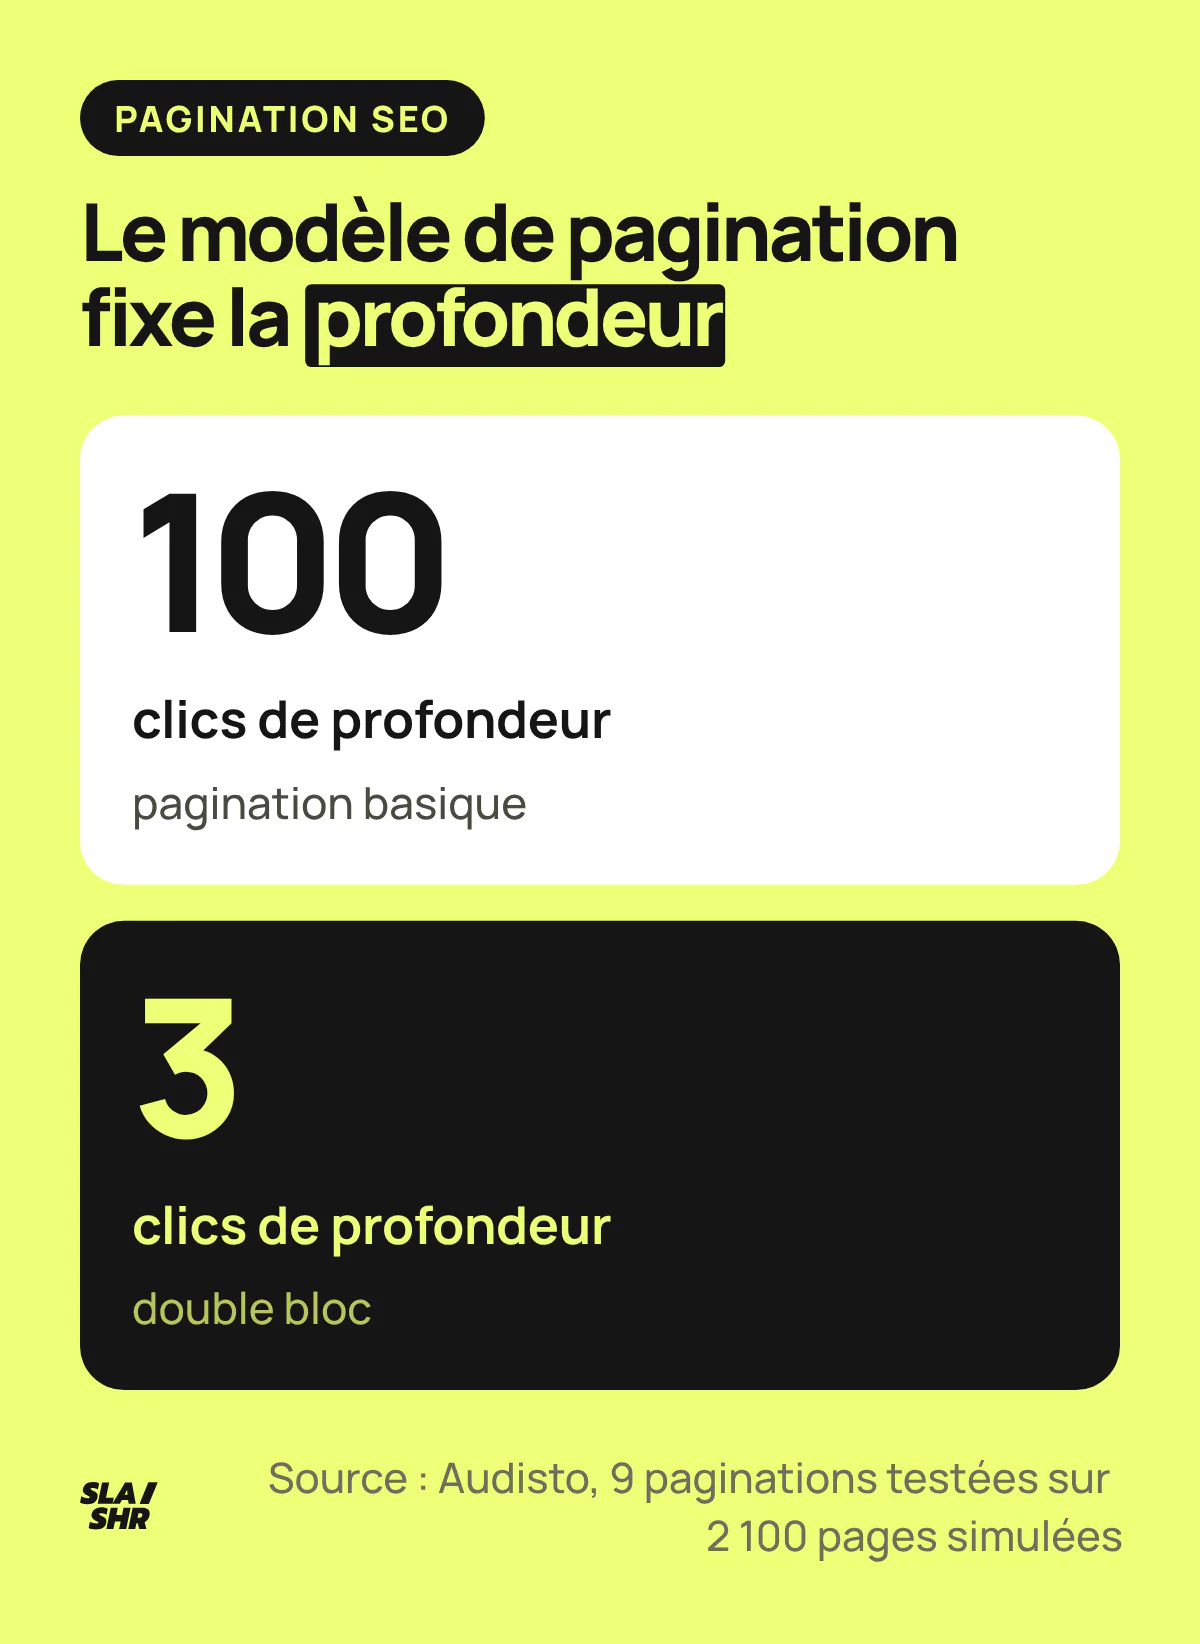
La pagination est le chemin par lequel Googlebot atteint les produits ou les articles qui ne tiennent pas sur la première page d'une liste. Une catégorie de 2 400 produits affichés par 24 compte 100 pages. Avec une pagination simple, la fiche la plus lointaine se trouve à 100 clics de la page 1 : c'est la profondeur que mesure Audisto pour une série de 100 pages.
Elle prolonge votre maillage interne. Elle donne accès aux pages profondes, les liens éditoriaux les poussent, et le guide du maillage interne SEO détaille comment choisir les pages hôtes et les ancresTexte cliquable d'un lien hypertexte. Doit être descriptif et pertinent.. Sur une catégorie qui sert de page de tête à un siloOrganisation du contenu en catégories thématiques étanches pour renforcer la pertinence.Architecture de contenu organisant les pages par thématiques avec un maillage interne optimisé., c'est aussi elle qui relie cette page à toutes ses fiches, la descente que décrit l'article sur la structure en silo et ses règles de liens.
Trois effets se règlent avec elle : la profondeur des pages listées, la part de PageRankAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne. interne qu'elles reçoivent et le nombre d'URL que Google doit explorer. Les deux premiers poussent à ouvrir la pagination, le troisième à la limiter. Tout l'arbitrage est là. Le même compromis se pose sur la navigation principale : l'article sur le mega menu montre quels liens laisser crawlables pour ne pas diluer le PageRank.

Ce que Google lit dans une pagination : URL, liens et canonical
Google traite chaque page d'une série paginée comme une page distincte. Sa documentation sur la pagination, mise à jour en décembre 2025, tient en six consignes :
- un lien
<a href>de chaque page vers la suivante, pour que GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. trouve la série ; - un lien de chaque page vers la première, conseillé pour marquer le début de la série ;
- une URL unique par page, par exemple avec un paramètre
?page=n; - une canonique propre à chaque page, la première page ne servant pas de canonique à la série ;
- aucun numéro de page dans un fragment
#: Google ignore ce qui suit le dièse et peut ne pas suivre le lien ; - des title et des meta descriptions qui peuvent rester identiques d'une page à l'autre, car Google reconnaît les pages d'une même séquence.
Concrètement, la page 2 d'une catégorie ressemble à ceci :
<!-- httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.exemple.fr/canapes?page=2 -->
<link rel="canonicalBalise indiquant la version principale d'une page en cas de contenu dupliqué ou similaire." href="https://www.exemple.fr/canapes?page=2">

<nav aria-label="Pagination">
  <a href="https://www.exemple.fr/canapes">1</a>
  <a href="https://www.exemple.fr/canapes?page=3">3</a>
  <a href="https://www.exemple.fr/canapes?page=3">Page suivante</a>
</nav>
Les balises <link rel="prev"> et <link rel="next"> ont longtemps servi à déclarer la série. Google a annoncé leur retrait le 21 mars 2019 et précise aujourd'hui qu'il ne les utilise plus, tout en notant que d'autres moteurs peuvent encore s'en servir. Les laisser ne coûte rien. Elles ne remplacent ni les liens ni les canoniques.
?page=2 ou /page/2 : quelle structure d'URL ?
Les deux formats fonctionnent, tant que chaque page a une URL stable qui s'ouvre sans JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. ni cookie. Google donne ?page=n en exemple. Trois détails comptent plus que le format :
- la page 1 garde l'URL de la catégorie : le lien « 1 » pointe vers
/canapes, jamais vers/canapes?page=1, qui en ferait un doublon ; - une page au-delà de la dernière renvoie une 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget., ce que Google recommandait déjà en 2014 dans ses conseils sur le scroll infini ;
- les tris et le nombre de produits par page restent hors de l'index : Google demande d'écarter ces variantes avec une balise noindexDirective indiquant aux moteurs de ne pas indexer une page. ou un motif d'URL bloqué dans le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. (noindex d'abord si elles sont déjà indexées, blocage une fois sorties de l'index).
Le texte de catégorie, lui, reste sur la page 1. Le répéter sur chaque page ne fait que dupliquer le même paragraphe dans toute la série. La page catégorie SEO reprend ces règles dans l'ordre où les régler sur un site e-commerce, avec les filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. et le texte.

Canonical vers la page 1, noindex, Disallow : les réglages qui cassent une pagination
Les erreurs qui coûtent le plus coupent l'accès aux pages profondes tout en ayant l'air propres.
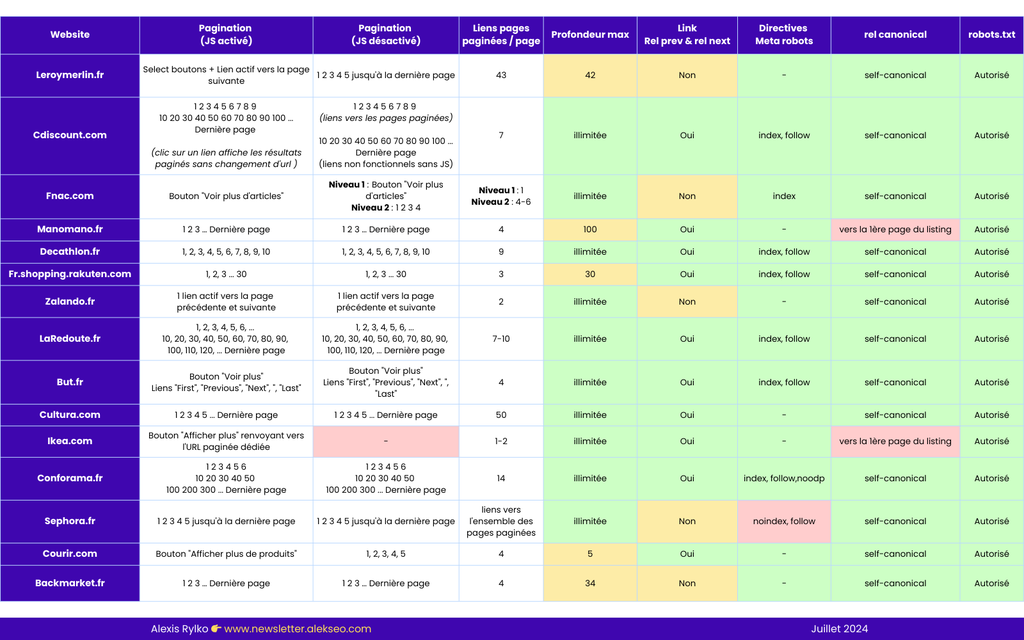
La canonique vers la page 1. Elle demande à Google de traiter la page 3 comme un doublon de la page 1, alors que leurs produits diffèrent. Google la déconseille explicitement, et le guide de la balise canonical rappelle son rôle : désigner la version principale de pages en doublon. Le relevé d'Alexis Rylko sur les grands e-commerçants français, en juillet 2024, la trouvait encore chez deux des quinze sites, Manomano et IKEA.
Le noindex sur les pages 2 et suivantes. La documentation de Google ne cite le noindex que pour les variantes de tri et de filtre, qui répètent la même liste dans un autre ordre. Une page 3 liste d'autres produits : laissez-la indexable, avec sa canonique vers elle-même. Pour les cas où un noindex se justifie vraiment, le guide pour désindexer une URL explique pourquoi il ne se combine jamais avec un blocage dans le robots.txt.
Le Disallow sur ?page= dans le robots.txt. Googlebot ne lit plus les pages bloquées, donc plus leurs liens. Les produits que seule la pagination relie ne se découvrent plus que par le sitemap XML, s'ils y figurent. Le sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. signale une URL sans lui donner de place dans votre maillage.
Le « Charger plus » sans URL. Les robots de Google ne cliquent pas sur les boutons. Les produits chargés au clic restent invisibles s'ils n'ont pas de page paginée derrière eux.

Neuf modèles de pagination comparés par Audisto
L'étude d'Audisto reste la comparaison la plus complète des modèles de pagination. Son protocole : 100 pages de liste de 20 produits, soit 2 000 fiches et 2 100 pages au total, simulées avec un générateur de paginations d'Audisto. Chaque modèle lie au minimum la page précédente, la suivante et la page 1, et chaque fiche lie la page 1.
Deux mesures comptent. La profondeur, c'est le nombre de clics depuis la page 1 pour atteindre la fiche la plus lointaine. Le second chiffre compte les pages dont le PageRank interne dépasse un seuil de 0,00001 %, qu'Audisto appelle « pertinentes pour le SEO ». C'est un calcul sur le graphe de liens du site, qui ne dit rien de l'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. réelle dans Google.
| Modèle | Liens en plus de précédente, suivante et page 1 | Profondeur des fiches | Pages de liste au-dessus du seuil | Fiches au-dessus du seuil |
|---|---|---|---|---|
| Basique | aucun | 100 | 4 | 60 |
| Premières pages | les cinq premières pages | 97 | 7 | 120 |
| Première et dernière | la dernière page | 51 | 7 | 100 |
| Voisines | cinq pages voisines | 21 | 19 | 260 |
| Première, dernière et voisines | la dernière page et cinq voisines | 12 | 32 | 360 |
| Paliers fixes | une page sur 20, et la dernière | 12 | 27 | 340 |
| Bloc fixe | le bloc de dix pages en cours (1 à 10, puis 11 à 20) | 20 | 20 | 220 |
| Logarithmique | dix paliers, serrés autour de la page en cours, larges vers les extrémités, et la dernière | 4 | 100 | 1 720 |
| Double bloc | le bloc fixe, plus un second bloc de dix pages calculé depuis la page en cours | 3 | 100 | 2 000 |
La part du PageRank captée par les fiches baisse quand la pagination s'ouvre : 49 % en pagination basique, 36 % avec le double bloc. Les pages de liste, plus liées entre elles, en gardent davantage. C'est surtout la répartition qui change. En basique, seules 64 pages sur 2 100 passent le seuil, toutes en tête de liste. Avec le double bloc, elles le passent toutes.

Le tableau ne montre pas où tombent les pages fortes. Avec un lien vers la dernière page, la fin de la liste gagne du poids. Avec les paliers fixes, il se répartit sur toute la série. Or une liste triée place ses meilleurs éléments en tête.
La pagination logarithmique, la plus efficace après le double bloc, ressemble à ceci sur la page 25 d'une série de 100 :

Choisir votre modèle : liste triée ou éléments d'égale valeur
Une question décide du modèle : tous les éléments de la liste se valent-ils, ou seuls les premiers comptent ? C'est la recommandation d'Audisto, et elle recoupe le relevé d'Alexis Rylko sur les médias. Le volume vient après.
Seuls les premiers comptent. Un média trie par date, et un article perd vite son potentiel. Une boutique trie souvent ses catégories pour mettre en tête ce qui se vend. Audisto recommande alors les liens vers les premières pages, les pages voisines ou le bloc fixe, qui concentrent le PageRank en tête de liste. Les grands médias vont plus loin : Le Monde, La Dépêche ou 20 Minutes ne proposent qu'un lien vers la page suivante, d'après le relevé de 2024. Rylko juge pourtant le potentiel des fiches e-commerce « beaucoup plus homogène » que celui d'un article de presse : une boutique dont les fiches rankent seules se rapproche du cas suivant.
Tous se valent. Un catalogue de pièces détachées ou de références techniques dont chaque fiche peut ranker seule. Audisto recommande ici la pagination logarithmique ou le double bloc, les deux seuls modèles qui font passer le seuil à 86 % ou à la totalité des fiches. Leurs limites sont du côté de l'utilisateur : les numéros de la logarithmique semblent tirés au hasard, et le double bloc se comprend mal au-delà du premier bloc. Les sites d'annonces font souvent le choix inverse, parce que leurs annonces n'ont pas toutes la qualité d'une fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées. : SeLoger, Bien'ici ou Pages Jaunes n'avaient pas de pagination indexable sans JavaScript en 2024, selon Rylko. La logarithmique ne sert que si chaque fiche mérite l'index.
Gardez ce second bloc lisible. Dans l'exemple réel qui a inspiré le modèle, un site d'actualité affichait ces numéros en gris très clair, presque invisibles. Google range dans l'abus de liens cachés tout lien placé uniquement pour manipuler les moteurs, sans être facilement visible des visiteurs.
Entre les deux, les grands catalogues e-commerce misent sur des paliers croissants, à ne pas confondre avec les paliers fixes du tableau. Cdiscount, Conforama et La Redoute affichaient en 2024 des liens 1, 2… 10, 20… 100, 200, qui rapprochent le milieu de la série.
Plafonner la pagination des catégories mères
Plusieurs grands e-commerçants limitent volontairement la profondeur : Leroy Merlin, Manomano, Rakuten, Courir et Backmarket, selon le même relevé. Audisto en donne une raison. Une catégorie mère liste tous les produits de ses sous-catégories, et c'est la pagination des sous-catégories qui rend vraiment les produits accessibles. Le nombre de niveaux à prévoir pour un catalogue se calcule en amont, avec la méthode de l'arborescence SEO, du choix des niveaux à la profondeur.
Prenons un exemple fictif : une catégorie mère de 4 800 produits affichés par 24, soit 200 pages, et douze sous-catégories de 400 produits, soit 17 pages chacune. Plafonner la mère à 10 pages ne coupe l'accès à aucun produit et retire 190 pages qui n'apportaient rien. Les URL retirées renvoient alors une 404, comme toute page hors série.
Alexis Rylko pose une question voisine pour les sites dont la visibilité vient des pages de liste plutôt que des fiches, avec l'exemple de Jules.com : vingt liens de pagination valent-ils mieux que des liens vers les catégories importantes ? Si vos filtres portent une partie de ce trafic, encore faut-il qu'ils soient des pages qui méritent l'index. La méthode pour choisir les filtres à facette à indexer part des recherches réelles et du nombre de produits.

Scroll infini et « Charger plus » : une surcouche sur de vraies pages
Le scroll infini et le bouton « Charger plus » se gardent pour l'utilisateur, à condition qu'une vraie pagination existe dessous. Google le dit clairement : ses robots explorent en général les URL des liens <a href>, ne cliquent pas sur les boutons et ne déclenchent pas le JavaScript qui attend une action de l'utilisateur.
Sa documentation actuelle sur le chargement différé donne la recette. Une URL stable et unique par tranche, par exemple ?page=12. Des liens d'une tranche à la suivante. Puis l'URL affichée mise à jour avec l'History API quand l'utilisateur descend.
Son billet de 2014 sur le scroll infini, que Google signale comme ancien, ajoute deux précautions toujours utiles : des pages accessibles sans JavaScript, et aucun élément affiché sur deux pages. En 2024, la Fnac doublait son bouton « Voir plus d'articles » de vrais liens : un bouton vers la page 2, puis quatre liens vers des pages plus profondes.
Google pointe aussi les limites côté utilisateur. Le scroll infini et le « Charger plus » mettent tous les résultats sur une seule page et ne tiennent pas un très grand nombre de résultats. Si votre site repose sur le rendu JavaScript, le guide JavaScript et SEO détaille ce que Googlebot voit vraiment.
La page « Tout afficher » est un cas à part. Google indiquait en 2011 qu'il la préférait aux pages découpées quand elle se charge vite, avec une canonique des pages de la série vers elle. Sa documentation actuelle n'en parle plus, et Audisto déconseille de cumuler les deux. Sur une catégorie de plusieurs centaines de produits, la page complète devient lourde : la pagination avec canonique auto-référente reste la voie réaliste.

Vérifier votre pagination : rendu sans JavaScript, profondeur et logs
Trois contrôles disent si votre pagination fait son travail.
La page sans JavaScript. Désactivez-le et rechargez une catégorie : les liens vers les pages suivantes doivent rester, avec de vraies URL. Le relevé de 2024 montre que la question se pose même chez les gros : L'Équipe et Le Point n'avaient aucune pagination dans leur version sans JavaScript.
La profondeur. Un crawler SEO mesure le nombre de clics entre la page d'accueil et chaque fiche. Repérez les fiches atteintes seulement par la pagination, et la profondeur des plus lointaines.
Les logsFichiers enregistrant toutes les requêtes reçues par un serveur, permettant d'analyser le comportement des bots.. Filtrez les passages de Googlebot sur les URL en ?page= : jusqu'à quelle page descend-il, et à quel rythme ? Alexis Rylko observe dans ses analyses de logs que le crawl de Google baisse nettement au-delà du quatrième ou du cinquième niveau de profondeur. Si vos pages profondes ne voient jamais Googlebot, rapprochez-les : paliers croissants, plafond sur les catégories mères, liens depuis les sous-catégories.
Pagination et filtres multiplient aussi les URL que Google connaît. L'article sur le budget de crawl montre comment repérer les familles d'URL qui consomment l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web.. Et si vous préférez un regard extérieur sur votre structure, Slashr, agence SEO basée à Lille, audite ce type de réglage.

Questions fréquentes
Google utilise-t-il encore rel="next" et rel="prev" pour la pagination ?
Non. Google a annoncé l'abandon de ces balises le 21 mars 2019, et sa documentation confirme qu'il ne les utilise plus. D'autres moteurs peuvent encore s'en servir : les garder ne gêne pas, à condition d'avoir aussi les liens <a href> entre les pages.
Faut-il mettre les pages paginées en noindex ?
Non. Google traite chaque page d'une série comme une page distincte, et sa documentation ne cite le noindex que pour les variantes de tri ou de filtre. Laissez les pages 2, 3 et suivantes indexables, chacune avec sa canonique vers elle-même.
Quelle canonical mettre sur une page paginée ?
Une canonique vers la page elle-même : ?page=3 pointe vers ?page=3. Google déconseille d'utiliser la première page comme canonique de la série, puisque les pages suivantes listent d'autres produits.
Les pages paginées doivent-elles avoir des title différents ?
Rien ne l'impose. Google indique que les pages d'une séquence paginée peuvent garder les mêmes title et meta descriptions, car il reconnaît la série. Ajouter « Page 2 » au title reste possible pour l'utilisateur.
Le scroll infini est-il mauvais pour le SEO ?
Seul, il pose problème : Googlebot ne fait pas défiler la page et ne clique pas pour charger la suite. Doublé de pages paginées reliées par des liens <a href>, avec une URL mise à jour au défilement, il fonctionne.
Sources
- Pagination, incremental page loading, and their impact on Google Search, Google Search Central
- Tweet de Google Search Central (ex-Google Webmasters) du 21 mars 2019, Google Search Central sur X : x.com/googlesearchc/status/1108726443251519489
- Infinite scroll search-friendly recommendations, Google Search Central Blog (13 février 2014)
- View-all in search results, Google Search Central Blog (15 septembre 2011)
- Spam policies for Google web search, Google Search Central
- The Ultimate Pagination SEO Guide, Audisto (Tobias Schwarz, Svenja Hintz) : audisto.com/guides/pagination/
- Quelle pagination pour un site e-commerce, média &Accelerated Mobile Pages. Framework Google pour créer des pages mobiles ultra-rapides (moins utilisé aujourd'hui).; classified ?, Alexis Rylko, newsletter SEO, Data & Growth, juillet 2024 : newsletter.alekseo.com/p/5-quelle-pagination-pour-un-site
- Fix lazy-loaded content, Google Search Central