




On vous vend une équation simple : plus de données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets., plus de citations dans ChatGPTAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses.. C'est faux, et le malentendu coûte cher en heures de dev.
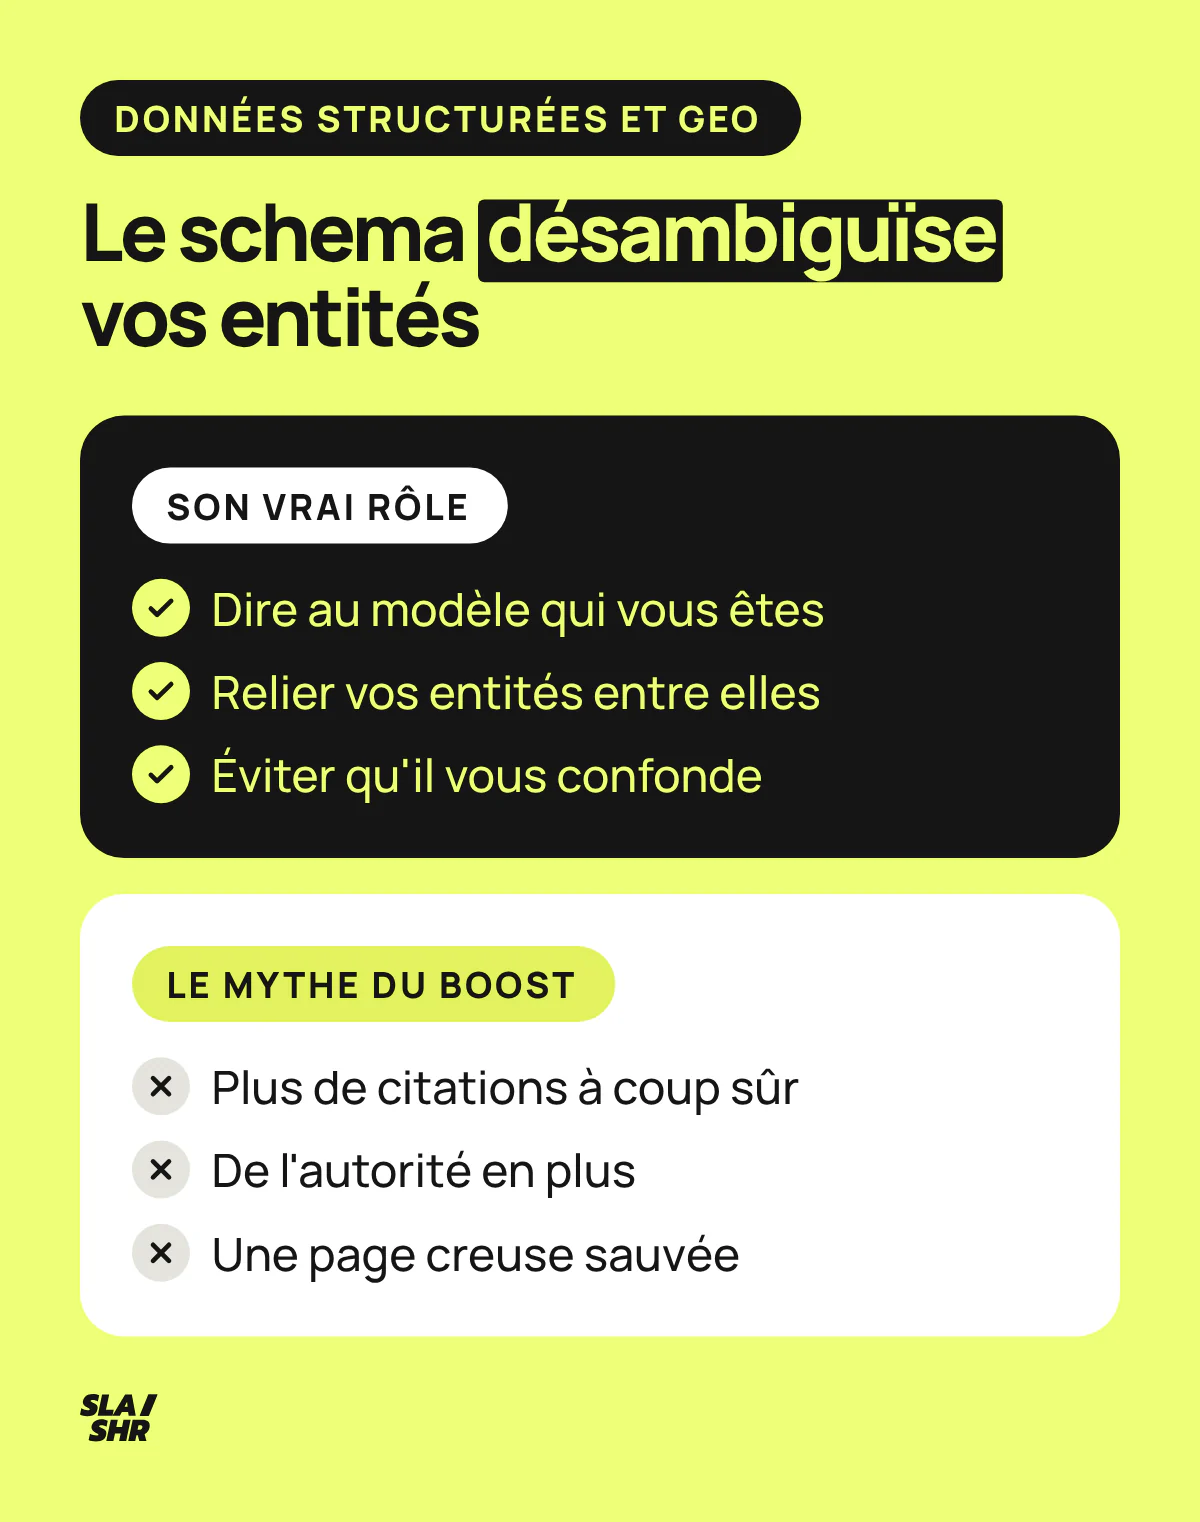
Les données structurées aident votre GEOGenerative Engine Optimization. Optimisation pour apparaître dans les réponses des IA génératives., oui. Mais pas comme un bouton qui multiplie vos citations. Elles servent à désambiguïser : dire à un modèle qui vous êtes, de quoi parle cette page, comment vos entités se relient entre elles. Le schema ne pousse pas votre page vers le haut d'une réponse IA. Il évite que le modèle se trompe sur vous, ou pire, qu'il vous ignore parce qu'il ne sait pas où vous ranger.
Le schema désambiguïse vos entités, il ne vous donne pas de boost. Partez de ce cadrage et vous déployez trois markups qui comptent au lieu d'en coller quarante au hasard. Partez du mythe du boost et vous facturez du balisage à votre client pour mesurer zéro effet six mois plus tard.
Voyons ce qui marche page par page, et comment vérifier que votre taux de citationMention du NAP d'une entreprise sur des annuaires ou sites tiers. bouge vraiment.
GEO veut dire Generative Engine Optimization, pas géographie

Première confusion à lever, parce que la SERPSearch Engine Results Page. Page affichée par un moteur de recherche en réponse à une requête utilisateur. est un champ de mines sur ce mot. « GEO » a deux vies. Côté SIG et cartographie, geo renvoie aux données géographiques : coordonnées, GeoJSON, formats spatiaux. Côté search, et c'est notre terrain, GEO veut dire Generative Engine Optimization : optimiser votre prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.ésence dans les moteurs génératifs, ChatGPT Search, PerplexityMoteur de recherche conversationnel basé sur l'IA, concurrent émergent de Google., GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche., les AI Overviews de Google.
Les deux se croisent sur un point précis. Quand un modèle doit répondre à une requête locale du type « meilleur ostéopathe à Lille », vos données géographiques structurées redeviennent un signal GEO. On y revient plus bas. Mais pour la grande majorité des sites, GEO ici veut dire une chose : comment me faire citer par une IA. Pas comment publier une couche cartographique.
Le schema désambiguïse, il ne booste pas

Ce qu'on sait, posément. Google a répété que ses systèmes, y compris ceux qui alimentent les AI Overviews, s'appuient sur la compréhension du contenu, et que les données structurées aident à interpréter une page. Pas de promesse de classement, juste de la compréhension. Côté Perplexity et ChatGPT Search, on observe qu'ils crawlent le HTML, parsent le JSON-LDFormat recommandé par Google pour implémenter les données structurées dans le code source. quand il est propre et s'en servent pour extraire des attributs nets : un prix, un auteur, une date, une note. Le markup leur épargne du travail d'inférence.
Ce qu'on ignore, et il faut l'assumer : le poids exact du schema dans la décision de citer une source. Personne ne le connaît, ni nous ni les éditeurs des modèles. On ne sait pas non plus quels types sont prioritaires d'un moteur à l'autre, et ça change à chaque release.
Ce qui reste vrai dans le flou : un modèle cite plus volontiers une source qu'il a comprise sans ambiguïté. Le schema sert exactement à ça. Quand votre Organization est relié à votre Wikidata, quand votre article pointe vers un auteur identifié, quand votre produit est rattaché à une marque-entité, vous réduisez le risque que le modèle vous confonde, vous attribue mal une info ou vous zappe.
La plupart des articles sur le sujet vous promettent un gain de citations chiffré dès que vous collez du FAQPage. C'est du vent. Le schema ne crée pas d'autorité. Il évite que votre autorité existante se perde dans le bruit.
Quelles données structurées déployer selon le type de page

Pas de balisage uniforme. La priorité dépend de ce que la page porte comme entité, et le classement n'est pas celui qu'on lit partout.
Page organisation, le markup le plus sous-estimé
Commencez ici, pas par vos pages produit. Le markup Organization sur votre home et votre page « à propos » est la pierre angulaire de votre désambiguïsation. Les champs qui comptent : name, logo, urlUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. et surtout sameAs pointant vers votre Wikidata, votre page Wikipédia si vous en avez une, votre LinkedIn, votre profil Crunchbase. Le sameAs, c'est vous qui dites au modèle que cette entité est la même que celle du Knowledge GraphBase de connaissances de Google affichant des informations structurées sur des entités (personnes, entreprises, lieux).. Ajoutez founder en le reliant à un Person lui-même doté de sameAs. Vous construisez un graphe d'entités, pas une fiche. C'est ce graphe que les moteurs génératifs consolident pour décider si vous êtes une source fiable sur votre sujet.
Fiche produit, relier au-delà du prix
Product plus Offer (prix, devise, disponibilité), c'est le minimum sur une fiche produit. Le GEO se gagne en reliant le produit à brand (la marque comme entité, pas comme texte), à un AggregateRating cohérent avec les avis réellement affichés et à un gtin qui ancreTexte cliquable d'un lien hypertexte. Doit être descriptif et pertinent. le produit dans les bases globales. Quand ChatGPT Search compare trois produits pour répondre à un utilisateur, il a besoin d'attributs nets. Un Offer propre lui sert un prix exploitable. Un balisage absent l'oblige à deviner, et il devine souvent mal, ou il prend la donnée d'un comparateur à votre place.
La fiche locale, là où le géographique compte vraiment
C'est le seul cas où données structurées et données géographiques se rejoignent pour de bon. Sur une page établissement : LocalBusiness avec le sous-type le plus précis (Dentist, Restaurant, Store), plus address, geo (latitude, longitude), openingHours et areaServed. Les propriétés de schema.org/Place existent précisément pour décrire un lieu de façon non ambiguë. Pour une requête locale traitée par une IA, ces champs rattachent votre établissement à une zone géographique et à un type de service. Sans eux, le modèle se rabat sur Google Business ProfileFiche d'établissement Google affichant les informations locales d'une entreprise. et les annuaires, et vous disparaissez de l'équation.
L'auteur traité comme une entité
Sur un contenu éditorial : Article ou NewsArticle, avec author relié à un Person identifié, datePublished et publisher pointant vers votre Organization. Côté GEO, l'enjeu c'est l'authorship, pas le rich result. Un modèle qui doit juger la fiabilité d'une analyse veut savoir qui l'a écrite. Un auteur balisé, doté d'un sameAs vers ses profils et ses autres publications, devient une entité réutilisable. C'est ce que certains appellent l'AuthorClaim : revendiquer explicitement la paternité d'un contenu pour que la machine la propage.
FAQPage et HowTo, utiles sans être magiques
FAQPage reste pertinent parce que le format question-réponse colle à ce que les modèles extraient pour répondre. HowTo aussi, sur un vrai tutoriel. Mais gardez la tête froide : Google a restreint l'affichage des rich results FAQ dans ses SERP classiques, et ça ne préjuge pas de leur lecture par les moteurs génératifs. Balisez-les si la page s'y prête vraiment. N'inventez pas une FAQPage bidon juste pour cocher la case : les modèles repèrent le contenu plaqué aussi bien que Google.
| Type de page | Markup prioritaire | Ce qu'il désambiguïse |
|---|---|---|
| Home et à propos | Organization + sameAs | votre identité de marque |
| Fiche produitPage dédiée à un produit, devant être optimisée avec description unique, images et données structurées. | Product + Offer + brand | prix, marque, attributs |
| Page locale | LocalBusiness + Place geo | lieu et zone desservie |
| Article | Article + author Person | qui écrit, autorité |
| Tutoriel et FAQ | HowTo et FAQPage | format Q/R extractible |
Ce que le schema ne fera jamais pour vous

Sans contenu, pas de citation. Si votre page n'a rien à dire qu'une IA voudrait reprendre, le balisage le plus propre du monde n'y changera rien. Le schema rend lisible ce qui existe, il ne crée pas de valeur. Coller du markup sur une page creuse, c'est mettre une étiquette soignée sur une boîte vide. Le modèle lit l'étiquette, ouvre la boîte et passe à la source suivante.
JSON-LD, et rien d'autre

Le débat JSON-LD contre microdata contre RDFa est tranché depuis longtemps, mais on le ressort à chaque audit GEO. Google recommande le JSON-LD, et les moteurs génératifs le parsent sans peine parce qu'il est isolé du HTML visible, dans un bloc script. Microdata et RDFa entremêlent le balisage aux balises HTML : plus fragile, plus pénible à maintenir, et ça casse au premier changement de template.
| Format | Verdict | Pourquoi |
|---|---|---|
| JSON-LD | À utiliser | Découplé du HTML, recommandé par Google, simple à injecter |
| Microdata | À éviter | Couplé au markup visible, fragile |
| RDFa | À éviter | Verbeux, hérité, peu d'intérêt aujourd'hui |
Côté technique : vous injectez votre JSON-LD dans le template, pas à la main page par page. Une variable par type d'entité, alimentée par les données du CMS, plus un test de non-régression. Le balisage écrit en dur finit toujours désynchronisé du contenu réel, et un schema qui ment au modèle est pire qu'un schema absent.
Mesurer l'effet réel, avant de le facturer

Ce qui sépare un déploiement schema sérieux d'un acte de foi, c'est la mesure avant et après. Tant que vous ne mesurez pas, vous balisez à l'aveugle et vous n'avez aucun moyen de dire à votre client si quelque chose a bougé.
Le panel de prompts, votre seule vérité terrain
Vous construisez un panel de prompts représentatifs de votre catégorie, ceux que vos clients tapent vraiment dans ChatGPT ou Perplexity : « meilleur logiciel de X pour PME », « comparatif Y », « quelle solution pour Z ». Une trentaine suffit pour commencer, à condition qu'ils couvrent votre intentObjectif réel de l'utilisateur derrière sa requête : informationnelle, navigationnelle, transactionnelle ou commerciale. réel et pas vos fantasmes de positionnementPosition d'une page web dans les résultats de recherche pour une requête donnée.. Vous mesurez une baseline : sur ces prompts, combien de fois votre marque est citée, dans quel contexte, à quelle position dans la réponse.
Avant, après, et ce que ça révèle vraiment
Vous déployez le schema. Vous attendez le recrawl, comptez quatre à huit semaines selon la fréquence de passage des bots, parce qu'un modèle ne voit pas votre nouveau JSON-LD le lendemain. Puis vous remesurez le même panel, dans les mêmes conditions.
On a construit Janus pour ça, notre outil de visibilité LLMLarge Language Model. Modèles d'IA comme GPT ou Gemini capables de générer du texte. : un panel de prompts suivi dans le temps, le taux de citation par moteur et la comparaison avant/après un changement. C'est la seule façon honnête de dire « ce déploiement schema a fait passer votre taux de citation de X à Y sur ce jeu de requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. », ou au contraire « aucun effet mesurable, le problème est ailleurs ».
Et c'est souvent ce que la mesure révèle. Le schema n'était pas le frein. Le frein, c'était un contenu non citable, une entité de marque inexistante dans le Knowledge Graph, ou un site que les bots des moteurs génératifs ne crawlent même pas correctement. Vous pouvez mesurer ça. Vous ne pouvez pas le deviner.
Questions fréquentes
Faut-il baliser toutes les pages d'un site ?
Non, et viser l'exhaustivité est une perte de temps. Priorisez les pages qui portent une entité ou une transaction : home, à propos, fiches produit, pages locales, contenus signés. Une page de mentions légales ou un panier n'ont aucun intérêt à être balisés. Le schema suit la valeur, pas le compteur de pages.
GeoJSON ou schema.org pour décrire un lieu ?
Ça dépend de l'usage. GeoJSON sert à alimenter une carte, une appli, une API cartographique : c'est de la donnée géographique pure. Pour le GEO et le SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche., c'est schema.orgVocabulaire standardisé de balisage structuré reconnu par Google, Bing et Yahoo./Place et ses propriétés geo qui parlent aux moteurs. Les deux ne s'excluent pas : GeoJSON pour votre rendu cartographique, schema pour la lecture par les moteurs.
Le schema agit-il pareil sur les AI Overviews et sur ChatGPT ?
Probablement pas, et personne n'a la table de correspondance exacte. Les AI Overviews s'appuient sur l'infrastructure de compréhension de Google, déjà friande de schema. ChatGPT Search et Perplexity parsent votre JSON-LD au crawlProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. mais pondèrent à leur façon. D'où l'intérêt de mesurer moteur par moteur plutôt que de supposer un comportement uniforme.