




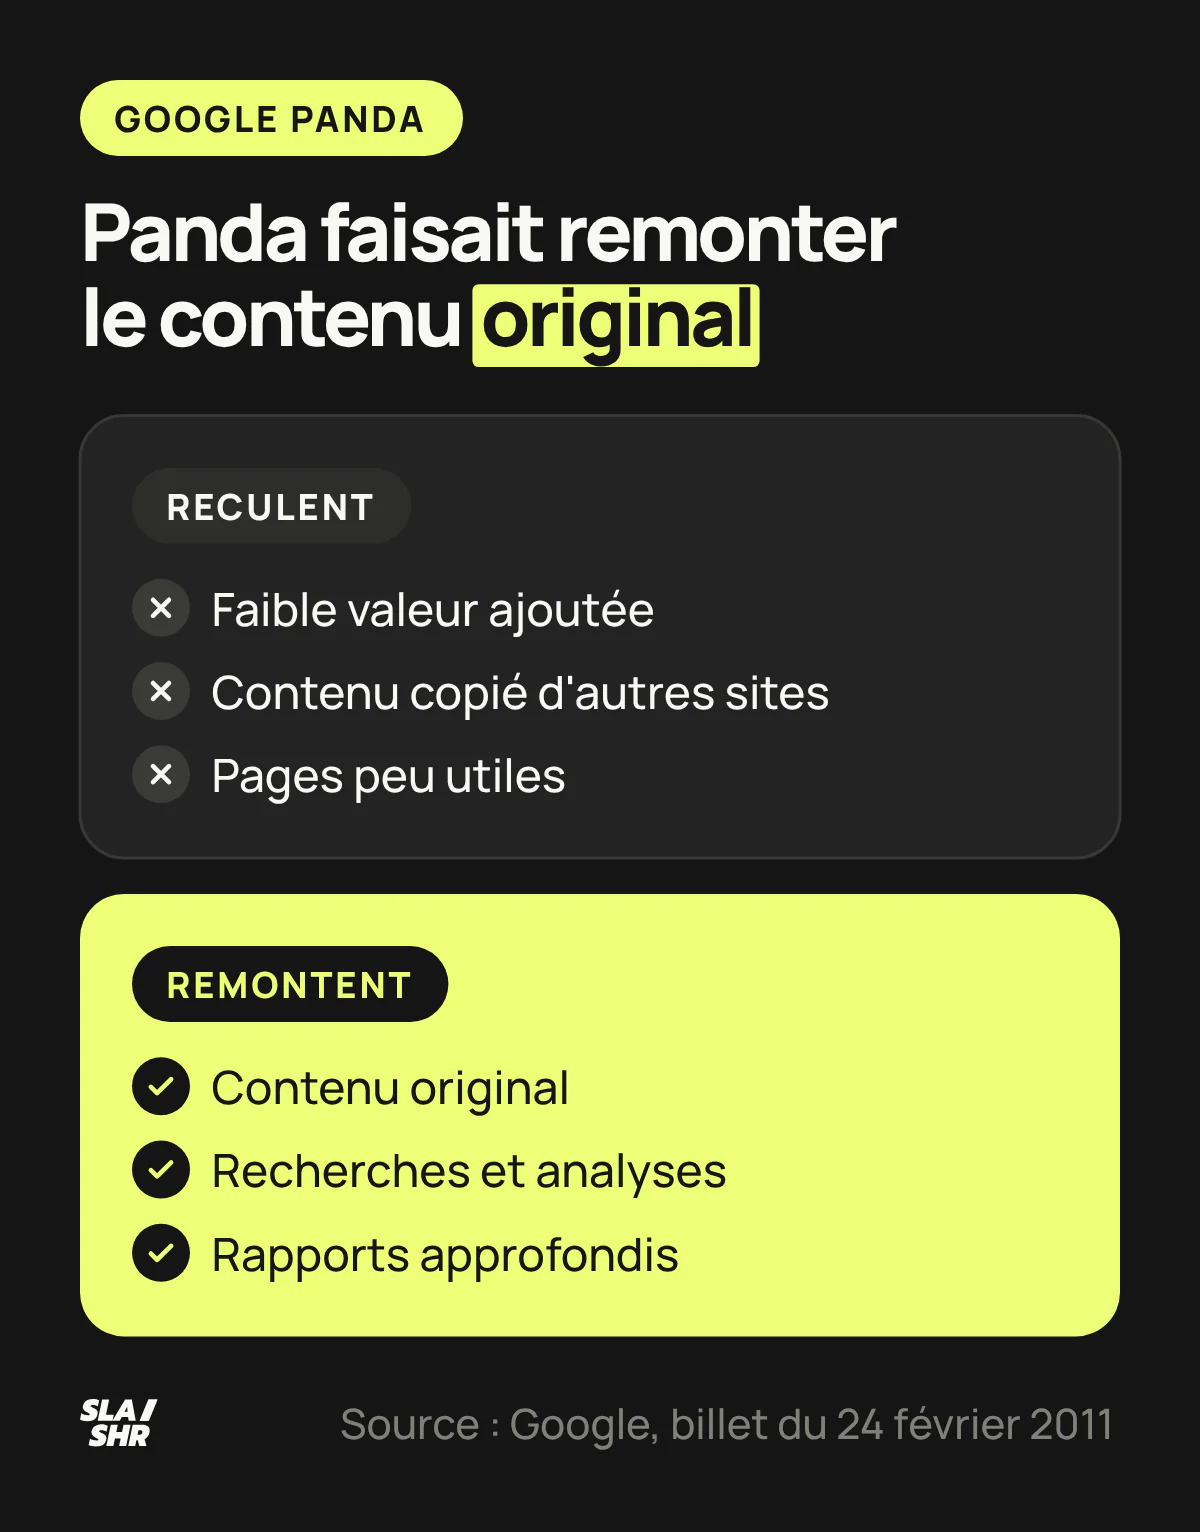
Google PandaMise à jour Google (2011) ciblant les sites avec contenu de faible qualité ou dupliqué. est un système de classementPosition d'une page web dans les résultats de recherche pour une requête donnée. annoncé par Google le 24 février 2011, lancé aux États-Unis pour faire reculer les sites de faible qualité (contenu copié, peu utile, sans valeur ajoutée) et mieux classer les sites au contenu original. Il a évolué et fait partie des systèmes de classement principaux de Google depuis 2015 : il n'existe plus comme filtre à part.
Pour un site qui perd du trafic aujourd'hui, la question utile devient : la baisse coïncide-t-elle avec une mise à jour principale, et quelles sections du site la portent ? Voici ce que Panda visait selon les annonces de Google, ce qu'il en reste en 2026 et la méthode pour auditer un site sur ces critères.
Ce que Google Panda visait en 2011
Panda faisait reculer les sites de faible qualité et remonter ceux qui publiaient un contenu original. Le billet de Google du 24 février 2011, signé Amit Singhal et Matt Cutts, décrit les deux côtés : baisser le classement des sites « low-value add for users », qui copient le contenu d'autres sites ou qui ne sont « just not very useful », et mieux classer les sites au contenu original, avec « research, in-depth reports, thoughtful analysis ». Le changement touchait de façon visible 11,8 % des requêtes. Aux États-Unis seulement, au départ.
Le nom ne figure pas dans ce premier billet. Google le reprend ensuite, et son guide des systèmes de classement parle aujourd'hui d'un système « surnommé "panda" », conçu pour garantir l'affichage de contenus de haute qualité et originaux.
Deux traits du système comptent encore pour un audit. Le premier : il jugeait la qualité à l'échelle du site. En mai 2011, Google écrit que du contenu de faible qualité sur certaines parties d'un site peut affecter le classement du site entier.
Le second : il visait un mode de production. Parmi les questions publiées la même année, l'une demande si le contenu est produit en masse ou sous-traité à un grand nombre de créateurs, au point que chaque page reçoit peu de soin ; une autre, si les sujets suivent l'intérêt réel des lecteurs ou si le site devine ce qui pourrait ranker. C'est le portrait des fermes de contenu, ces sites qui publient en volume des articles calés sur des requêtes.

Historique de Google Panda, de 2011 à 2024
Panda a vécu quatre ans comme système distinct, de son lancement américain en février 2011 à son intégration dans les systèmes principaux en 2015. Les jalons publiés par Google :
- 24 février 2011 : annonce du lancement aux États-Unis, 11,8 % des requêtes touchées de façon visible.
- 11 avril 2011 : déploiement auprès de tous les utilisateurs anglophones de Google. Google ajoute des signaux tirés des retours des internautes, dont, dans certaines situations de haute confiance, les sites qu'ils bloquent. Environ 2 % des requêtes américaines bougent en plus.
- 6 mai 2011 : Google publie 23 questions pour juger la qualité d'une page ou d'un article, et ses conseils aux sites touchés.
- 12 août 2011 : extension à toutes les langues sauf le chinois, le japonais et le coréen, donc au français. Le changement touche en général 6 à 9 % des requêtes dans la plupart des langues.
- 2015 : selon le guide de Google, Panda a évolué et s'est intégré à ses systèmes de classement principaux.
- 1er août 2019 : Google actualise les questions de 2011 dans son billet sur les mises à jour principales. Elles vivent aujourd'hui dans sa page sur les contenus utiles.
- Mars 2024 : le système de contenu utile, annoncé en 2022 sous le nom de Helpful Content Update, fait à son tour partie des systèmes principaux.

Le guide range aujourd'hui Panda parmi les systèmes « obsolètes », qui « ne sont plus utilisés » parce qu'ils ont été intégrés à des systèmes ultérieurs ou aux systèmes principaux. Ses critères de qualité, eux, vivent dans les systèmes principaux, que Google remanie à chaque mise à jour principale, plusieurs fois par an, et annonce dans sa liste des mises à jour du classement. Il n'y a donc plus de « mise à jour Panda » à attendre ni à redouter. Penguin a suivi le même chemin contre le spam de liens, une trajectoire que retrace l'histoire de Google et de ses grandes mises à jour.
Pénalité Google Panda : un déclassement sans message
Panda n'a jamais envoyé de notification : c'est un système automatique, qui déclasse sans prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.évenir et sans demande de réexamen. Google l'écrivait dès avril 2011 : aucune exception manuelle, et le classement algorithmique se met à jour à mesure que le site change. La sortie passe donc par l'amélioration du site, puis par l'attente d'une réévaluation.
Ce qui s'affiche dans la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche. relève d'un autre mécanisme : l'action manuellePénalité appliquée manuellement par un employé Google pour violation des guidelines.. Un examinateur de Google constate que des pages enfreignent les règles sur le spamTechniques manipulatrices visant à tromper les moteurs de recherche., et le rapport « Actions manuelles » le signale. Celle qui ressemble le plus à Panda s'intitule « Contenu pauvrePages avec peu de contenu ou de valeur ajoutée, pénalisées par Google. qui ne présente que peu ou pas d'intérêt ». Google y range les pages de site affilié sans valeur ajoutée, le contenu repris d'autres sources et les pages satellites.
Elle, au moins, se lève : vous corrigez les pages, puis vous envoyez une demande de réexamen. Le diagnostic complet, action manuelle contre déclassement algorithmique, est détaillé dans notre guide du black hat SEO et des sanctions Google.

Reste le contenu dupliqué, souvent mis sur le dos de Panda. Google écrit que le contenu en doubleContenu identique ou très similaire accessible via plusieurs URLs. Peut diluer le ranking. sur un site « est normal et n'enfreint pas » ses règles sur le spam : une version HTTP et une version HTTPSProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014., ou une version de démonstration restée accessible, créent des doublons sans sanction. Ils brouillent le choix de la page à montrer, et pour les vrais doublons la balise canonical indique à Google la version à retenir. Republier le contenu d'autres sites sans valeur ajoutée relève en revanche du scraping, que les règles sur le spam interdisent.
Côté conséquences, Panda déclassait. Des pages ou un site entier reculaient dans les résultats, et le trafic suivait. Aucune des annonces de Google sur Panda ne parle de désindexation.
Temps passé, rebond, E-A-T : ce que Google n'a jamais dit de Panda
Google n'a publié aucune liste des signaux de Panda, hors les sites bloqués par les internautes. Et aucune source de Google ne fait du temps passé, du taux de rebondPourcentage de visiteurs quittant un site après avoir vu une seule page. ou des partages sociaux des signaux décisifs. En mai 2011, il l'écrit sans détour : il ne divulgue pas les signaux de classement réellement utilisés par ses algorithmesProgramme informatique utilisé par les moteurs de recherche pour classer les pages web. Google utilise plus de 200 facteurs de ranking., pour éviter qu'on manipule ses résultats. Une version précédente de cet article affirmait le contraire. Elle avait tort. La seule donnée de comportement que Google nomme pour Panda, ce sont les sites bloqués par les internautes, intégrés en avril 2011 dans certaines situations de haute confiance.
Les clics, Google les compte ailleurs : notre article sur NavBoost et les données de clics montre ce que le procès antitrust et la fuite de 2024 établissent, des clics comptés par requête et par document, et ce qu'ils n'établissent pas. Dans la documentation qui a fuité, NavBoost ne parle de durée qu'à travers des clics « longs », jamais définis, et les champs « dwells » d'un autre module concernent le Knowledge PanelBase de connaissances de Google affichant des informations structurées sur des entités (personnes, entreprises, lieux)., les réponses web et les résultats locaux. Aucun champ décrit ne mesure le temps passé ni le scroll dans une page de votre site.
Deux autres idées reçues viennent des anciens articles sur Panda :
- Publier ou mettre à jour souvent. Google range parmi les signes d'un contenu écrit pour les moteurs le fait de changer la date des pages sans modification significative, ou d'ajouter et supprimer beaucoup de contenus pour paraître « plus actuel », et précise : « Cette technique ne fonctionne pas. » Il écrit aussi qu'il ne préfère aucun nombre de mots.
- L'E-A-T comme score. Le concept est devenu E-E-A-TExperience, Expertise, Authoritativeness, Trustworthiness. Critères de qualité évalués par Google. le 15 décembre 2022, avec l'ajout de l'expérience. Google précise que le modèle E-E-A-T « ne consiste pas en un facteur de classement spécifique » : ses systèmes combinent de nombreux facteurs pour repérer les contenus fiables. Notre guide de l'EEAT en SEO détaille où ses évaluateurs cherchent les preuves.

Panda et le contenu produit en masse : la même règle en 2026
La question de 2011 sur le contenu produit en masse a aujourd'hui sa règle anti-spam. Depuis mars 2024, Google désigne comme utilisation abusive de contenus à grande échelle le fait de générer de nombreuses pages dans le but principal de manipuler le classement, avec peu ou pas d'intérêt pour les utilisateurs, « quelle que soit la façon dont ils sont créés ». L'IA générative y figure, à côté du détournement de flux et des transformations automatiques par synonymes ou traduction.
Panda traitait ce modèle comme un défaut de qualité. La règle de 2024, qui s'appuie sur l'ancienne règle anti-spam sur le contenu généré automatiquement, l'étend au contenu produit en masse pour manipuler le classement, par des humains comme par des machines, et en fait du spam passible d'une action manuelle. Pour un site qui produit avec l'IA, le critère reste celui de 2011 : chaque page apporte-t-elle quelque chose que les pages déjà classées n'apportent pas ? Un texte rédigé avec l'IA, relu et utile, reste dans les règles ; mille fiches générées sans valeur ajoutée tombent sous la règle du contenu à grande échelle.

Auditer un site sur les critères de Panda
Un audit « Panda » date la baisse, trouve les sections qui la portent, puis tranche page par page. Les étapes, dans l'ordre :
1. Dater la baisse
Relevez dans la Search Console le jour où les clics et les positions décrochent, puis comparez-le aux dates de début et de fin des mises à jour principales publiées sur le tableau de bord d'état de la recherche Google. Google conseille d'attendre au moins une semaine complète après la fin du déploiement, puis de comparer cette semaine à celle qui précède le début de la mise à jour. Pas de mise à jour à cette date ? Cherchez d'abord une autre cause : migration, erreur d'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats., saisonnalité.
2. Mesurer l'ampleur
Google donne lui-même l'échelle. Une page passée de la 2e à la 4e position ne demande pas de mesures drastiques, et il déconseille de toucher à un contenu qui fonctionne déjà bien. Une page passée de la 4e à la 29e position mérite une évaluation approfondie. Regardez aussi séparément la recherche Web, Images, Vidéo et Actualités : la baisse peut ne toucher qu'un type de recherche.
3. Découper par section
Panda jugeait le site entier à partir de ses parties faibles, et l'audit suit la même logique, par répertoire. Dans le rapport Performances, filtrez les pages par « URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. contenant » un répertoire (/blog/, /produits/), ou par expression régulière pour regrouper plusieurs répertoires, puis comparez deux périodes avec une précision à la semaine ou au mois.
Prenons un site e-commerce fictif de 3 000 URL indexées : 1 200 fiches produits, 150 catégories, 400 articles de blog et 1 250 pages de résultats de recherche interne ouvertes à l'indexation. Si la baisse se concentre sur ces 1 250 pages, presque identiques entre elles, le problème est circonscrit avant même de lire une page. Un searchdexing laissé en roue libre produit exactement ce profil.
Le cas inverse est le plus propre à Panda : la section faible fait baisser tout le site. La baisse apparaît alors sur les fiches et les catégories, et les 1 250 pages de recherche interne, qui ramenaient peu de clics, n'ont presque rien à perdre.
Comparez donc, par répertoire, le poids dans l'index et les clics. Le rapport sur l'indexation des pages se filtre par sitemapFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche. : avec un sitemap par section, vous lisez le nombre de pages indexées de chacune. Les pages qui ne figurent dans aucun sitemap, comme la recherche interne ou les filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO., se lisent avec le filtre « Pages non envoyées uniquement ». Lisez d'abord la section qui pèse lourd dans l'index sans rapporter de clics. Pour une section dont les pages restent hors de l'index, le motif affiché par la Search Console oriente la suite : notre guide pour améliorer l'indexation de votre site dit quoi faire selon le motif.

4. Lire les pages avec les questions de Google
Lisez ensuite un échantillon de pages de la section en cause avec les questions d'auto-évaluation de Google : ce sont, actualisées en 2019, celles qu'il publiait en mai 2011 pour Panda. Chacune pointe vers une décision.
| Question de Google | Ce que vous vérifiez | Décision probable |
|---|---|---|
| Le contenu fournit-il des informations ou une analyse vraiment originales ? | Une donnée, un test ou un avis absents des pages déjà classées | Améliorer |
| Le site a-t-il des articles redondants sur le même sujet, avec de légères variantes de mots-clésTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. ? (2011) | Deux pages qui visent la même intention | Fusionner |
| Le contenu s'appuie-t-il sur d'autres sources en les recopiant ou en les reformulant ? | Fiches fournisseur ou articles concurrents paraphrasés | Améliorer (réécrire) |
| Le contenu est-il produit en masse ou sous-traité, au point de manquer de soin ? | Pages sur gabarit, interchangeables d'une URL à l'autre | Améliorer ou sortir de l'index |
| La page a-t-elle trop de publicités qui gênent le contenu principal ? (2011) | Encarts qui repoussent la réponse sous la ligne de flottaison | Alléger |
La deuxième question recoupe la cannibalisation SEO : deux pages sur une seule intention se tranchent par le recouvrement de leurs top 10, avant toute fusion.
5. Décider, puis attendre
Google donne l'ordre des décisions : améliorer d'abord. Supprimer un contenu est un dernier recours, à envisager seulement s'il ne peut pas être amélioré. En 2011, il citait déjà les issues possibles : supprimer les pages faibles, fusionner ou enrichir les pages superficielles, ou les déplacer sur un autre domaine.
Améliorer veut dire ajouter ce qui manque : un test chiffré, une photo du produit en usage, une démonstration filmée et pensée pour le référencement vidéo. Une page qui double une autre page sur la même intention se fusionne avec elle, par une redirection 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle..
Une page qui sert la navigation sans répondre à une recherche (filtre, recherche interne) sort de l'index par un noindexDirective indiquant aux moteurs de ne pas indexer une page. en restant explorable ; pour tout un espace d'URL comme la recherche interne, le Disallow vient une fois les pages sorties de l'index. Une page sans demande ni utilité répond 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. ou 410 : vidée mais laissée en 200, elle risque d'être classée en soft 404, que Google continue d'explorer. La marche à suivre est dans notre guide pour désindexer une URL de Google.

Comptez ensuite en mois. Google prévient que ses systèmes peuvent mettre plusieurs mois à confirmer qu'un site produit désormais des contenus utiles, et qu'il faudra parfois attendre la mise à jour principale suivante. Des mises à jour mineures, non annoncées, peuvent aussi faire remonter des contenus améliorés. Mesurez avec les mêmes filtres par section qu'au diagnostic. Si vous préférez confier ce travail, notre agence SEO mène ce diagnostic par section à partir de vos données Search Console.
Questions fréquentes
Google Panda existe-t-il encore ?
Plus comme système distinct. Google indique que Panda a évolué et s'est intégré à ses systèmes de classement principaux en 2015, et le range parmi les systèmes qui ne sont plus utilisés. Ses critères de qualité jouent désormais à chaque mise à jour principale.
Comment savoir si mon site a été touché par Panda ?
Aucun message ne l'annonce : Panda était un système automatique. Datez votre baisse dans la Search Console et comparez-la aux mises à jour principales publiées par Google, puis découpez-la par section du site. Si un message apparaît dans le rapport « Actions manuelles », il s'agit d'une action manuelle, qui se lève par une demande de réexamen.
Quelle différence entre Google Panda et Penguin ?
Panda visait la qualité du contenu, PenguinMise à jour Google (2012) ciblant les pratiques de netlinking abusives. le spam de liens. Selon le guide de Google, Penguin a été annoncé en 2012 et intégré aux systèmes de classement principaux en 2016, un an après Panda.
Le contenu dupliqué est-il pénalisé par Google ?
Pas le contenu en double au sein d'un site : Google le juge normal et conforme à ses règles sur le spam, même s'il peut gêner le choix de la page à afficher. Republier le contenu d'autres sites sans valeur ajoutée relève du scraping, interdit par ces règles.
Combien de temps pour sortir d'une pénalité Google Panda ?
Comptez plusieurs mois, sans pénalité à lever : il s'agit d'une réévaluation automatique. Google indique que certaines modifications prennent effet en quelques jours, mais que ses systèmes peuvent mettre plusieurs mois à confirmer qu'un site produit des contenus utiles, et qu'il faut parfois attendre la mise à jour principale suivante.
Sources
- Finding more high-quality sites in search (24 février 2011), Official Google Blog : googleblog.blogspot.com/2011/02/finding-more-high-quality-sites-in.html
- Guide des systèmes de classement dans la recherche Google, Google Search Central
- Autres conseils pour créer des sites de qualité, Google Search Central
- High-quality sites algorithm goes global, incorporates user feedback, Google Search Central
- High-quality sites algorithm launched in additional languages, Google Search Central
- Ce que les propriétaires de sites doivent savoir sur les mises à jour principales de Google d'août 2019, Google Search Central
- Créer des contenus utiles, fiables et people-first, Google Search Central
- Dernière mise à jour des consignes destinées aux évaluateurs de la qualité : l'expérience vient compléter le concept E-A-T, Google Search Central
- Rapport sur les actions manuelles, Aide Google
- En quoi consiste le choix de l'URL canonique ?, Google Search Central
- Règles concernant le spam dans la Recherche sur le Web Google, Google Search Central
- Ce que les créateurs Web doivent savoir sur notre mise à jour principale de mars 2024 et les nouvelles règles concernant le spam, Google Search Central
- Documentation Content Warehouse v0.4.0, module QualityNavboostCrapsCrapsData, HexDocs (documentation fuitée, copie publique) : google-api-content-warehouse.hexdocs.pm/0.4.0/GoogleApi.ContentWarehouse.V1.Model.QualityNavboostCrapsCrapsData.html
- Mises à jour principales de la recherche Google, Google Search Central
- Rapport sur les performances (résultats de recherche) : filtrage et comparaison avancés, Aide Google
- Documentation Content Warehouse v0.4.0, module IndexingSignalAggregatorAgeWeightedCoverageData, HexDocs (documentation fuitée, copie publique) : google-api-content-warehouse.hexdocs.pm/0.4.0/GoogleApi.ContentWarehouse.V1.Model.IndexingSignalAggregatorAgeWeightedCoverageData.html
- Rapport sur l'indexation des pages, Aide Google