
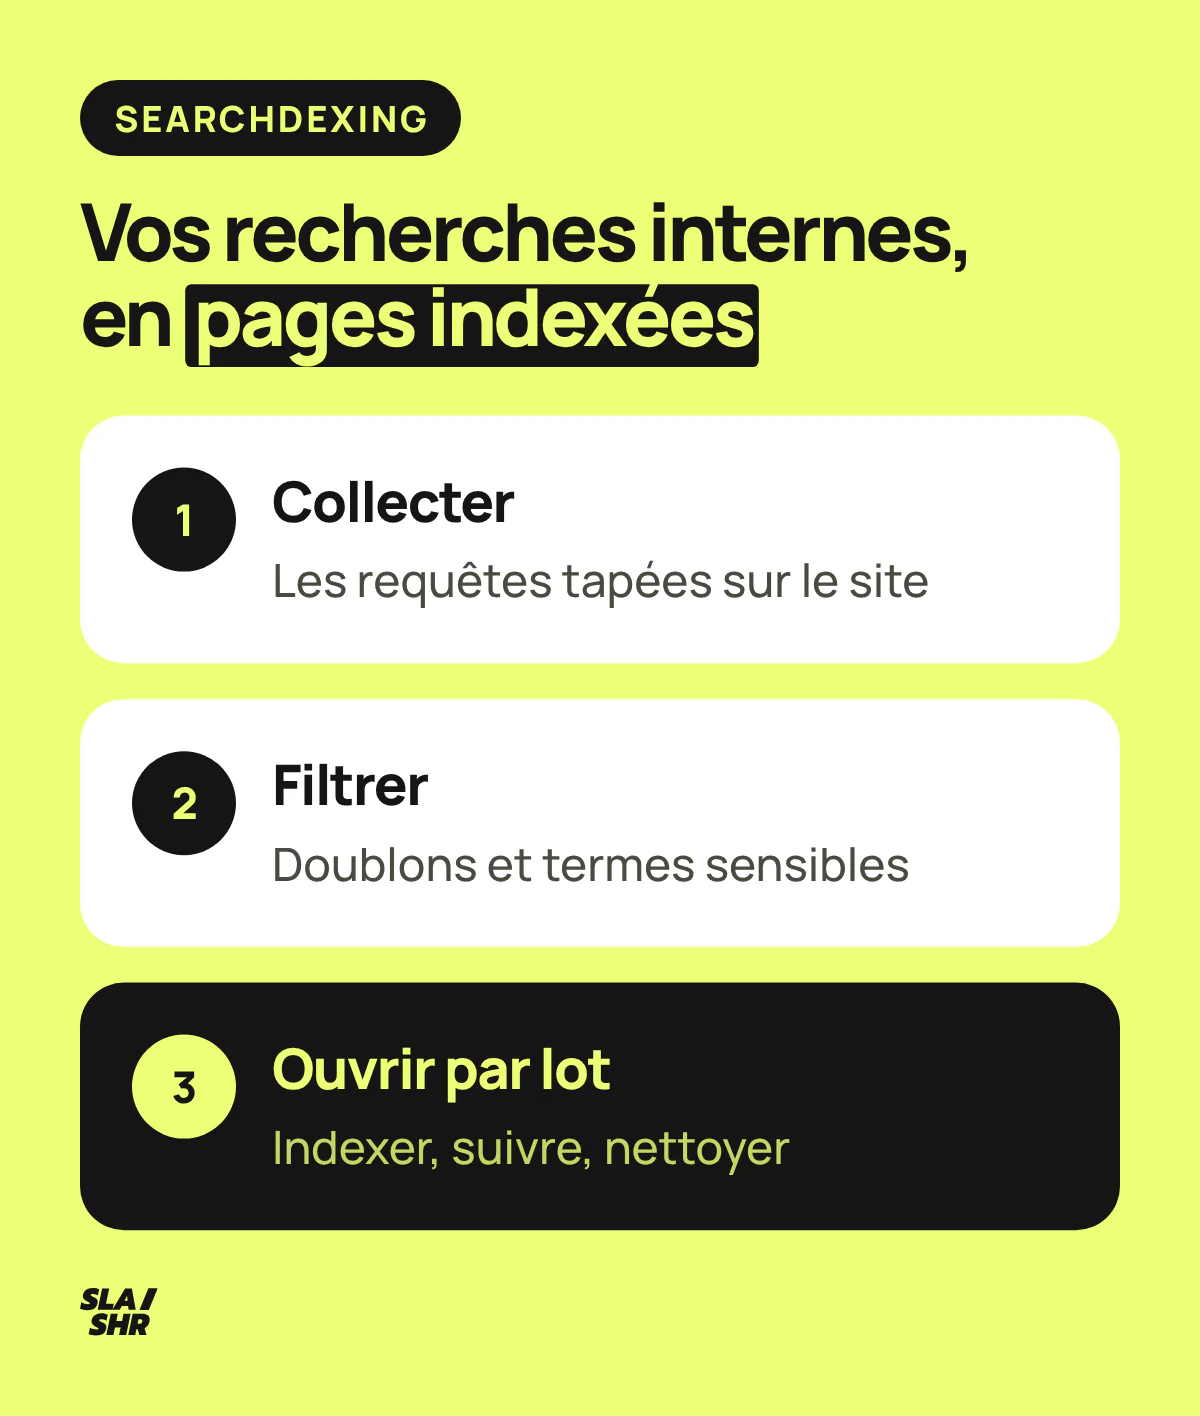
Le searchdexing (contraction de search et indexing) consiste à faire indexer par Google des pages issues du moteur de recherche interne d'un site : une requête tapée par les visiteurs devient une URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. de listing qui se positionne sur la longue traîneExpressions de recherche longues et spécifiques (3+ mots) avec moins de volume mais un meilleur taux de conversion.. Bien cadré, il ajoute des pages de catégorie que personne n'avait prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.évues. Laissé en roue libre, il remplit l'index de pages presque identiques.
La technique vise surtout les e-commerçants et les marketplaces à gros catalogue. Elle a fait grimper le trafic estimé de grands sites entre 2019 et 2022, puis plusieurs répertoires ont décliné. Voici ce que Google en dit en 2026, ce que montrent les cas connus et la méthode qui garde les bonnes pages sans ouvrir la recherche interne à Google.
Qu'est-ce que le searchdexing ?
Le searchdexing est l'indexation volontaire de pages générées à partir des requêtes du moteur de recherche interne. Un visiteur tape « aspirateur silencieux » dans la barre du site ; le site enregistre le terme, puis publie une page à URL fixe qui liste les produits correspondants et qui reste accessible à Google.

Trois types de pages se croisent souvent dans un même catalogue, et c'est là que naissent les confusions :
- la page de résultats de recherche interne, générée à la volée pour chaque requête (
/recherche?q=aspirateur+silencieux) ; - la page catégorie, construite par l'équipe produit et reliée à la navigation ;
- la page searchdexée, une requête interne retenue, figée sous une URL propre et liée depuis le site.
La particularité du searchdexing tient à sa matière première : les termes exacts que vos visiteurs tapent, avec leurs fautes, leurs combinaisons de critères et leurs marques. Une partie des visiteurs passe par cette barre plutôt que par le menu. Ce qu'ils y écrivent dit précisément ce qu'ils cherchent. Si vous voulez cadrer la mise en place sur votre catalogue, une agence de référencement naturel technique peut poser les règles de filtrage et de génération avec vos équipes.
Comment fonctionne le searchdexing ?
Le mécanisme part d'une requête interne et finit sur une page indexée, avec un filtre entre les deux. Sans ce filtre, chaque faute de frappe peut devenir une URL.

La collecte. Le site enregistre les termes tapés dans la barre de recherche. Google AnalyticsOutil gratuit Google pour analyser le trafic et le comportement des visiteurs d'un site. 4 le fait de base : l'événement view_search_results se déclenche quand l'URL contient l'un des paramètres q, s, search, query ou keyword, et le paramètre search_term alimente la dimension « Terme de recherche ». Ces termes font remonter des mots-clésTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. auxquels vous n'auriez peut-être pas pensé. Côté Google, les recherches associées jouent un rôle voisin : elles montrent les reformulations d'autres internautes autour d'une requête.
La génération. Une requête retenue devient une page de listing. Si beaucoup de visiteurs tapent « chaussures de running légères », une page dédiée présente la sélection de chaussures qui répond à ce critère, avec un titre, une courte introduction et des filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. propres.
L'indexationProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats.. La page reçoit des liens internesEnsemble des liens entre les pages d'un même site. Distribue le jus SEO et guide les utilisateurs. et entre dans le sitemap XMLFichier XML listant toutes les URLs d'un site pour faciliter leur découverte par les moteurs de recherche., puis Google la découvre, l'explore et décide de l'indexer ou non.
Le searchdexing cible surtout des mots-clés de longue traîne, des expressions précises qui génèrent peu de recherches chacune. « Chaussures de running légères pour femme » attire moins de monde que « chaussures de running », mais un visiteur qui arrive sur la bonne sélection a déjà fait la moitié de son choix.
Les avantages du searchdexing
Le premier avantage est la couverture. Des centaines de requêtes précises que vos catégories ne ciblent pas trouvent une page qui leur répond. Pour un site e-commerce, ce sont des listings du type « table basse relevable » ou « lit coffre 140x190 », deux pages searchdexées que Conforama plaçait en première position en 2023, sur des critères que la navigation ne combine pas toujours.

Le deuxième tient à l'intention. Une requête interne vient d'un visiteur déjà sur votre site, souvent en phase d'achat. Quelqu'un qui cherche « chaussures de marche pour terrains accidentés » et tombe sur une sélection adaptée a de bonnes chances d'acheter.
Les requêtes ne se valent pas toutes. Une requête plus informationnelle (« comment choisir un aspirateur silencieux ») appelle plutôt un guide : sur ce type de question, Google répond souvent sur la page de résultatsSearch Engine Results Page. Page affichée par un moteur de recherche en réponse à une requête utilisateur., en extrait optimisé de la position 0 ou dans un Aperçu IA de Google, et un listing y a peu de place.
Le troisième avantage est structurel. Les pages searchdexées s'intègrent à l'arborescence quand elles sont rattachées à une catégorie mère et liées entre elles, comme dans le siloing SEO, qui organise le contenu en silos thématiques. Elles renforcent alors la catégorie mère.
Conforama, Rakuten, ManoMano : ce que montraient les cas en 2023
Les relevés qui suivent datent d'octobre 2023 (SemrushSuite d'outils SEO complète pour l'analyse concurrentielle, les mots-clés et le suivi de positions., base France, desktop, trafic estimé). Même courbe sur les trois sites : une montée rapide, puis un plafond ou une baisse.

Conforama
Conforama publiait ses pages searchdexées sous le répertoire /s/ (/s/ilot-cuisine, /s/table-basse-relevable). Le trafic estimé du répertoire démarrait en 2021, culminait début 2023 puis se tassait.

On y trouvait des requêtes de moyenne et longue traîne, souvent en première position.

Chaque listing portait un bloc de liens vers des pages proches par le sens, catégories ou autres pages searchdexées. Les pages les plus recherchées étaient liées depuis une page réservée à cet usage.

Rakuten
Rakuten publiait ses pages searchdexées sous /s/. Le trafic estimé du répertoire a grimpé jusqu'en 2021, puis baissé jusqu'au relevé d'octobre 2023.

Un bloc de liens en bas de chaque page renvoyait vers d'autres pages searchdexées proches.

Une recherche site: sur le répertoire /s/ de Rakuten pour « aspirateur silencieux » renvoyait environ 2 760 résultats, dont plusieurs pages générées à partir de variantes de la même requête.

Le relevé Semrush de ces URL montrait que plusieurs d'entre elles ne se positionnaient sur rien :
| URL (fr.shopping.rakuten.com) | Trafic estimé | Mots-clés |
|---|---|---|
| /s/aspirateur+silencieux+et+puissant | 7 | 18 |
| /s/aspirateur+silence | 0 | 0 |
| /s/aspirateur+sans+fil+silencieux | 1 | 8 |
| /s/aspirateur+puissant+et+silencieux | 0 | 0 |
| /s/aspirateur+leger+et+puissant | 0 | 12 |
| /s/aspirateur+balai+sans+fil+puissant | 2 | 14 |
| /s/aspirateur+ultra+silencieux | 0 | 1 |
« Silencieux et puissant » et « puissant et silencieux » avaient chacune leur page. Le cas montre le double tranchant du searchdexing : la visibilité arrive d'un coup, mais sans regroupement des variantes, le répertoire se remplit de pages fantômes qui se disputent la même requête.
ManoMano
ManoMano publiait ses pages searchdexées sous /cat/, avec une courbe de trafic estimé qui culminait en 2022 avant de redescendre.

Parmi les mots-clés positionnés, une page sortait du lot : /cat/française+des+jeux+résultats+amigo, générée à partir d'une recherche sur les résultats d'un jeu de la Française des Jeux. Sur un site de bricolage, l'incohérence saute aux yeux, et une liste de termes exclus ou un contrôle humain avant publication l'aurait sans doute arrêtée.

ManoMano liait ses pages entre elles par deux blocs de liens. En haut de page, une rangée de recherches voisines.

En bas de page, un second bloc « Ça peut aussi vous intéresser » reprenait d'autres variantes.

En octobre 2026, le robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer. de ManoMano interdit l'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. de /recherche/ dans son groupe général (User-agent: *), celui que suit GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages.. La recherche brute reste fermée, et aucune règle ne vise le répertoire /cat/ des pages relevées en 2023.
Skroutz, le nettoyage documenté
Le comparateur grec Skroutz a publié en 2019 le chantier inverse.
Plus de la moitié de son budget d'exploration quotidien partait dans ses pages de recherche interne, la plupart sans trafic. L'équipe a revu 2,7 millions de requêtes : 2,2 millions sont passées en noindexDirective indiquant aux moteurs de ne pas indexer une page., 300 000 ont été redirigées vers un filtre ou une catégorie, 200 000 ont été gardées. À la publication de l'étude, l'index était descendu de 25 à 7,6 millions d'URL. Le détail du chantier est dans notre article sur le crawl budget en SEO.
Ce que Google dit du searchdexing en 2026
Google tolère l'indexation de pages de recherche interne, la déconseille pour des raisons techniques et préfère une vraie page de catégorie. John Mueller l'a détaillé en juillet 2026 dans l'épisode 113 du podcast Search Off the Record, consacré aux pages de résultats de recherche des sites.
Selon lui, les premières consignes aux webmasters demandaient de bloquer ces pages ; les règles de Google ne les mentionnent plus. Laisser indexer ses résultats de recherche ne fait pas forcément passer un site pour du spamTechniques manipulatrices visant à tromper les moteurs de recherche. : c'est « très inefficace », et le choix appartient au site. Trois points ressortent de l'épisode.

Un espace infini. N'importe qui peut faire un lien vers une recherche sur n'importe quel mot, et chaque tri ou filtre multiplie les URL. Google parle d'espace infini : il essaie de tout explorer, ce qui pèse sur le budget d'exploration et sur le serveur, puisque ces pages sont rarement mises en cache. Ses robots tentent de repérer ces motifs pour les déprioriser, sans garantie de délai.
Une vraie catégorie ferait mieux. Mueller admet qu'un robots.txt nuancé peut bloquer toute la recherche et autoriser quelques motifs liés depuis le site. Mais il estime qu'une vraie page de catégorie ferait sans doute mieux, parce qu'elle peut expliquer pourquoi le terme compte et quelles pages du site sont les meilleures pour lui. C'est exactement ce que doit devenir une page searchdexée réussie.
Une porte d'entrée pour le spam. Une page de recherche indexable qui affiche le terme tapé en gros titre sur la page peut se positionner sur ce terme, quel qu'il soit. Des spammeurs font des liens vers des milliers de sites avec des requêtes sur des médicaments ou des contenus pour adultes suivies d'un numéro de téléphone. Google peut alors signaler le site comme piraté dans la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche..
Les règles anti-spam de Google tracent la limite. Parmi les exemples de pages satellites, elles citent le fait de « créer des pages sensiblement similaires qui sont plus proches des résultats de recherche qu'une arborescence clairement définie et facile à parcourir ».
La règle sur l'abus de contenu à grande échelle, annoncée le 5 mars 2024, vise le fait de générer de nombreuses pages dans le but principal de manipuler le classementPosition d'une page web dans les résultats de recherche pour une requête donnée., sans aider les utilisateurs. Une page searchdexée sans contenu propre, quasi identique à sa voisine, peut relever des deux règles.
Mueller laisse le choix entre deux voies : le robots.txt, « la plus simple », et le noindex, « presque plus propre » selon lui, puisqu'une URL bloquée peut en théorie s'afficher dans les résultats. Avec un noindex, Google continue en revanche de demander les pages, même si ses systèmes apprennent à ralentir sur un lot entièrement en noindex. Sur un espace infini, c'est l'exploration qu'il faut couper.
La consigne qui en découle suit le guide de Google sur le budget d'exploration, qui conseille de bloquer par le robots.txt les pages sans importance qu'on ne peut pas consolider. La recherche brute (/recherche?q=) reste hors de l'exploration par un Disallow si elle n'a jamais été indexée.
Si elle l'est déjà, posez d'abord un noindex sur une page laissée explorable, puis le Disallow une fois les URL sorties de l'index : pour que le noindex soit lu, la page ne doit pas être bloquée par le robots.txt. Le guide pour désindexer une URL de Google détaille comment vérifier la lecture du noindex et la sortie de l'index. Les pages searchdexées, elles, vivent dans un autre répertoire, ouvert à l'exploration.
Les risques du searchdexing
Les risques du searchdexing viennent surtout du volume : plus le site génère de pages sans contrôle, plus il dilue ses catégories et son exploration.

La cannibalisationSituation où plusieurs pages d'un même site se font concurrence sur les mêmes mots-clés.. Une page générée sans regarder l'existant concurrence la catégorie ou la page voisine qui vise déjà la même requête, comme les variantes « silencieux et puissant » de Rakuten. Dans le relevé de 2023, « silencieux et puissant » se positionnait sur 18 mots-clés, « puissant et silencieux » sur aucun : la seconde page ne servait à rien. Le guide sur la cannibalisation SEO explique comment repérer deux URL qui se disputent une requête.
Le budget de crawlNombre de pages que Googlebot peut et veut crawler sur un site dans un temps donné.. Le budget de crawl correspond au nombre d'URL que Googlebot peut et veut explorer sur votre site. Selon la documentation de Google, si Google passe trop de temps à explorer des URL qu'il ne devrait pas, ses robots peuvent décider de ne pas explorer le reste du site. Sur un gros catalogue, des milliers de pages searchdexées faibles peuvent retarder l'exploration de vos fiches produits et de vos nouveautés.
Le contenu de masse. Des centaines de pages qui ne diffèrent que par l'ordre des mots peuvent relever de la règle sur l'abus de contenu à grande échelle. Le risque peut toucher le site entier : selon Google, un site qui enfreint ses règles anti-spam peut être moins bien classé, voire disparaître des résultats.
Les termes inappropriés et le spam. Marques concurrentes, termes protégés, requêtes hors sujet comme le jeu de la Française des Jeux chez ManoMano, ou injections de spam : une page publiée sans liste d'exclusion engage la réputation de la marque.
Mettre en place un searchdexing propre, étape par étape
La méthode tient en une règle : la recherche interne fournit la liste des candidats, et seule une page filtrée, éditée et rattachée à l'arborescence entre dans l'index. Le reste attend.
1. Collecter les requêtes
Exportez les termes de recherche sur une période assez longue pour lisser la saisonnalité : un an pour un catalogue saisonnier. Regardez les tendances (termes en hausse, modes soudaines) et les recherches qui ne renvoient aucun résultat : elles signalent des produits ou des catégories absents de votre offre.
2. Centraliser dans une base
Rassemblez les requêtes dans une base structurée (terme normalisé, nombre de recherches, nombre de produits renvoyés, catégorie de rattachement) et mettez-la à jour à chaque lot. C'est elle qui pilote la génération et le suivi.
3. Filtrer automatiquement, puis valider à la main
Le filtrage automatique fait le gros du tri : il regroupe les variantes (pluriels, ordre des mots, accents), écarte les requêtes déjà couvertes par une catégorie et celles qui renvoient trop peu de produits pour faire une vraie page. Un contrôle humain valide ensuite chaque lot avant publication, parce qu'un filtre laisse passer des cas comme la page Amigo de ManoMano.
Une requête informationnelle part vers un guide. Une requête qui recoupe un filtre de votre catalogue se traite avec les règles des filtres à facettes en SEO, pour éviter deux URL sur la même combinaison.
4. Tenir une liste d'exclusion
Listez les termes offensants, les marques que vous ne vendez pas, les termes protégés par des droits et tout ce qui sort de votre univers. Enrichissez la liste à chaque lot avec ce que la validation humaine a écarté.
5. Publier de vraies pages sous une URL propre
Chaque page retenue prend une URL descriptive, sans accent ni paramètre, dans un répertoire distinct de la recherche (/selection/chaussures-running-legeres). Donnez-lui ce que la recherche brute n'a pas : un title et un H1Balise HTML du titre principal d'une page. Il ne doit y en avoir qu'un seul par page. écrits, une introduction qui dit pour qui est la sélection, des produits triés par pertinence. Le guide pour optimiser une page catégorie détaille ces éléments, qui valent aussi pour une page searchdexée.
6. Mailler
Rattachez chaque page à sa catégorie mère et liez-la à des pages proches. Une page « chaussures de running » peut renvoyer vers « vêtements de running » ou vers un guide pour débuter la course. Un score de proximité sémantique entre requêtes aide à choisir ces liens, et une page plan qui liste les sélections les plus recherchées, comme celle de Conforama, donne un point d'entrée à Googlebot.
7. Ouvrir par lot
Publiez les pages par lot, déclarez-les dans un sitemap XML dédié et suivez chaque lot dans le rapport Indexation des pages de la Search Console. Un sitemap aide Google à découvrir les URL, sans garantir qu'elles seront explorées et indexées. Le lot suivant ne part que si le précédent s'indexe et ramène des visites.

Suivre et nettoyer les pages dans la durée
Un répertoire searchdexé se pilote en continu. Chaque lot se suit dans la Search Console, et l'ensemble se revoit au moins une fois par an.

Le suivi des lots tient en quelques questions : la page est-elle indexée, se positionne-t-elle sur sa requête, ramène-t-elle des visites et des ventes ? Une page qui reste à zéro après plusieurs mois quitte l'index. Skroutz a procédé ainsi : redirection vers le filtre ou la catégorie qui couvre la même intention, noindex pour le reste. Une redirection 301Redirection permanente transférant le jus SEO de l'ancienne URL vers la nouvelle. convient pour ce transfert, et une page supprimée peut aussi répondre en 404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget. ou 410.
La revue annuelle reprend tout le répertoire : pertinence face à l'offre du moment, pages en double apparues entre deux lots, nouvelles requêtes qui méritent le prochain lot. Une refonteModification majeure du design ou de la structure d'un site. Risque SEO si mal gérée. qui change le motif d'URL des pages searchdexées impose un plan de redirection page par page, l'un des points de notre accompagnement SEO à la refonte de sites web.
Questions fréquentes
Le searchdexing est-il pénalisé par Google ?
Pas en tant que tel. En juillet 2026, John Mueller a précisé que les règles de Google ne mentionnent plus les pages de résultats de recherche et qu'un site qui les laisse indexer n'est pas forcément considéré comme du spam. Il cite une exception : une recherche indexable qui affiche n'importe quel terme peut servir aux spammeurs. Le risque vient aussi du volume, puisque des pages quasi identiques peuvent relever des règles sur les pages satellites ou sur l'abus de contenu à grande échelle.
Faut-il bloquer la recherche interne dans le robots.txt avant un searchdexing ?
Oui pour la recherche brute qui n'a jamais été indexée : un Disallow sur son motif d'URL évite l'espace infini. Si ces pages sont déjà indexées, posez d'abord un noindex et attendez qu'elles sortent de l'index avant de les bloquer, sinon Google ne lit jamais la balise. Les pages searchdexées retenues vivent sous un autre répertoire, ouvert à l'exploration.
Quelle différence entre searchdexing et filtres à facettes ?
Les facettes combinent les attributs du catalogue (couleur, taille, marque), le searchdexing part des mots tapés par les visiteurs. Les deux produisent des listings et peuvent se recouper : une requête interne qui correspond à une facette ouverte n'a pas besoin de sa propre page.
Le searchdexing convient-il à un petit site ?
Rarement. Il suppose un catalogue large et assez de recherches internes pour faire émerger des requêtes récurrentes. Sur un catalogue de quelques dizaines de produits, des catégories bien construites couvrent déjà la demande.
Sources
- Search Off the Record: Should you block your Search result pages? : search-off-the-record.libsyn.com/should-you-block-your-search-result-pages-transcript
- Règles concernant le spam dans la Recherche sur le Web Google, Google Search Central
- Ce que les créateurs Web doivent savoir sur notre mise à jour principale de mars 2024 et les nouvelles règles concernant le spam, Google Search Central
- Bloquer l'indexation dans la recherche avec "noindex", Google Search Central
- Gestion du budget d'exploration, Google Search Central
- Qu'est-ce qu'un sitemap ?, Google Search Central
- Événements collectés via les mesures améliorées, Aide Google
- [Case Study] How we optimized our Crawl Budget : engineering.skroutz.gr/blog/SEO-Crawl-Budget-Optimization-2019/
- manomano.fr/robots.txt