
Le black hat SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche.Techniques SEO contraires aux guidelines Google, risquant des pénalités. regroupe les techniques qui cherchent à manipuler le classementPosition d'une page web dans les résultats de recherche pour une requête donnée. de Google en enfreignant ses règles anti-spam : liens achetés et PBN, contenu produit à grande échelle, domaines expirés détournés, cloakingTechnique black hat affichant un contenu différent aux moteurs et aux utilisateurs. Fortement pénalisée., texte caché, redirections trompeuses. Google les repère avec des systèmes automatisés et des examinateurs humains, et un site concerné peut reculer ou disparaître des résultats.
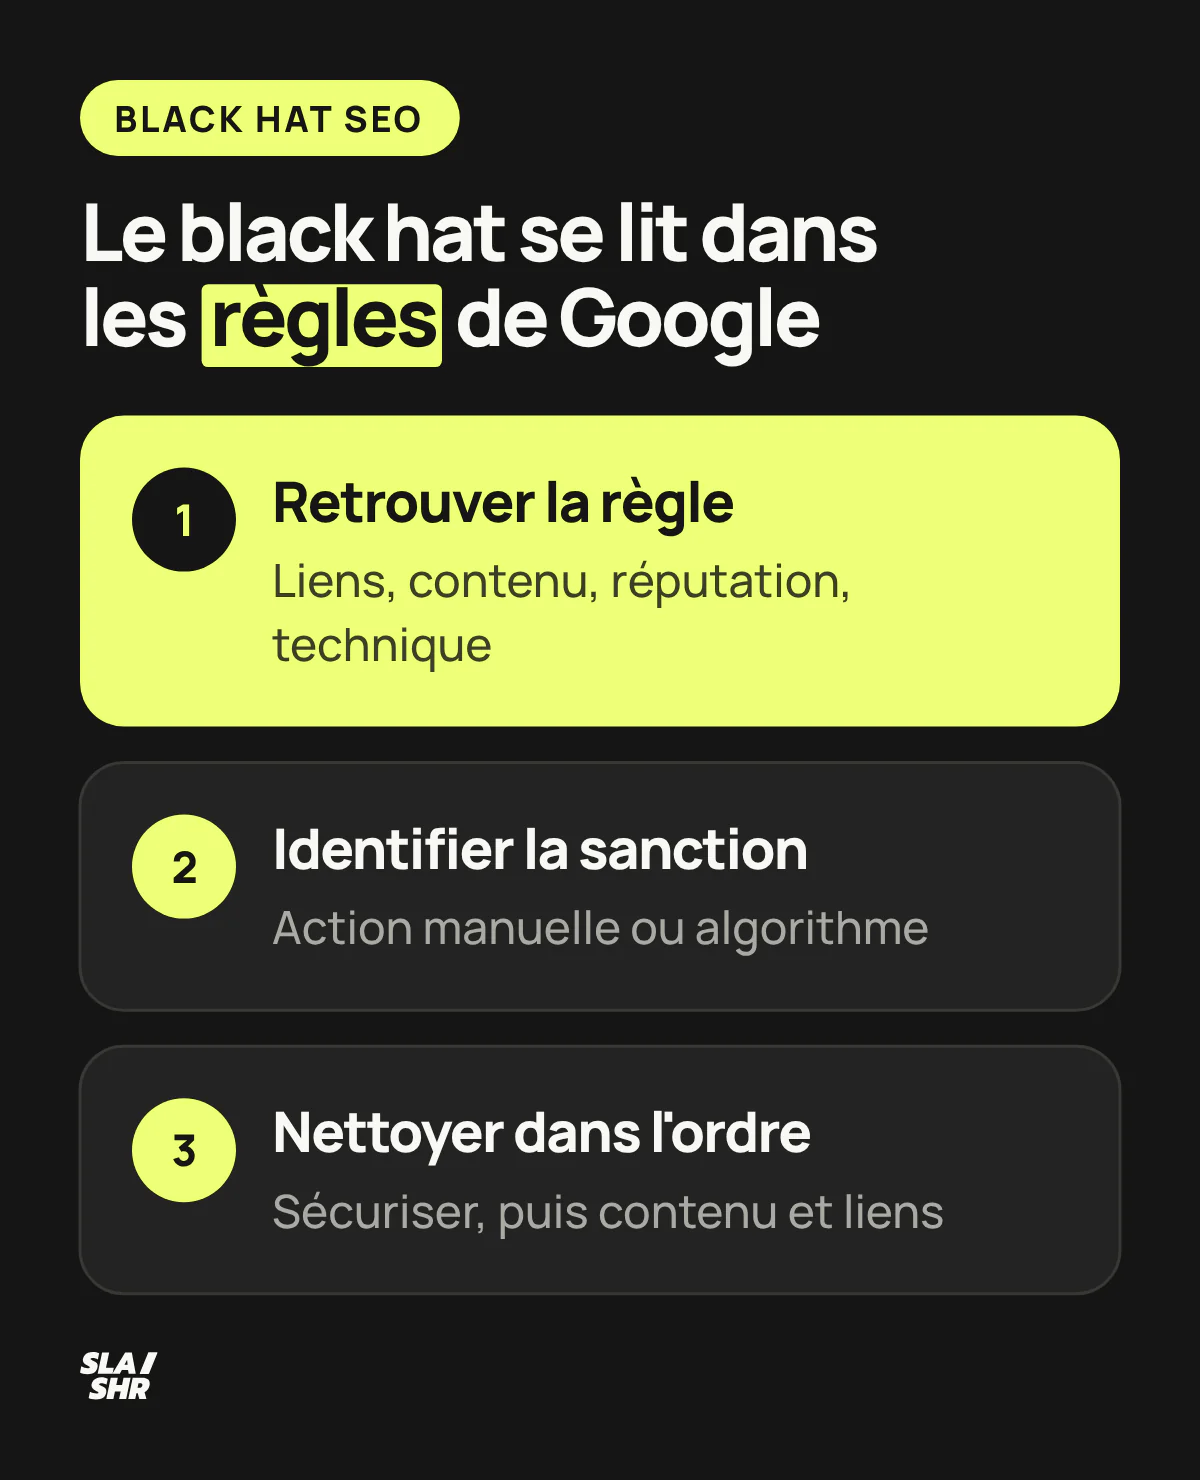
La définition du spamTechniques manipulatrices visant à tromper les moteurs de recherche. par Google couvre aussi, dans sa version actuelle, les tentatives de manipuler les réponses de l'IA générative de sa recherche. Pour un site que vous reprenez, la question pratique est ailleurs : retrouver les traces d'un black hat passé, savoir quelle sanction pèse dessus, puis nettoyer dans le bon ordre.
Black hat, white hat, grey hat : la frontière que trace Google
La frontière passe par l'intention. Google appelle spam les techniques utilisées pour tromper les internautes ou manipuler ses systèmes de recherche, et ses règles sur les liens visent ceux créés « principalement dans le but de manipuler les classements ».
Le white hat produit de la valeur pour le lecteur : contenu éditorial, maillage interne propre, optimisation technique, liens obtenus parce que la page mérite d'être citée. Il ne s'expose ni à une action manuellePénalité appliquée manuellement par un employé Google pour violation des guidelines. ni à la neutralisation de ses liens, et il va dans le sens de ce que les mises à jour cherchent à mettre en avant. Une mise à jour principale peut quand même le faire reculer, sans sanction derrière.
Le black hat enfreint une règle écrite. Il rapporte parfois un temps, jusqu'à ce que SpamBrain ou un examinateur le repère. Ce pari ne se calcule que pour un site sans marque à protéger, monté pour être remplacé quand il tombe. Google a prévu le cas : sa règle sur le contournement vise la création de sous-domaines, de sous-répertoires ou de sites pour continuer à enfreindre ses règles, et il peut alors restreindre l'éligibilité à Discover ou à À la une, voire retirer d'autres sections du site des résultats.
Le grey hatTechniques SEO à la limite des guidelines, ni totalement white hat ni black hat. est surtout un argument de vente : PBN « propre », liens achetés « discrets », pages générées « encadrées ». Les règles de Google n'ont pas de case intermédiaire. Un lien payé qualifié en rel="sponsoredAttribut pour identifier les liens sponsorisés ou publicitaires." ou rel="nofollowAttribut indiquant aux moteurs de ne pas suivre un lien ou de ne pas transmettre de jus SEO." est conforme, le même lien sans attribut entre dans les liens toxiquesBacklink de mauvaise qualité pouvant nuire au référencement (spam, PBN, sites pénalisés).. Vous savez de quel côté vous êtes en lisant la règle, pas l'étiquette du prestataire.

Les techniques black hat, règle par règle
Chaque technique black hat correspond à une règle publiée par Google, avec ses exemples. C'est la grille la plus fiable pour juger une pratique qu'on vous propose ou que vous découvrez sur un site.
Les liens : PBN, achats, échanges
Les liens toxiques consistent à « créer des liens vers ou depuis un site principalement dans le but de manipuler les classements ». Google y range l'achat de liens ou de messages contenant des liens, l'échange de biens ou de services contre des liens, les échanges de liens excessifs, les programmes automatisés, les ancresTexte cliquable d'un lien hypertexte. Doit être descriptif et pertinent. optimisées dans des articles invités ou des communiqués, les liens distribués dans les pieds de page de différents sites et les annuaires de qualité médiocre. Un lien payé reste conforme tant qu'il est qualifié en nofollow ou sponsored ; la méthode pour obtenir des liens qui comptent est dans le guide du netlinking.
Un PBN (Private Blog NetworkPrivate Blog Network. Réseau de sites créés pour générer des backlinks. Pratique risquée et contre les guidelines.) est un réseau de sites montés pour faire des liens vers un site principal. Il coche la règle des liens toxiques, et souvent celle des domaines expirés quand le réseau est bâti sur des noms rachetés pour leur historique.
Un PBN au service d'un site e-commerce ne change pas de catégorie : la règle vise le but du lien, quel que soit le secteur du site qui le reçoit. Et c'est la boutique qui porte le risque, puisque l'action manuelle « Liens artificiels vers votre site » frappe le site qui reçoit les liens, sur tout ou partie de ses pages. Une agence qui vend l'accès à son PBN vend donc des liens que SpamBrain, depuis décembre 2022, cherche à neutraliser en repérant les sites qui achètent des liens et ceux qui servent à en distribuer.
Le contenu : grande échelle, scraping, accumulation de mots clés
L'utilisation abusive de contenus à grande échelle désigne le fait de générer de nombreuses pages dans le but principal de manipuler le classement, avec peu ou pas d'intérêt pour les utilisateurs, « quelle que soit la façon dont ils sont créés ». Google cite l'IA générative utilisée pour produire de nombreuses pages sans valeur ajoutée, mais aussi les flux détournés, les transformations automatiques (synonymes, traduction) et les sites multipliés pour masquer le volume. La règle, publiée en mars 2024, vise aussi bien le contenu produit par des humains.
Google le dit depuis février 2023 : il juge la qualité du contenu plutôt que la façon dont il est produit. Un article rédigé avec l'IA, relu et utile, reste dans les règles ; mille fiches générées sans valeur ajoutée pour capter des requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. tombent sous la règle du contenu à grande échelle.
Le scraping consiste à republier le contenu d'autres sites sans valeur ajoutée, parfois légèrement modifié par des synonymes. L'accumulation de mots clés (keyword stuffingRépétition excessive de mots-clés dans un contenu. Pratique pénalisée par Google.) consiste à remplir une page de mots clés ou de chiffres pour manipuler le classement, par exemple des villes et régions citées plusieurs fois pour ressortir sur ces lieux. Elle a son action manuelle dédiée : « Texte caché et/ou accumulation de mots clés ».
Les pages satellites suivent la même logique. Google donne l'exemple de plusieurs pages ou domaines qui ciblent des villes et canalisent les internautes vers une seule page. Un réseau de magasins qui publie une page par point de vente, avec son adresse, ses horaires et son offre, sert le visiteur ; cent pages ville sans magasin derrière correspondent à l'exemple de Google.
La réputation : domaines expirés et site parasite
L'abus de domaines expirés consiste à acheter un nom arrivé à expiration principalement pour manipuler le classement en y hébergeant des contenus de peu d'intérêt. Google cite le contenu lié aux casinos sur l'ancien site d'une école primaire. Un ancien domaine pour un nouveau site utile reste permis : la méthode pour choisir un domaine expiré sans tomber dans cette règle détaille les vérifications.
Le spam lié à la réputation d'un site vise un contenu tiers publié sur un site hôte principalement pour profiter de ses signaux de classement, comme une page « meilleurs casinos » posée sur un site médical. Dans l'Espace économique européen, Google a changé l'application de cette règle : l'action manuelle n'y a aucun effet, et les pages concernées peuvent être classées séparément du domaine principal, sur leurs propres mérites.
La technique : cloaking, redirections trompeuses, texte caché
Le cloaking consiste à présenter aux internautes et aux moteurs un contenu différent, dans le but de manipuler le classement et de tromper les internautes. Google donne deux exemples : une page sur des destinations de voyage pour les moteurs et une autre sur des médicaments pour les visiteurs, ou du texte inséré seulement quand le user-agent est un moteur. Un site piraté en est souvent victime : le pirate cache ses pages au propriétaire avec cette technique.
Les redirections trompeuses envoient l'internaute vers un contenu qui ne correspond pas à ce qu'il a demandé, comme une page normale sur ordinateur et un domaine de spam sur mobile. Déménager un site ou regrouper deux pages reste légitime.
Le texte et les liens cachés regroupent le texte blanc sur fond blanc, la police à taille ou opacité nulle, le texte positionné hors de l'écran ou le lien posé sur un seul caractère. Les accordéons et les onglets restent conformes. Dernier cas, les données structuréesCode ajouté au HTML pour aider les moteurs à comprendre le contenu et générer des rich snippets. trompeuses, comme de faux avis balisés : l'action manuelle retire l'éligibilité aux résultats enrichis, sans effet sur le classement de la page dans la recherche Web.

Les mêmes techniques retournées contre un concurrent, liens toxiques en masse ou contenu copié, relèvent du negative SEO, qui a ses propres signes d'alerte.
Comment Google détecte et sanctionne le black hat
Google combine des systèmes automatisés et une révision humaine, et la sanction va du recul dans les résultats à la disparition. Les sites qui enfreignent ses règles « peuvent être moins bien classés dans les résultats ou ne pas y figurer du tout ».
Côté automatique, SpamBrain est le système de prévention du spam basé sur l'IA. Il tourne sans interruption ; quand Google l'améliore nettement, il l'annonce comme une mise à jour anti-spam. Le tableau de bord de l'état de la recherche Google en recense quatre en 2026 au 13 octobre : mars, juin, août et septembre.
Les liens ont un traitement à part. Quand une mise à jour contre le spam dans les liens neutralise des liens artificiels, l'avantage qu'ils avaient apporté est perdu et ne se récupère pas.
Côté humain, un examinateur qui constate une infraction déclenche une action manuelle. La plupart entraînent la rétrogradation ou la suppression des pages, sans aucune indication pour l'internaute.

Les réponses des assistants entrent dans le même cadre, puisque la définition du spam vise aussi la manipulation des réponses de l'IA générative dans la recherche Google. Travailler la présence d'une marque dans ces réponses passe par les mêmes règles : c'est le terrain d'une agence GEO.
Action manuelle ou déclassement algorithmique : le diagnostic
Une action manuelle s'affiche dans la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche., un déclassement algorithmique ne s'affiche nulle part : le traitement n'est pas le même, et les confondre fait perdre des mois.
L'action manuelle apparaît dans le rapport « Actions manuelles » (menu Sécurité et actions manuelles) et dans le centre de messagerie. Son libellé dit ce qui est reproché : « Liens artificiels vers votre site », « Contenu pauvrePages avec peu de contenu ou de valeur ajoutée, pénalisées par Google. qui ne présente que peu ou pas d'intérêt », « Spam généré par des utilisateurs », « Problèmes majeurs liés au spam ». Vous corrigez sur toutes les pages, puis vous cliquez sur Demander un examen en décrivant les corrections. Google annonce plusieurs jours, voire plusieurs semaines de traitement, davantage pour les demandes liées aux liens. Si vous venez d'acheter le site, dites-le dans la demande.
Le déclassement algorithmique ne laisse aucun message. Vous le datez en croisant votre chute avec la liste des mises à jour publiée par Google : une chute qui démarre pendant le déploiement d'une mise à jour anti-spam pointe vers les règles ci-dessus. Pas de réexamen possible : vous corrigez, puis vous attendez. Après une mise à jour anti-spam, Google évoque un site analysé « pendant plusieurs mois » avant que ses modifications l'aident, et prévient que le nettoyage de liens peut ne rien améliorer ; après une mise à jour principale, ses systèmes peuvent mettre plusieurs mois à confirmer qu'un site produit désormais des contenus utiles.

Avant de conclure à une sanction, regardez les impressionsNombre de fois qu'une page apparaît dans les résultats de recherche, qu'elle soit cliquée ou non.. Des clics qui baissent pendant que les impressions montent relèvent de l'effet crocodile entre impressions et clics. Une sanction, elle, se voit dans les impressions et les positions.
Auditer un site hérité du black hat
Sur un site repris, cherchez les traces dans trois couches, les liens, le contenu et la technique, avant tout audit classique : une sanction en cours fausse la lecture de tout le reste.

Les liens : exporter, regrouper, décider
Exportez votre profil de liens depuis la Search Console, par nom d'hôte (Principaux sites d'origine, Exporter) ou par ordre chronologique (liens externes les plus récents). Le rapport donne un échantillon : complétez avec AhrefsOutil SEO payant spécialisé dans l'analyse des backlinks et la recherche de mots-clés., MajesticOutil spécialisé dans l'analyse des backlinks avec les métriques Trust Flow et Citation Flow. ou SemrushSuite d'outils SEO complète pour l'analyse concurrentielle, les mots-clés et le suivi de positions. si vous y avez accès.
Triez ensuite par domaine référentSite web distinct envoyant au moins un backlink vers votre site. et cherchez des grappes plutôt que des liens isolés : des sites hors de votre thématique qui partagent le même gabarit, le même hébergement ou la même plage d'adresses IP, les mêmes ancres commerciales, apparus dans la même fenêtre de temps. Une extension exotique ou un nom de domaine sans rapport reste un indice, que la grappe confirme ou écarte.
Chaque grappe reçoit une décision. Demandez d'abord le retrait du lien, ou l'ajout d'un attribut nofollow, au propriétaire du site : Google prévient qu'ajouter aveuglément tous les liens entrantsLien provenant d'un site externe pointant vers votre site. Facteur de ranking majeur. au fichier de désaveuOutil Google Search Console permettant de demander à Google d'ignorer certains backlinks. n'est pas un effort de bonne foi. Le désaveu sert au cas qu'il décrit : un nombre considérable de liens artificiels qui ont engendré, ou risquent d'engendrer, une action manuelle. Le fichier de désaveu (disavow) se remplit alors par domaine, avec le préfixe domain:. Hors de ce cas, Google évalue seul la plupart des liens.
Le contenu : vagues de pages, titles en série, orphelines
Lancez un crawl complet avec Screaming Frog ou Sitebulb et croisez-le avec la Search Console : date de publication, nombre de mots, clics et impressions des derniers mois. Trois signatures ressortent.
La première, des vagues de pages publiées en quelques jours sur un gabarit identique : même structure, mêmes transitions, longueur presque constante. Lisez trois URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. au hasard de la vague ; si elles sont interchangeables, vous êtes sur du contenu à grande échelle.
La deuxième, des titles en série : « Acheter X pas cher », « Acheter X en ligne », « Acheter X livraison rapide » sur des centaines d'URL. C'est de l'accumulation de mots clés par modèle, et souvent la source d'une cannibalisation SEO massive.
La troisième, des pages indexProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats.ées que rien ne lie dans le site : souvent des pages satellites laissées par l'ancienne équipe, ou des pages injectées après un piratage. Le rapport sur les problèmes de sécurité de la Search Console signale le contenu piraté.
La technique : comparer le rendu Googlebot et le rendu navigateur
Le cloaking se détecte en comparant ce que reçoit Google et ce que voit un visiteur, la méthode que Google donne lui-même pour l'action manuelle correspondante. Procédez en trois temps.
- Dans la Search Console, inspectez l'URL, cliquez sur Tester l'URL active, puis sur Afficher la page testée : vous obtenez le HTML brut et une capture d'écran. La requête part en général des adresses publiées par Google pour ses robots, avec l'agent Google-InspectionTool.
- Ouvrez la même URL dans un navigateur en navigation privée, sur ordinateur puis sur mobile, en cliquant depuis un résultat Google : certaines redirections ne visent que les visiteurs qui arrivent de la recherche.
- Complétez en ligne de commande, pour tester le user-agent GooglebotRobot d'exploration de Google qui parcourt le web pour découvrir et indexer les pages. et la provenance Google :
URL="httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.exemple.fr/page"
BOT="Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
NAV="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/141.0.0.0 Safari/537.36"
curl -sL -A "$BOT" -o bot.html -w 'bot %{http_code} %{url_effective}\n' "$URL"
curl -sL -A "$NAV" -o nav.html -w 'nav %{http_code} %{url_effective}\n' "$URL"
diff <(grep -o 'href="[^"]*"' bot.html | sort -u) <(grep -o 'href="[^"]*"' nav.html | sort -u)
diff <(grep -o 'href="[^"]*"' bot.html | sort -u) <(grep -o 'href="[^"]*"' nav.html | sort -u) | grep '^<' | grep -o '\(https\?:\)\?//[^/"]*' | sort | uniq -c
wc -c bot.html nav.html
curl -sL -A "$NAV" -e "https://www.google.com/" -o /dev/null -w 'depuis Google %{http_code} %{url_effective}\n' "$URL"
Ne lisez la comparaison que si les deux requêtes répondent 200 avec la vraie page. Un 403, une absence de réponse ou une page de contrôle anti-robots, d'un côté ou des deux, veut dire que le site bloque curl : la comparaison ne dit rien. Ouvrez nav.html pour le vérifier, car une page de contrôle peut répondre 200 : un message qui demande d'activer le JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. ou un captcha en est une. Un 403 sur la seule requête Googlebot vient en général d'un site qui vérifie l'adresse IP des robots, une vérification que Google documente (la résolution DNS inverse d'un vrai Googlebot donne un nom en googlebot.com). Dans ces cas, passez par l'inspection d'URL et le navigateur.
Avec deux réponses 200 :
- même URL finale et aucune ligne dans le premier
diff: les liens ne changent pas selon le user-agent ; - des liens présents seulement dans
bot.html: la ligne suivante regroupe par domaine ceux qui sont écrits en adresse complète (les liens relatifs n'y figurent pas, ils pointent vers votre site). Des liens vers vos propres pages signalent un gabarit plus riche servi au robot, à examiner sans conclure trop vite ; des liens vers des domaines que vous ne connaissez pas sont la signature d'un site piraté ; - une taille de fichier nettement différente : le gabarit change pour le robot, ce qui arrive sur des sites sains, d'autant que curl n'exécute pas le JavaScript qui complète la page du navigateur. Comparez le texte de
bot.htmlà la page affichée dans le navigateur, cookies acceptés et page déroulée jusqu'en bas : un contenu que le visiteur ne voit nulle part oriente vers le cloaking ; - une URL finale différente sur la ligne « depuis Google » : une redirection réservée aux visiteurs venus de Google.
Google précise aussi que les redirections trompeuses sont souvent écrites en JavaScript, que curl n'exécute pas, ou dans un fichier .htaccess : l'inspection et le navigateur couvrent le premier cas.
Si le contenu diffère pour manipuler le classement, c'est du cloaking, un motif d'action manuelle que Google cite aussi parmi les « Problèmes majeurs liés au spam ». Un cas est toléré : le paywall qui montre l'article entier à Googlebot, comme à un abonné, et suit ses conseils d'échantillonnage flexible ; la déclaration en données structurées et la méthode sont dans le guide paywall et SEO.
Restent deux vérifications. Les redirections d'abord : cherchez celles qui ne visent que les internautes venus de Google, certaines adresses IP ou le mobile, et les chaînes de redirections qui finissent sur une page de monétisation sans rapport avec le contenu attendu. Le balisage ensuite : des notes Review ou AggregateRating sur des pages sans système d'avis, ou des données structurées sur du contenu invisible, exposent à une action manuelle qui coupe les résultats enrichis.
Nettoyer un site hérité, dans l'ordre
L'ordre suit le diagnostic : vous traitez d'abord ce que Google reproche explicitement, puis ce qui peut faire tomber le site à la prochaine mise à jour.
Sécurisez avant tout. Fermez les accès d'un site piraté, supprimez les pages injectées et vérifiez le rapport sur les actions manuelles.
Sous action manuelle, corrigez le motif sur toutes les pages, documentez ce que vous avez supprimé et ajouté, puis demandez le réexamen.
Le contenu vient ensuite. Améliorez ce qui peut l'être et sortez le reste de la recherche : Google demande d'exclure de sa recherche le contenu produit à grande échelle, et rappelle que supprimer des sections entières d'un site créées pour les moteurs peut améliorer les performances des contenus utiles. Une page qui reste en ligne passe en noindexDirective indiquant aux moteurs de ne pas indexer une page., une page supprimée répond 404 ou 410, en suivant une vraie procédure de désindexation.
Les liens se traitent en parallèle, par grappes : retrait à la source quand c'est possible, désaveu seulement dans le cas décrit plus haut. Ne comptez pas retrouver le classement d'avant : un avantage tiré de liens neutralisés ne se récupère pas.

Mesurez ensuite par section du site, impressions et positions d'abord, en comptant en mois : c'est le délai que Google évoque pour réévaluer un site. Puis reconstruisez sur du propre, contenu signé, maillage raisonné, liens gagnés. Si vous confiez ce travail, les questions de notre classement des meilleures agences SEO aident à écarter les garanties de position et les forfaits de liens au volume.
Questions fréquentes
Un PBN peut-il servir un site e-commerce sans risque ?
Non. Les règles de Google rangent les liens créés pour manipuler le classement parmi les liens toxiques, quel que soit le secteur. L'action manuelle « Liens artificiels vers votre site » frappe la boutique qui reçoit les liens, et SpamBrain neutralise les liens qu'il repère, avec un avantage perdu pour de bon.
Quand utiliser le fichier de désaveu ?
Quand un nombre considérable de liens artificiels pointent vers votre site et qu'ils ont engendré, ou risquent d'engendrer, une action manuelle. Google précise que l'outil n'a pas d'utilité pour la majorité des sites. Demandez d'abord le retrait des liens, puis désavouez par domaine ce qui reste.
Le contenu rédigé avec l'IA est-il du black hat ?
Pas en soi. Google juge la qualité du contenu plutôt que sa méthode de production. L'IA devient du spam quand elle sert à générer de nombreuses pages sans valeur ajoutée pour manipuler le classement, ce que vise la règle du contenu à grande échelle, qui s'applique aussi aux textes écrits par des humains.
Combien de temps pour sortir d'une pénalité Google ?
Pour une action manuelle, Google annonce plusieurs jours, voire plusieurs semaines de traitement de la demande de réexamen, et davantage pour les liens. Pour un déclassement algorithmique, il n'y a pas de demande à envoyer : Google prévient que ses systèmes peuvent mettre plusieurs mois à reconnaître les améliorations.
Le black hat SEO peut-il encore fonctionner ?
À court terme, parfois, le temps que SpamBrain ou un examinateur repère la pratique. Le gain ne dure pas : les liens neutralisés perdent leur avantage, et Google peut prendre des mesures plus larges contre les sites qui multiplient domaines, sous-domaines ou sous-répertoires pour contourner ses règles. Pour un site qui a une marque à protéger, le calcul ne tient pas.
Sources
- Mises à jour pour la lutte contre le spam dans les résultats de recherche Google, Google Search Central
- Mises à jour principales de la recherche Google, Google Search Central
- Règles concernant le spam dans la Recherche sur le Web Google, Google Search Central
- Rapport sur les actions manuelles, Aide Google
- Mise à jour de décembre 2022 contre le spam dans les liens pour la recherche Google, Google Search Central
- Ce que les créateurs Web doivent savoir sur notre mise à jour principale de mars 2024 et les nouvelles règles concernant le spam, Google Search Central
- Conseils de la recherche Google concernant le contenu généré par IA, Google Search Central
- Consignes générales relatives aux données structurées, Google Search Central
- Historique des mises à jour du classement, tableau de bord de l'état de la recherche Google
- Rapport sur les liens, Aide Google
- Désavouer des liens vers votre site, Aide Google
- Rapport sur les problèmes de sécurité, Aide Google
- Outil d'inspection d'URL, Aide Google
- Robots d'exploration communs de Google, Google Search Central
- Valider les requêtes des robots d'exploration et des extracteurs Google, Google Search Central
- Guide des systèmes de classement dans la recherche Google, Google Search Central