




NavBoost est un système de classementPosition d'une page web dans les résultats de recherche pour une requête donnée. de Google qui mémorise les clics des internautes sur les résultats web, requête par requête, sur les 13 derniers mois. Son existence est établie sous serment par Pandu Nayak, vice-président de Google Search, au procès antitrust américain de 2023, et ses compteurs de clics apparaissent dans la documentation interne qui a fuité en mai 2024.
Autour de ces deux sources circulent beaucoup d'affirmations sans preuve : scroll mesuré sur votre page, temps passé dans la page, top 5 trié par NavBoost. Cet article sépare ce qui est prouvé, ce qui est seulement documenté et ce qui relève de l'extrapolation, puis en tire ce qu'un site peut faire de concret.
Ce que la déposition de Pandu Nayak établit
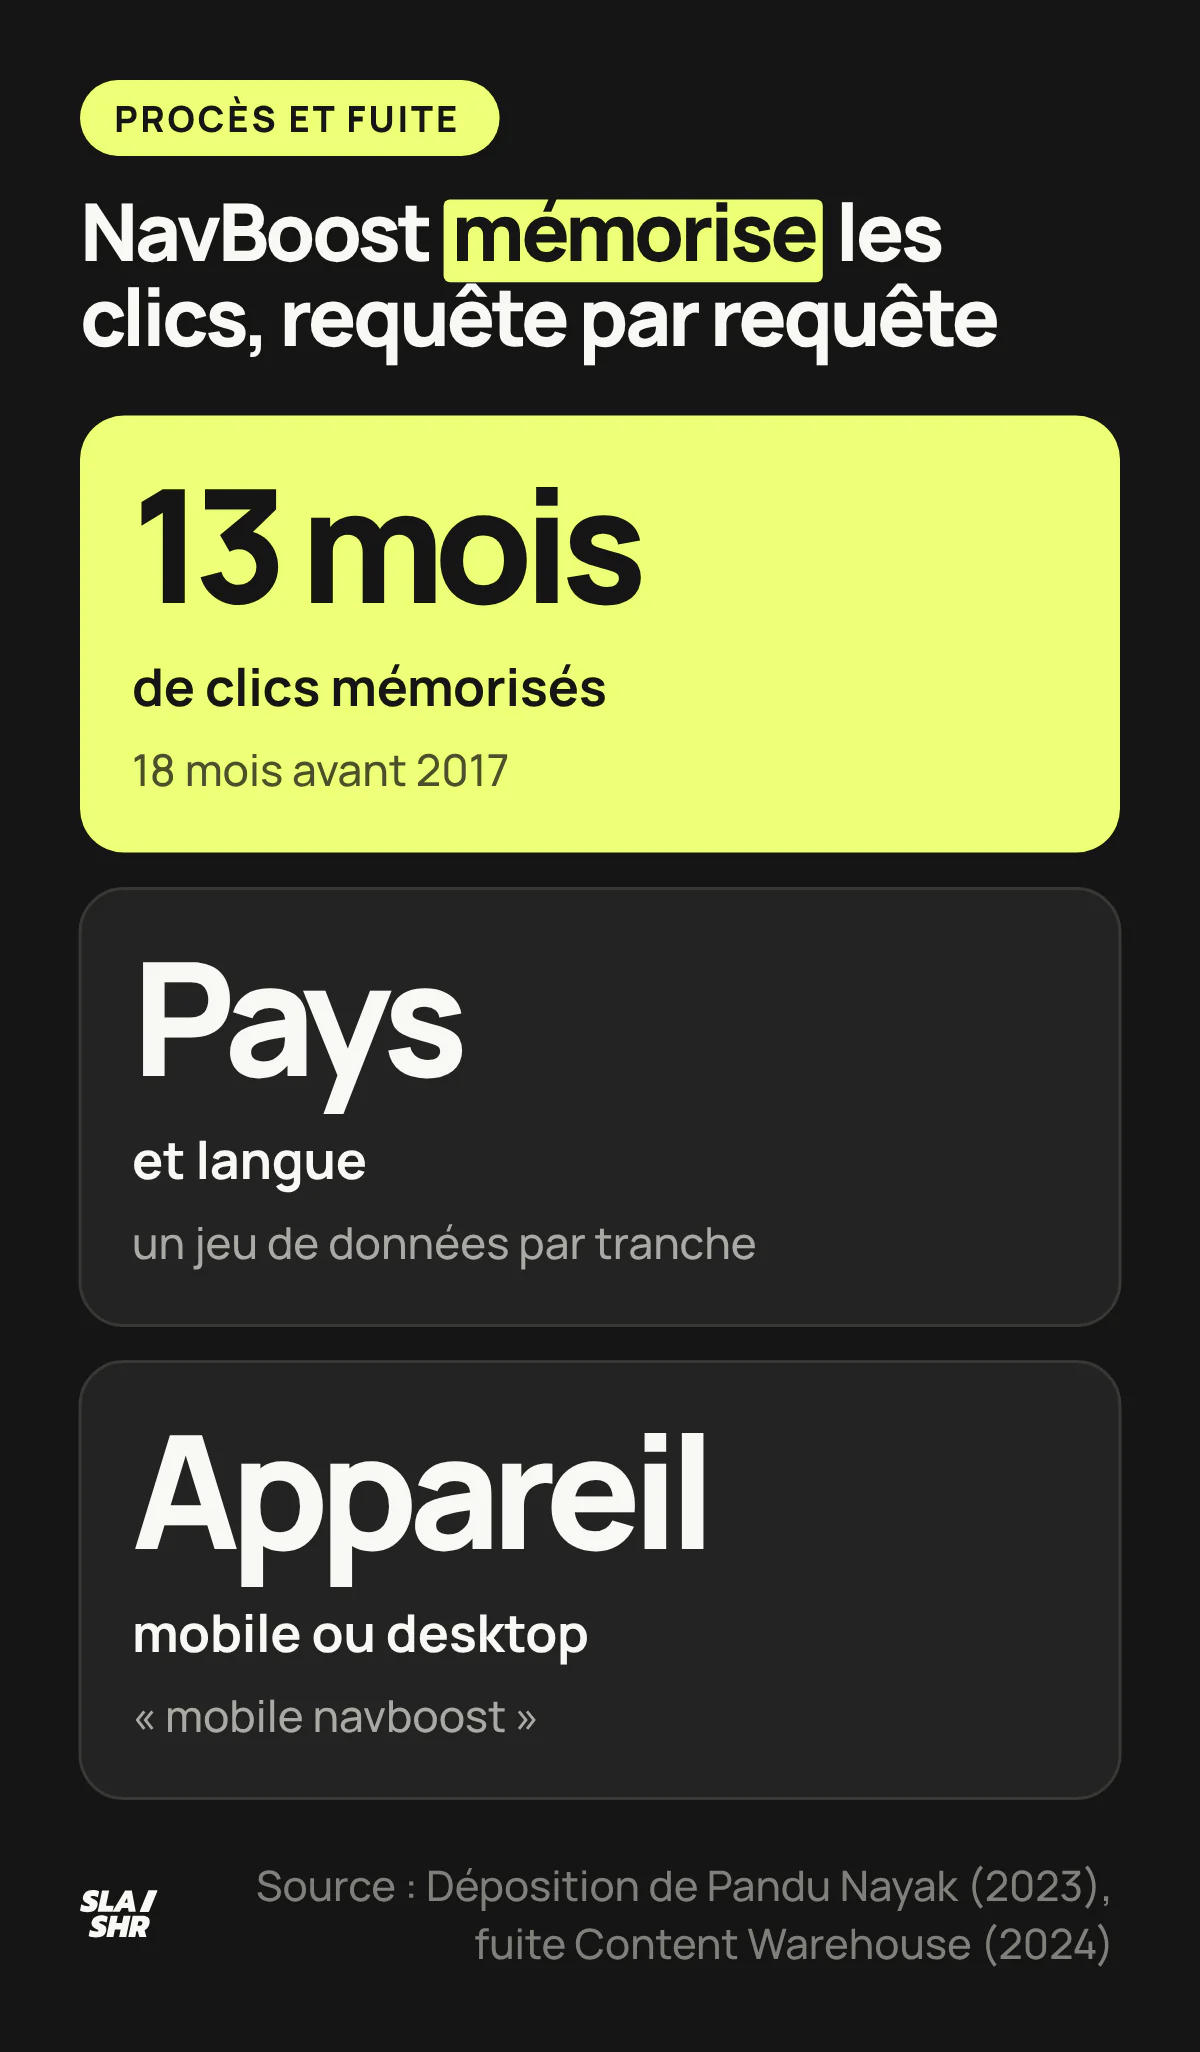
NavBoost mémorise les clics passés sur les requêtes passées, et Google l'entraîne sur 13 mois de données d'utilisateurs. Le 18 octobre 2023, au procès United States v. Google, l'avocat du ministère de la Justice soumet à Pandu Nayak la phrase « the navboost system memorizes past clicks that have been issued for past queries ». Réponse : « Yes ». Même confirmation pour la fenêtre : 13 mois depuis 2017, 18 mois auparavant.
Le système n'est pas neuf. Il remonte à 2005 environ, « It might even be before that », et il a été mis à jour depuis. NavBoost a donc presque l'âge du moteur, dont l'histoire de Google, de BackRub au procès antitrust retrace les étapes.
Le jugement du 5 août 2024 du juge Amit Mehta reprend ces faits. NavBoost y associe requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. et documents en mémorisant les clics : Google se souvient des documents cliqués après une requête et repère un document cliqué sur plusieurs requêtes. Le jugement cite aussi une pièce interne : « Navboost remains one of the most power ranking components historically ».
Au procès, Eric Lehman, ancien ingénieur de Google, présentait NavBoost, comme Glue, sous la forme de « just a giant table », une formule que reprend le jugement de 2025. Une table de comptage, géante : selon l'expert James Allan, cité par ce même jugement, le signal NavBoost compte combien de fois une page a été cliquée en réponse à une requête donnée.
Nayak confirme un deuxième point qui compte pour un site : NavBoost découpe ses données par localité et par mobile ou desktop, en créant un jeu de données distinct pour chaque catégorie. L'exemple vient d'un document interne lu à l'audience : sur « Norton Pub », les utilisateurs desktop cherchaient l'éditeur Norton Publishing, ceux sur mobile un pub, et dans la tranche « mobile navboost » le premier et le troisième résultats les plus cliqués concernaient un pub de Rochester, peu utile hors de cette ville.

La version anglaise de la page Fonctionnement de la recherche le disait déjà en 2021, et la version française l'écrit aujourd'hui : « Nous utilisons également des données d'interaction agrégées et anonymisées pour évaluer la pertinence des résultats de recherche par rapport aux requêtes. » Le procès a ajouté le nom du système, sa durée de mémoire et ses découpages.
Pourquoi si peu de bruit avant 2023 ? Une présentation interne de 2018 versée au dossier donne la consigne : « Do not discuss the use of clicks in search, except on a need-to-know basis ». Google avait sur le sujet une position publique que l'auteur juge lui-même « debatable ».
Où NavBoost intervient dans le classement
NavBoost agit tôt dans le classement : il fait partie des signaux qui réduisent la liste des documents candidats, avant que les systèmes de machine learning ne classent le petit ensemble restant. Nayak décrit la chaîne au juge. L'indexProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. renvoie des dizaines de milliers de documents qui contiennent les mots de la requête, puis un ensemble de signaux les note pour n'en garder que quelques centaines, que la phase suivante classe, notamment avec le machine learning.
Il refuse en revanche d'en faire le seul filtre. À l'avocat qui lui demande si NavBoost ramène la liste à 200 ou 300 documents, il répond : « I wouldn't quite say navboost gets us to 2- to 300, because there might be lots of documents that don't have clicks. » Les autres signaux de cette étape sont nommés : pertinence thématique, PageRankAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne., localisation.

Glue est le deuxième nom à connaître. Selon Nayak, « Glue is just another name for navboost that includes all of the other features on the page » : NavBoost couvre les résultats web, Glue les autres éléments de la page de résultatsSearch Engine Results Page. Page affichée par un moteur de recherche en réponse à une requête utilisateur., plus loin dans la chaîne. Glue fournit un signal parmi d'autres au système Tangram (anciennement Tetris), qui compose la SERP.
Le jugement sur les remèdes du 2 septembre 2025 détaille ce que Glue enregistre : la requête (texte, langue, localisation, appareil), les résultats et les fonctionnalités affichés, et « SERP interaction information, such as clicks, hovers, and duration on the SERP ». Ce jugement impose à Google de partager ces données brutes avec des concurrents qualifiés, sans les modèles ni les signaux qu'il en tire.
Plus largement, le jugement de 2024 décrit les données de clic de Google : « whether the user returns to the SERP and how quickly; how long a user hovers over SERP results; and the user's scrolling patterns on the SERP ». Google voit donc, côté SERP, si l'internaute revient et en combien de temps.
Le jugement de 2025 range aussi « other aspects of a user's journey on and from the SERP » dans les données de Glue, dont NavBoost fait partie. Ce que l'internaute fait dans votre page n'apparaît dans aucune de ces descriptions, et aucun texte ne dit qu'un retour rapide compte comme un mauvais clic.
Une présentation interne de décembre 2016, dans la partie confiée à Eric Lehman, résume la logique : « we watch how people react to documents and memorize their responses ». Elle en donne aussi la limite : l'apprentissage peut échouer, « maybe because a document is new, recently-changed, or rarely-shown ». La présentation ne nomme pas NavBoost : elle décrit l'usage des réactions des internautes par Google en général.
Ce que dit la fuite de mai 2024, et ce qu'elle ne dit pas
La fuite de 2024 confirme que Google stocke des compteurs de clics détaillés pour NavBoost, sans dire comment ils pèsent dans le classement.
Rand Fishkin (SparkToro) a publié l'analyse de cette documentation fin mai 2024 : plus de 2 500Code HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. pages de documentation d'API interne, 14 014 attributs, restées publiques sur GitHub du 27 mars au 7 mai 2024. Google a confirmé leur authenticité à The Verge, tout en mettant en garde contre les « inaccurate assumptions about Search based on out-of-context, outdated, or incomplete information ».
Le module QualityNavboostCrapsCrapsData liste ce que NavBoost compte pour une requête et une URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. :
clicks,impressionsNombre de fois qu'une page apparaît dans les résultats de recherche, qu'elle soit cliquée ou non.,goodClicksetbadClicks, sans définition ;lastLongestClicks, « the number of clicks that were last and longest in related user queries », le dernier clic et le plus long sur des requêtes liées ;- des tranches par pays, langue et appareil, et des sous-ensembles comme « for mobile, US, metro id », où metro désigne une zone métropolitaine ;
- un champ
unscaledIpPriorBadFraction, « a prior based on IP address », repris dans un fichiercraps-penalty.cc, sans préciser de quelle adresse IP il s'agit ; - un nombre minimal d'utilisateurs distincts (
voterTokenCount), « used for privacy-related filtering », donc un filtre de confidentialité ; - des niveaux d'agrégation : l'URL, puis l'hôte, puis le domaine (
patternLevel).

Ce que la documentation ne dit pas compte autant. Fishkin l'écrit lui-même : elle ne montre pas le poids des éléments dans le classement et ne prouve pas lesquels sont utilisés. Ce qui sépare un bon clic d'un mauvais n'est écrit nulle part.
Un champ navDemotion existe dans un autre module, avec pour seule description une conversionAction souhaitée accomplie par un visiteur (achat, inscription, contact). Objectif ultime du SEO. depuis QualityBoost.nav_demoted.boost : son déclencheur est inconnu.
Aucun champ décrit ne mesure le scroll ou le temps passé dans une page de votre site. Ailleurs, des champs dwells portent sur le Knowledge PanelBase de connaissances de Google affichant des informations structurées sur des entités (personnes, entreprises, lieux)., les réponses web et les résultats locaux, pas sur vos pages. Côté résultats web, les indices de durée sont des comptes de clics « longs » : le « longest » de lastLongestClicks et, dans un module ResearchScienceSearchNavboostQueryInfo, « the number of long-clicks on this pair ». Aucun ne dit ce qui rend un clic long. Et la date la plus récente que Fishkin relève dans la documentation est août 2023.
Prouvé, documenté, extrapolé : la grille de lecture
Chaque affirmation sur NavBoost se range dans l'une de trois cases : prouvée au procès, documentée par la fuite sans poids connu, ou extrapolée par des analystes. La grille suivante reprend les affirmations les plus fréquentes, y compris celles de la première version de cet article.
| Affirmation | Statut | Source |
|---|---|---|
| NavBoost mémorise les clics par requête | Prouvé | Nayak, jugement Mehta 2024 |
| 13 mois de données, 18 avant 2017 | Prouvé | Nayak |
| Jeux de données séparés par localité et appareil | Prouvé | Nayak, fuite |
| Il réduit la liste avant le machine learning, avec d'autres signaux | Prouvé | Nayak |
| Glue enregistre clics, survols et durée sur la SERP | Prouvé | Jugement sur les remèdes 2025 |
| Google mesure le retour à la SERP et sa rapidité | Prouvé | Jugements Mehta 2024 et 2025 |
| goodClicks, badClicks, lastLongestClicks | Documenté, sans définition ni poids | Fuite |
| Google filtre les faux clics | Affirmation d'une source anonyme | SparkToro |
| Ce retour rapide = un badClick de NavBoost | Interprétation | Aucune source primaire |
| Recherche de marque qui aide une requête voisine | Affirmation d'une source anonyme | SparkToro |
| Scroll et temps mesurés dans votre page | Non documenté | Aucune |
| NavBoost trie le top 5 | Non documenté | Aucune |

La lecture « un retour rapide à Google = un mauvais clic » est plausible, et elle est partout. Le retour lui-même est mesuré : le jugement de 2024 le range dans les données de clic de Google. Le lien avec NavBoost reste une interprétation, car ni Nayak ni la documentation ne définissent badClicks.
Le même document de 2018, à propos de l'évaluation des tests sur trafic réel, prévient : « The association between observed user behavior and search result quality is tenuous », avec beaucoup de trafic nécessaire pour conclure. Si Google lui-même juge le lien ténu et les exemples isolés difficiles à interpréter, un SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. qui croit le voir sur trois pages a de bonnes raisons de rester prudent.
L'exemple de marque vient de la source anonyme de Fishkin : des internautes qui cherchent « Rand Fishkin », ne trouvent pas SparkToro, tapent « SparkToro » puis cliquent sur le site, et SparkToro.com gagne des places sur la première requête. Notre article sur le branding et le référencement le traite comme un scénario rapporté, sans mesure publiée.
Le cas Beansclub : un pic de clics, pas une preuve
Un pic d'attention soudain peut s'accompagner d'une montée brutale dans Google, mais rien ne permet de l'attribuer à NavBoost seul. Le cas que nous avions relevé en 2025 l'illustre. Le site anti-gaspillage beansclub.fr passe dans l'émission Capital (M6) le 30 mars 2025. Notre relevé SemrushSuite d'outils SEO complète pour l'analyse concurrentielle, les mots-clés et le suivi de positions. d'avril 2025 montre le site autour de la 66e position en mars sur « anti gaspillage » (2 900 recherches mensuelles selon l'estimation de l'outil), puis en 1re position en avril.
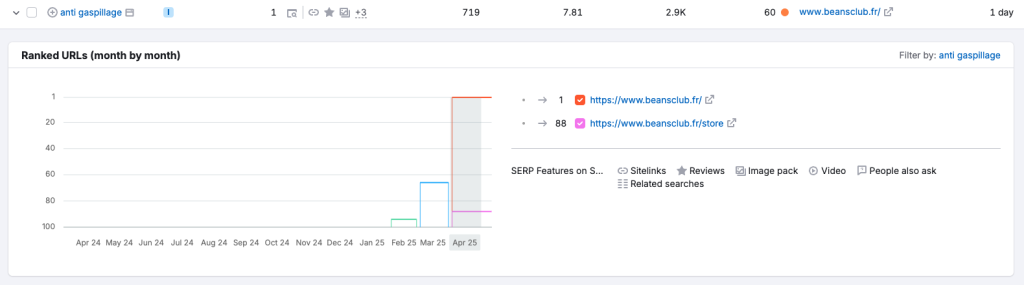
Un passage télé déclenche plusieurs choses à la fois : des recherches sur la marque, des clics, des articles de presse qui citent le site, parfois des liens. Le scénario de Fishkin colle au premier point, les liens au dernier. Un relevé de positions ne sépare pas les deux.

La première version de cet article y voyait la preuve d'un effet NavBoost. C'est une hypothèse compatible avec les sources, rien de plus. Le site ne répondait plus en octobre 2026, ce qui empêche d'en suivre la durée.
Ce que vous pouvez en tirer pour votre site
Les faits établis suffisent à orienter le travail. Chaque action ci-dessous part d'un fait prouvé ; l'extrapolation est signalée.
Commencer par les requêtes où vous apparaissez déjà. NavBoost ne travaille que sur des documents déjà retrouvés dans l'index, Nayak le dit (« you get navboost only after they're retrieved in the first place »), et la présentation de 2016 cite les documents « rarely-shown » parmi les causes possibles d'échec de cet apprentissage. Notre lecture : une page en troisième page de résultats reçoit trop peu de clics pour peser, d'où la priorité aux requêtes en positions 4 à 20 de la Search ConsoleOutil gratuit Google pour surveiller et optimiser la présence d'un site dans les résultats de recherche., là où un meilleur taux de clicClick Through Rate. Pourcentage d'utilisateurs qui cliquent sur un lien par rapport au nombre total d'impressions. a une chance de compter. Notre guide du positionnement sur les moteurs de recherche explique comment les isoler.
Gagner le clic honnêtement. Le clic se gagne sur la page de résultats : un title qui annonce la réponse et une meta description qui tient sa promesse. Promettre plus que la page ne livre est le pari inverse : si les bons et mauvais clics séparent bien ce que l'on suppose (c'est l'extrapolation), un clic déçu vous coûte. Pour savoir si un nouveau modèle de title change vraiment les clics, un A/B test SEO sur deux groupes de pages vaut mieux qu'une impression.

Lire vos données dans les mêmes tranches que NavBoost. La Search Console filtre les clics et impressions par appareil et par pays, deux des découpages confirmés par Nayak et par la fuite. Une page qui performe sur desktop et décroche sur mobile mérite un diagnostic à part, d'autant que l'intention peut différer d'un appareil à l'autre, comme sur « Norton Pub ».
Répondre à l'intention dès le haut de page. lastLongestClicks compte le dernier clic et le plus long d'une série de requêtes liées. Une page qui met fin à la recherche a de bonnes chances d'être ce clic-là. C'est notre lecture du nom du champ : Google n'a publié aucune règle à ce sujet. Une réponse visible tout de suite et un maillage interne qui mène à la suite logique servent le lecteur dans tous les cas. Les mesures de GA4Outil gratuit Google pour analyser le trafic et le comportement des visiteurs d'un site. ou de Clarity renseignent l'expérience sur votre page ; aucune source ne dit que Google s'en sert.
Ne pas acheter de clics. Aucune source ne publie l'effet de faux clics sur NavBoost. La source de SparkToro affirme que Google combat le spamTechniques manipulatrices visant à tromper les moteurs de recherche. de clics avec l'historique des cookies, les données de Chrome et la détection de motifs, et la fuite contient un a priori par adresse IP dont l'usage n'est pas décrit. Acheter des clics, c'est payer pour un pari dont personne ne publie les règles.
Reste le cas des AI Overviews. Le jugement de 2025 relève des éléments selon lesquels les AI Overviews « reduced user interactions with organic web results ».
Une partie des recherches se termine sans clic, ce qui laisse moins de clics à compter sur ces requêtes : c'est l'effet crocodile, des impressions qui montent et des clics qui baissent. Glue enregistre les interactions avec les fonctionnalités de la page de résultats, mais aucune source primaire ne dit comment les AI Overviews entrent dans ces données. Toute affirmation sur leur effet sur NavBoost relève de la spéculation.
Si vous voulez travailler vos titles, vos pages et votre visibilité sur Google comme dans les IA à partir de vos vraies données, notre agence SEO peut vous accompagner.
Questions fréquentes
NavBoost est-il un facteur de classement officiel ?
Google ne le cite pas dans son guide des systèmes de classement, mais Pandu Nayak a confirmé sous serment qu'il s'agit d'un des systèmes de base du classement, et une pièce interne le décrit comme « one of the most power ranking components historically ». Google reconnaît publiquement utiliser des données d'interaction agrégées et anonymisées pour évaluer la pertinence.
Le taux de clic est-il un facteur de classement direct ?
Aucune source ne dit que le CTR brut entre tel quel dans une formule. NavBoost compte des clics, des impressions, des bons et des mauvais clics par requête et par URL, et il aide à trier les candidats parmi d'autres signaux. Le poids de chaque compteur reste inconnu.
Quelle différence entre NavBoost et Glue ?
NavBoost traite les résultats web, Glue tout le reste de la page de résultats (images, cartes, questions associées, etc.). Selon Nayak, Glue est « just another name for navboost » étendu à ces éléments. Ses données incluent celles de NavBoost, et aussi les survols et la durée sur la SERP.
NavBoost utilise-t-il les données de Chrome ?
Aucune source primaire ne dit que NavBoost utilise des données de Chrome. Le jugement de 2025 mentionne un signal de popularité qui « uses Chrome data », que les plaignants rattachaient à des systèmes « including Navboost/Glue » et sur lequel le juge dit ne pouvoir en dire plus, et la source de SparkToro affirme que Google se sert des données de Chrome contre les faux clics, sans document public à l'appui. La fuite contient un champ chromeInTotal, décrit comme « Site-level Chrome views », rangé dans un module de qualité de site, à l'écart des modules NavBoost.
Peut-on manipuler NavBoost avec de faux clics ?
Aucune source primaire ne mesure l'effet de faux clics sur NavBoost. La source de SparkToro affirme que Google combat le spam de clics avec l'historique des cookies, les données de Chrome et la détection de motifs, sans document public à l'appui. La documentation contient un a priori calculé par adresse IP (unscaledIpPriorBadFraction), sans dire de quelle adresse il s'agit ni à quoi il sert. Acheter des clics revient à parier contre des filtresSystème de filtres (taille, couleur, prix) générant de nombreuses URLs. Nécessite une gestion SEO. dont le réglage n'est pas public.
Sources
- Fonctionnement de la recherche : classement des résultats, Google
- An Anonymous Source Shared Thousands of Leaked Google Search API Documents with Me, SparkToro (Rand Fishkin), mai 2024
- Guide des systèmes de classement de la recherche Google, Google Search Central
- Transcription du procès United States v. Google, 18 octobre 2023 (après-midi), déposition de Pandu Nayak, The Capitol Forum (copie de la transcription d'audience) : thecapitolforum.com/wp-content/uploads/2023/10/101823-USA-v-Google-PM.pdf
- United States v. Google LLC, Memorandum Opinion (ECF 1033), 5 août 2024, Tribunal fédéral du district de Columbia, juge Amit P. Mehta (copie CourtListener) : storage.courtlistener.com/recap/gov.uscourts.dcd.223205/gov.uscourts.dcd.223205.1033.0.pdf
- United States v. Google LLC, Memorandum Opinion sur les remèdes (ECF 1436), 2 septembre 2025, Tribunal fédéral du district de Columbia, juge Amit P. Mehta (copie CourtListener) : storage.courtlistener.com/recap/gov.uscourts.dcd.223205/gov.uscourts.dcd.223205.1436.0.pdf
- Pièce UPX0203, présentation Google « Q4 Search All Hands » (8 décembre 2016), Département de la Justice des États-Unis, pièces du procès : justice.gov/d9/2023-11/417516.pdf
- Pièce UPX0204, présentation Google « Ranking for Research » (16 novembre 2018), Département de la Justice des États-Unis, pièces du procès : justice.gov/atr/media/1316761/dl?inline
- Rapport sur les performances (Search Console), Aide Search Console
- Google confirms the leaked Search documents are real, The Verge, 29 mai 2024 : theverge.com/2024/5/29/24167407/google-search-algorithm-documents-leak-confirmation
- Documentation Content Warehouse v0.4.0, module QualityNavboostCrapsCrapsData, HexDocs (documentation fuitée, copie publique) : google-api-content-warehouse.hexdocs.pm/0.4.0/GoogleApi.ContentWarehouse.V1.Model.QualityNavboostCrapsCrapsData.html
- Documentation Content Warehouse v0.4.0, module CompressedQualitySignals, HexDocs (documentation fuitée, copie publique) : google-api-content-warehouse.hexdocs.pm/0.4.0/GoogleApi.ContentWarehouse.V1.Model.CompressedQualitySignals.html
- Documentation Content Warehouse v0.4.0, module QualityNsrNsrData, HexDocs (documentation fuitée, copie publique) : google-api-content-warehouse.hexdocs.pm/0.4.0/GoogleApi.ContentWarehouse.V1.Model.QualityNsrNsrData.html
- Beans, page Presse (archive Wayback Machine du 22/06/2025), Beans (beansclub.fr) :
web.archive.org/web/20250622001522/httpsProtocole sécurisé de transfert de données. Facteur de ranking depuis 2014.://www.beansclub.fr/press - How Search works : ranking results (archive Wayback du 23/08/2021) :
web.archive.org/web/20210823235351/https://www.google.com/search/howsearchworks/how-search-works/ranking-results/ - Documentation Content Warehouse v0.4.0, module ResearchScienceSearchNavboostQueryInfo, HexDocs (documentation fuitée, copie publique) : google-api-content-warehouse.hexdocs.pm/0.4.0/GoogleApi.ContentWarehouse.V1.Model.ResearchScienceSearchNavboostQueryInfo.html