




llms.txt est un fichier Markdown, placé à la racine d'un site, qui donne aux agents IA un sommaire du site et des liens vers des versions propres de ses pages. En octobre 2026, il sert surtout aux agents de code qui lisent une documentation technique. Pour la visibilité dans Google ou dans les moteurs IA, aucune plateforme ne dit s'en servir, et Google écrit qu'il l'ignore.
Cet article date de mai 2025 et a été refondu en octobre 2026. Entre-temps, la proposition est passée en version 2, AhrefsOutil SEO payant spécialisé dans l'analyse des backlinks et la recherche de mots-clés. a mesuré qui demande vraiment ces fichiers sur 137 000 domaines, et Google a écrit dans son guide sur l'IA générative que sa recherche les ignore. Vous gérez un site et vous vous demandez s'il faut en publier un : voici ce que disent les sources, et la grille pour décider.
Qu'est-ce que le fichier llms.txt ?
llms.txt est une proposition de format pour donner aux modèles de langage un point d'entrée lisible dans un site. Jeremy Howard l'a publiée le 3 septembre 2024 ; le texte reste informel, ouvert aux contributions sur le dépôt GitHub d'Answer.AI, sans organisme de normalisation derrière.
Le constat de départ tient en deux lignes. Une page HTML enrobe son contenu de navigation, de publicités et de JavaScript, et la ramener à du texte propre coûte cher à un agent. Un fichier court, en Markdown, qui pointe vers l'essentiel lui fait gagner du temps et des tokens.
Le fichier s'appelle llms.txt et se place à la racine (/llms.txt) ou dans un sous-dossier : /docs/llms.txt couvre alors les pages de /docs/. Il suit un ordre précis :
- un titre H1 avec le nom du site ou du projet ;
- une citation (blockquote) qui résume le projet ;
- des paragraphes d'explication, sans intertitre ;
- des sections H2 qui listent des liens, chacun suivi d'une courte note ;
- par convention, une section « Optional » pour les liens qu'un agent peut sauter.
Seul le titre H1 est obligatoire.
Voici à quoi ressemble le fichier d'un éditeur de logiciel (exemple fictif) :
# Votre Logiciel

> API de facturation pour e-commerçants : factures, relances, export comptable.

La documentation couvre la version 3 de l'API. Exemples en Python et JavaScript.

## Documentation

- [Démarrage rapide](/docs/demarrage.md): créer une clé, émettre une facture
- [Référence de l'API](/docs/api.md): points d'accès et paramètres

## Exemples

- [Relance automatique](/docs/exemples/relance.md): relancer un impayé à J+15

## Optional

- [Historique des versions](/changelog.md)
La version 2, publiée en août 2026, précise surtout comment trouver ces fichiers. Chaque page utile peut avoir une version Markdown à la même adresse : page.html.md, déjà prévu en version 1, ou désormais page.md. Un agent retrouve ces fichiers par des relations standard : rel="alternate" type="text/markdown" pour la version Markdown d'une page, rel="describedby" pour le llms.txt qui la couvre, en balise <link> ou en en-tête HTTP Link.

llms.txt, robots.txt et sitemap.xml : trois fichiers, trois rôles
robots.txt dit aux robots ce qu'ils ont le droit d'explorer, le sitemap liste les pages à indexer, llms.txt propose à un agent une sélection commentée de pages à lire. Des trois, seul robots.txt contrôle quelque chose.
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| Rôle | autoriser ou interdire l'exploration | lister les URL à indexer | proposer une sélection commentée à lire |
| Lecteurs | robots d'exploration (Googlebot, GPTBot, ClaudeBot) | moteurs de recherche | agents IA |
| Moment de lecture | avant d'explorer | à l'exploration | à la demande, quand un agent cherche une information pour quelqu'un |
| Contrôle l'accès | oui | non | non |
| Format | directives texte | XML | Markdown |
La proposition elle-même pose cette différence : robots.txt indique aux outils automatiques quel accès au site est acceptable, llms.txt sert à la demande, quand un agent a besoin d'une information pour aider un utilisateur. Un Disallow se règle donc toujours dans votre fichier robots.txt, et la liste exhaustive des URLUniform Resource Locator. Adresse unique d'une page web. Une URL optimisée est courte, descriptive et contient le mot-clé. reste le travail du sitemap XML. Un llms.txt n'a ni l'un ni l'autre pouvoir.

Vous croiserez aussi llms-full.txt : un seul fichier qui contient toute une documentation en Markdown, que l'agent charge d'un coup. La proposition ne le décrit pas : il vient de plateformes de documentation comme Mintlify, et Anthropic, OpenAI et PerplexityMoteur de recherche conversationnel basé sur l'IA, concurrent émergent de Google. en publient un pour leur documentation développeurs.
Ce que disent Google, OpenAI, Anthropic et Perplexity en octobre 2026
Aucune des quatre plateformes ne dit utiliser le llms.txt d'un site pour ses réponses, et toutes en publient un pour leur propre documentation développeurs. Chaque constat ci-dessous vient de leur documentation officielle, à la date indiquée.
Google est le seul à l'écrire noir sur blanc. Son guide d'optimisation pour l'IA générative (version française du 13 juillet 2026) range les fichiers llms.txt parmi ce que vous pouvez ignorer : la recherche Google ne les utilise pas, fonctionnalités d'IA comprises.
Il prAlgorithme historique de Google évaluant l'importance d'une page selon ses backlinks. Toujours utilisé en interne.écise que vous pouvez en tenir un pour d'autres services, et que « cela n'aura aucune incidence sur la visibilité ou le classementPosition d'une page web dans les résultats de recherche pour une requête donnée. de votre site dans la recherche Google ». La page Fonctionnalités d'IA et votre site Web le dit aussi pour les Aperçus IA et le Mode IA : aucun fichier textuel d'IA n'est nécessaire pour y apparaître, comme nous le détaillons dans notre article sur les Aperçus IA de Google.
Le même Google envoie un autre signal. La documentation de LighthouseOutil open-source Google auditant performance, accessibilité, SEO et bonnes pratiques d'une page., l'outil d'audit de Chrome, décrit un audit llms.txt dans ses contrôles de navigation agentique (page mise à jour le 5 mai 2026). Il ne signale qu'une erreur serveurCode HTTP indiquant une erreur côté serveur. Impacte négativement le crawl et l'expérience utilisateur. : un fichier absent (404Code HTTP indiquant qu'une page n'existe pas. Trop d'erreurs 404 nuisent au crawl budget.) rend l'audit « non applicable », le fichier étant « optionnel pour le moment ».
Interrogé sur ce double discours, John Mueller a répondu que llms.txt n'est « pas fait pour la recherche » : une béquille temporaire pour les outils de code qui lisent de la documentation, selon ses propos rapportés par Ahrefs en juin 2026.
OpenAI règle ses robots d'explorationProcessus par lequel les robots des moteurs de recherche parcourent et analysent les pages web. par robots.txtFichier texte à la racine d'un site indiquant aux robots quelles pages explorer ou ignorer.. Sa page sur ses robots (relevée le 13 octobre 2026) distingue OAI-SearchBot, qui fait apparaître les sites dans la recherche de ChatGPTAgent conversationnel d'OpenAI utilisant un LLM pour générer des réponses., et GPTBot, qui collecte du contenu pour l'entraînement. Elle ne parle pas de llms.txt pour les éditeurs de sites. La même page renvoie pourtant, en tête, vers le llms.txt de la documentation OpenAI et vers les versions .md de ses pages.
Anthropic suit la même ligne. Son article d'aide sur ses robots, mis à jour le 7 avril 2026, décrit ClaudeBot (entraînement), Claude-SearchBot (recherche) et Claude-User (récupération à la demande), tous réglables par robots.txt, sans un mot sur llms.txt. Côté développeurs, Anthropic publie un llms.txt et un llms-full.txt pour la documentation de sa plateforme et pour celle de Claude Code.
Perplexity aussi. Sa page sur ses robots (relevée le 13 octobre 2026) présente PerplexityBot, qui se règle par robots.txt, et Perplexity-User, qui ignore en général ces règles puisqu'il agit à la demande d'un utilisateur. Rien sur llms.txt. Les pages de sa documentation développeurs s'ouvrent pourtant sur une consigne aux agents : récupérer l'indexProcessus par lequel Google ajoute une page à sa base de données pour qu'elle puisse apparaître dans les résultats. complet dans son llms.txt.
| Plateforme | Pour votre site | Pour sa propre documentation |
|---|---|---|
| la recherche ignore llms.txt, sans effet sur le classement (guide du 13/07/2026) ; Lighthouse vérifie le fichier s'il existe | llms.txt de la documentation de l'API GeminiIA multimodale de Google, intégrée progressivement à ses produits dont la recherche. | |
| OpenAI | robots.txt pour OAI-SearchBot et GPTBot, llms.txt non mentionné (13/10/2026) | llms.txt, llms-full.txt et pages en .md |
| Anthropic | robots.txt pour ClaudeBot, Claude-SearchBot et Claude-User, llms.txt non mentionné (7/04/2026) | llms.txt et llms-full.txt (plateforme, Claude Code) |
| Perplexity | robots.txt pour PerplexityBot (Perplexity-User l'ignore en général), llms.txt non mentionné (13/10/2026) | llms.txt annoncé en tête de chaque page de doc |

Pour régler l'accès de ces robots, distinguer ceux d'entraînement, de recherche et de récupération à la demande, et vérifier ce que votre CDNContent Delivery Network. Réseau de serveurs distribuant le contenu depuis le serveur le plus proche de l'utilisateur. laisse passer, la grille de notre audit technique GEO part de cette taxonomie.
Ce que montrent les données : presque personne ne le demande
Les études publiées depuis fin 2025 convergent : le fichier se répand, il est très peu demandé, et aucune ne mesure à ce jour d'effet sur les citations.
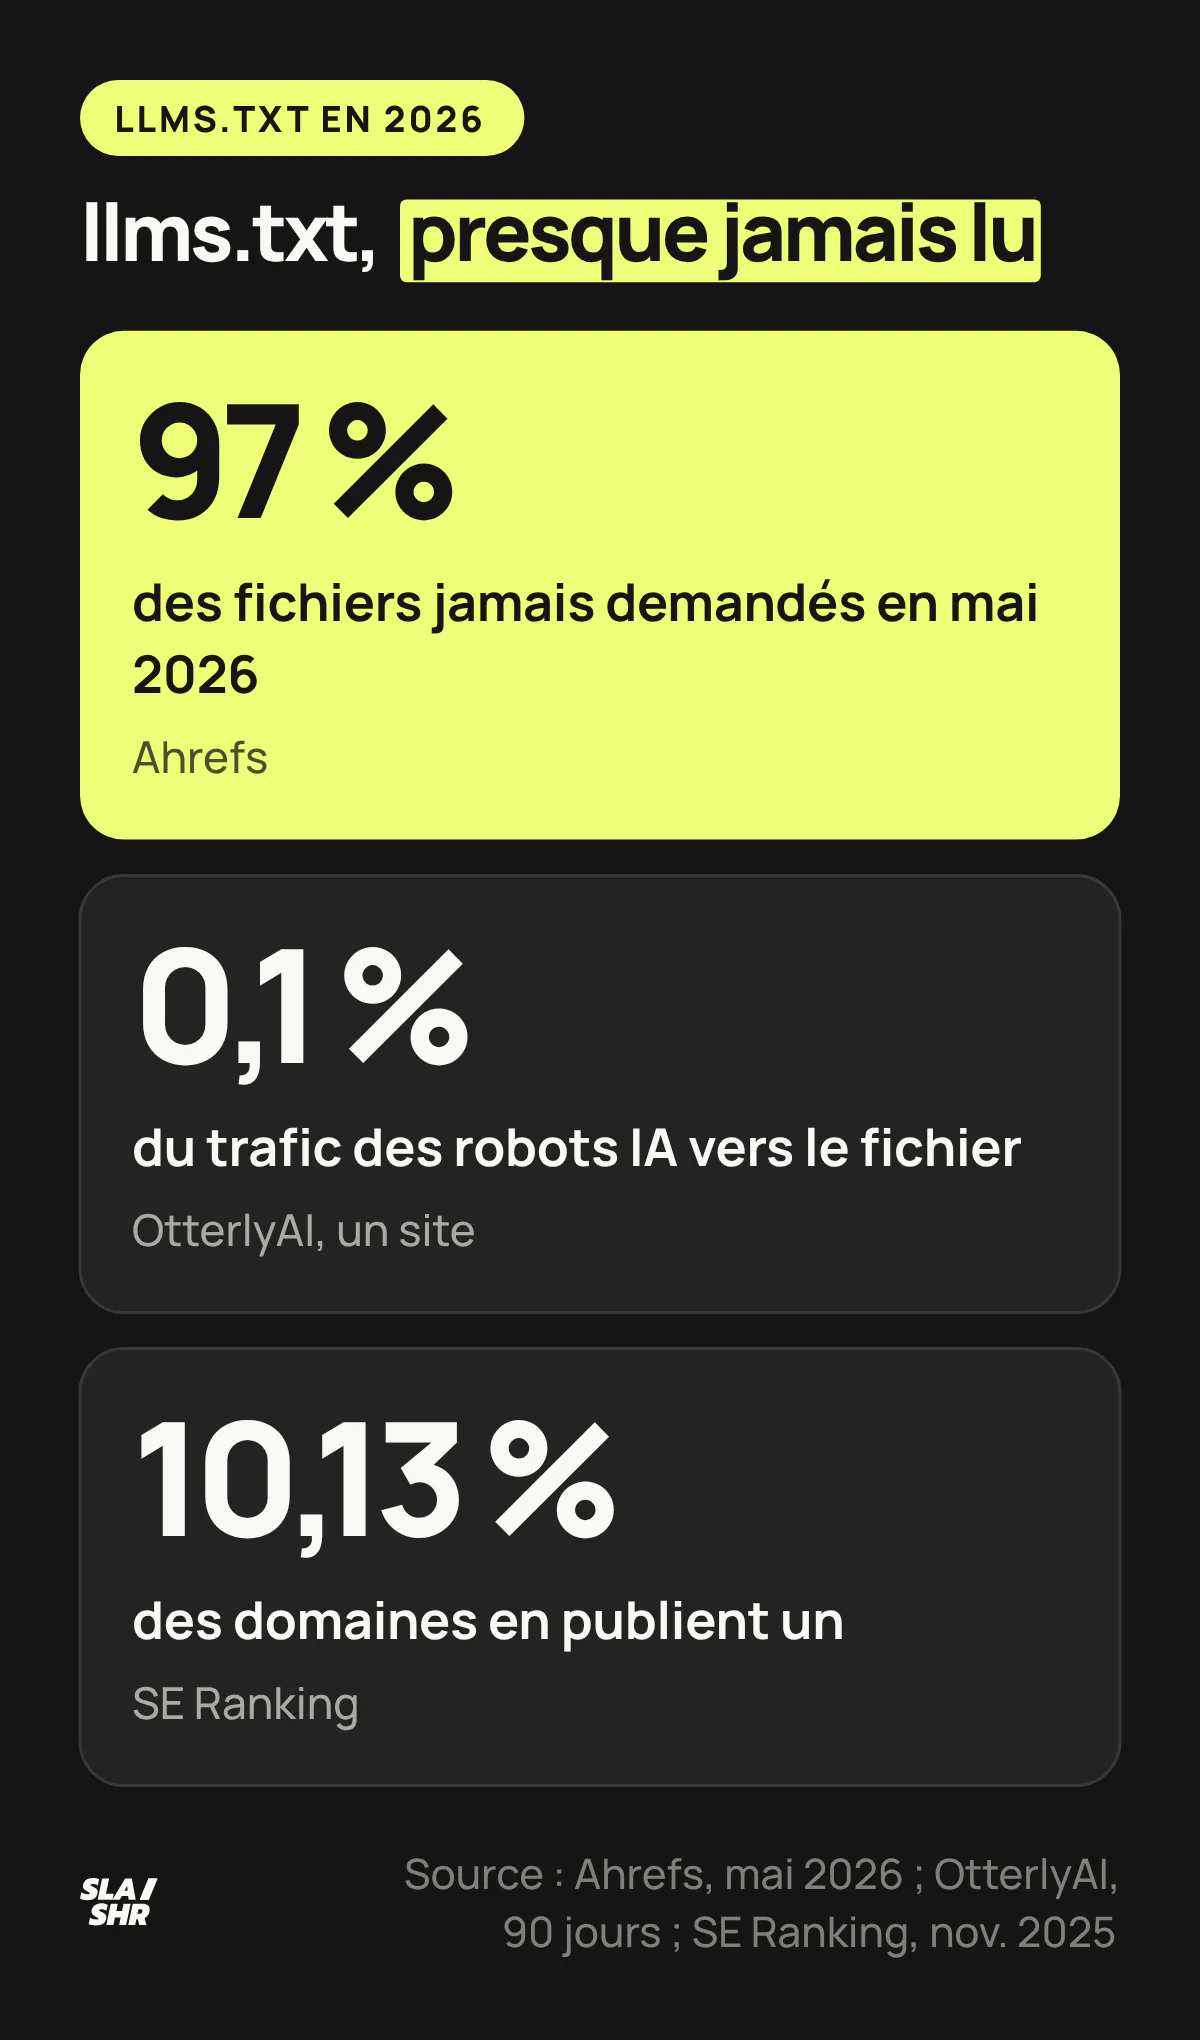
L'adoption progresse. Sur près de 300 000 domaines, SE Ranking comptait 10,13 % de sites équipés en novembre 2025, avec peu d'écart selon le trafic (9,88 % pour les petits sites, 8,27 % pour les plus gros). En juin 2026, Ahrefs trouve un llms.txt sur 28 % des 137 210 domaines suivis par son outil Web AnalyticsOutil gratuit Google pour analyser le trafic et le comportement des visiteurs d'un site., un chiffre qu'il présente lui-même comme une borne haute : ses clients sont plus techniques que la moyenne du web.
Aucun effet mesuré sur les citations. Toujours chez SE Ranking, ni l'analyse statistique ni le modèle d'apprentissage ne montrent d'effet du fichier sur la fréquence à laquelle un domaine est cité par les LLMLarge Language Model. Modèles d'IA comme GPT ou Gemini capables de générer du texte.. Retirer la variable llms.txt de leur modèle XGBoost en a même amélioré la précision.
Le fichier est à peine lu. OtterlyAI a suivi un site d'expérience pendant 90 jours : sur plus de 62 100 visites de robots IA, 84 visaient /llms.txt, soit environ 0,1 %, quand une page de contenu moyenne en recevait environ 265. L'étude Ahrefs change d'échelle :
- 97 % des quelque 38 000 llms.txt valides n'ont reçu aucune requête en mai 2026, ni robot ni humain ;
- sur les requêtesTerme ou expression que les utilisateurs saisissent dans un moteur de recherche. Base de toute stratégie SEO. restantes, 96 % venaient de robots, et les robots de recherche des moteurs IA (OAI-SearchBot, PerplexityBot) n'en pesaient que 1,1 % ;
- Slackbot, qui génère les aperçus de liens dans une messagerie, a demandé ces fichiers plus souvent que PerplexityBot ;
- aucun robot IA n'a demandé un llms.txt qui n'existait pas. Ils ne vont pas le chercher.

Nous avons fait la vérification sur agence-slashr.fr, qui ne publie pas de llms.txt. Sur 17 h 30 de journal serveur, les 12 et 13 octobre 2026, les robots d'IA déclarés (GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot et leurs cousins) ont envoyé 374 requêtes : aucune ne visait /llms.txt. Les deux seules demandes extérieures du fichier venaient de l'audit Lighthouse. Moins d'une journée de journal ne suffit pas à conclure, mais elle rejoint le constat d'Ahrefs : aucun robot d'IA n'est venu chercher le fichier absent.
Une réserve de méthode s'applique à tous ces chiffres : une requête mesure un fichier récupéré, et rien ne dit ce que le robot en fait ensuite. Ahrefs présente donc ses chiffres comme un plafond de la lecture réelle. Ces mesures datent aussi : une plateforme peut se mettre à lire le fichier demain. En octobre 2026, aucune ne l'annonce.
Le vrai usage : la documentation lue par les agents de code
llms.txt sert quand un agent de code doit lire une documentation technique : c'est l'usage que décrit la proposition et celui que mesurent les journaux.
La proposition le dit sans détour : les fichiers llms.txt sont surtout utilisés pour la documentation logicielle, où les agents de code les suivent pour trouver les références d'API et les tutoriels. L'agent lit l'index, choisit le lien utile, charge la page en Markdown et répond, sans avaler la navigation ni le JavaScriptLangage de programmation web. Son mauvais usage peut bloquer l'indexation par les moteurs de recherche. d'une page HTML.
Les journaux d'Ahrefs collent à ce scénario. Les agents IA et leur infrastructure envoient 10,5 % des requêtes vers les llms.txt, plus que tout autre type de robot IA. Claude Code, l'agent de code d'Anthropic, en a récupéré plus que n'importe quel robot de recherche ou assistant IA. C'est le cas d'usage que décrivait John Mueller : un raccourci pour économiser des tokens quand un outil de code lit une documentation.

D'où la liste des sites qui en publient en premier : éditeurs de logiciels, d'API et de bibliothèques. Les plateformes de documentation comme Mintlify ou GitBook le génèrent automatiquement. Côté CMS, la proposition cite Yoast SEOSearch Engine Optimization. Ensemble des techniques visant à améliorer le positionnement d'un site web dans les résultats naturels des moteurs de recherche. et AIOSEO sur WordPress, et Wix, qui en génère un pour chaque site. Sur WordPress, notre comparatif des extensions SEO pour WordPress précise que la version gratuite de Yoast gère ce fichier.
Faut-il créer un llms.txt ? La grille selon votre site
Oui si des développeurs lisent votre documentation avec un agent. Pour un site e-commerce, un site vitrine ou un média, le fichier n'apporte rien de mesurable aujourd'hui, et le laisser générer par votre CMS suffit.

Vous éditez un logiciel, une API ou une bibliothèque. Publiez-le, avec les versions .md des pages de documentation, et générez-le depuis la doc pour qu'il ne se périme pas. La proposition donne un test simple : posez des questions à un agent en ne lui fournissant que votre llms.txt, et regardez s'il trouve la bonne page.
Votre CMS le génère déjà (Wix, Yoast SEO, AIOSEO). Laissez-le, il ne coûte rien. Ouvrez-le une fois : il doit lister des pages publiques et à jour, et décrire votre offre comme vos pages la décrivent.
Vous gérez un site e-commerce, un site vitrine, un réseau de magasins ou un média. Ne mobilisez pas un développeur pour ce fichier. Google dit qu'il n'aura aucun effet sur votre classement, et aucune étude ne montre à ce jour d'effet sur les citations dans les moteurs IA.
Le temps gagné va à ce qui décide de votre présence dans les réponses des IA :
- laisser passer les robots de recherche des assistants (OAI-SearchBot, Claude-SearchBot, PerplexityBot) dans robots.txt et dans le réglage du CDN ;
- servir le contenu dans le HTML, sans attendre l'exécution du JavaScript, ce que permet le rendu côté serveur, puis le contrôler en comparant le HTML brut et la page rendue ;
- couvrir les sous-questions que les moteurs génèrent à partir d'une requête, le principe du query fan-out ;
- vérifier dans vos journaux qui passe vraiment, avec la méthode de notre guide d'analyse de logs GEO.
C'est le cœur du GEO, l'optimisation pour les moteurs génératifs, et le travail d'une agence GEO : l'accès des robots, la lisibilité des pages et la qualité des réponses, bien avant un fichier texte qu'aucun moteur ne s'engage à lire.
Questions fréquentes
Le fichier llms.txt améliore-t-il le référencement Google ?
Non. Google écrit que sa recherche, fonctionnalités d'IA comprises, n'utilise pas les fichiers llms.txt, et que publier le vôtre n'a aucune incidence sur votre visibilité ou votre classement. Vous pouvez le garder pour d'autres services sans risque pour votre SEO.
ChatGPT, Claude ou Perplexity lisent-ils le llms.txt de mon site ?
Aucune de leurs documentations ne le dit. OpenAI, Anthropic et Perplexity règlent leurs robots d'exploration par robots.txt, sans un mot sur llms.txt. Dans l'étude Ahrefs de juin 2026, les robots de recherche des moteurs IA pèsent 1,1 % des requêtes reçues par les llms.txt, et aucune étude publiée ne mesure à ce jour d'effet du fichier sur les citations.
Quelle différence entre llms.txt et llms-full.txt ?
llms.txt est un sommaire : quelques liens commentés vers des pages en Markdown. llms-full.txt rassemble toute la documentation dans un seul fichier, que l'agent charge d'un coup. Le second vient des plateformes de documentation comme Mintlify ; la proposition llms.txt ne le décrit pas.
Un llms.txt peut-il empêcher les IA d'entraîner leurs modèles sur mon contenu ?
Non, il ne contrôle aucun accès. Le refus passe par robots.txt : un Disallow pour GPTBot signale que votre contenu ne doit pas servir à l'entraînement des modèles d'OpenAI, et un Disallow pour ClaudeBot qu'Anthropic doit exclure vos contenus à venir de ses données d'entraînement.
Sources
- Guide Google pour optimiser les fonctionnalités d'IA générative dans la recherche Google, Google Search Central
- Fonctionnalités d'IA et votre site Web, Google Search Central
- Overview of OpenAI Crawlers
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Claude Help Center
- Perplexity Crawlers
- The /llms.txt file, v2 : llmstxt.org/
- Changes : llmstxt.org/changes.html
- llms.txt : mintlify.com/docs/ai/llmstxt
- Anthropic Developer Documentation - Full Content (llms-full.txt)
- llms.txt (Lighthouse, agentic browsing audits), Chrome for Developers : developer.chrome.com/docs/lighthouse/agentic-browsing/llms-txt
- We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read, Ahrefs
- Anthropic Developer Documentation (llms.txt)
- Gemini API (llms.txt), Google AI for Developers : ai.google.dev/gemini-api/docs/llms.txt
- LLMs.txt: Why Brands Rely On It and Why It Doesn't Work, SE Ranking
- Llms.txt Experiment: What Marketers Get Wrong about llms.txt (5 février 2026), OtterlyAI : otterly.ai/blog/the-llms-txt-experiment/
- llms.txt, Yoast